PL/SQL에서 행마다 COMMIT했더니 log file sync가 0회였던 이유
루프 안에서 바꾼 것은 COMMIT 한 줄이었습니다
IF p_interval > 0 AND MOD(i, p_interval) = 0 THEN
  IF p_wait = 'Y' THEN
    COMMIT WRITE IMMEDIATE WAIT;
  ELSE
    COMMIT;
  END IF;
END IF;
행마다 COMMIT을 넣은 PL/SQL 루프를 돌린 뒤 가장 먼저 V$SESSION_EVENT를 확인했습니다. 커밋을 2만 번 했으니 log file sync도 그만큼 쌓여 있을 거라고 예상했습니다. 그런데 프로시저가 기록한 대기 횟수는 0이었습니다. 같은 루프에서 COMMIT을 COMMIT WRITE IMMEDIATE WAIT로만 바꾸자, 그제야 커밋 수에 가까운 대기가 잡혔습니다.
행별 커밋이 느린 이유로 먼저 떠올리는 것은 커밋마다 생기는 log file sync입니다. 그런데 2만 번 커밋하고도 대기가 0이었다면 그 설명만으로는 부족합니다. 커밋 간격별로 소요 시간, 대기, redo를 함께 재서 늘어난 시간이 어디서 나왔는지 따라갔습니다.
포인트 적립 원장 20,000건, 커밋 방식만 다섯 가지
테스트 테이블은 포인트 적립 업무를 가정한 가상의 원장 POINT_EARN_LEDGER입니다. 기본키 하나와 컬럼 여섯 개로 된 단순한 구조입니다. 건수는 20,000건으로, 이 정도면 커밋 간격별 차이가 시간과 redo에 뚜렷하게 드러납니다. INSERT 문은 모든 케이스에서 같고, 커밋 위치와 방식만 달랐습니다.
| 케이스 | 커밋 방식 | 커밋 횟수 |
|---|---|---|
| A_END | 20,000건을 넣은 뒤 한 번 | 1 |
| B_EVERY1000 | 1,000건마다 COMMIT | 20 |
| C_EVERY100 | 100건마다 COMMIT | 200 |
| D_EVERYROW | 행마다 COMMIT | 20,000 |
| E_ROW_WAIT | 행마다 COMMIT WRITE IMMEDIATE WAIT | 20,000 |
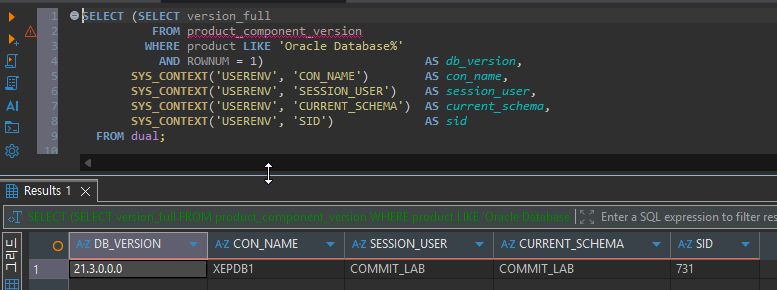
실행 환경은 SSD를 쓰는 개인 PC에 설치한 Oracle Database 21c XE이고, DBeaver로 XEPDB1에 접속했습니다. COMMIT_LAB 연결은 수동 커밋 모드로 두었습니다. 자동 커밋을 켜 두면 DBeaver가 보내는 커밋이 호출 끝의 대기 횟수에 섞이기 때문입니다.
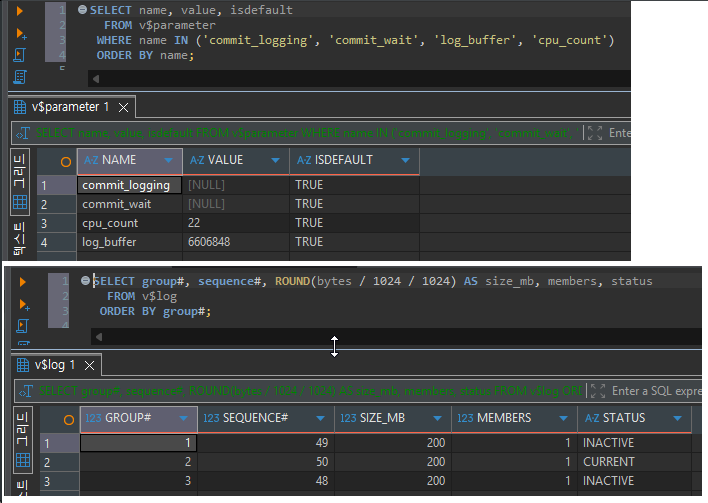
커밋 동작을 바꾸는 파라미터인 commit_logging과 commit_wait는 둘 다 값이 없는 기본값이었습니다. 따라서 COMMIT에 옵션을 붙이지 않은 케이스는 Oracle 기본 동작 그대로입니다. log_buffer는 6,606,848바이트였고, redo log는 200MB 그룹 3개로 구성되어 있었습니다. cpu_count가 22로 나오지만 이는 호스트의 논리 CPU 수입니다. XE가 실제로 쓸 수 있는 CPU는 이보다 적다는 점을 감안하고 읽어야 합니다.
측정은 프로시저 하나가 맡았습니다. 이 프로시저는 테이블을 비운 뒤 V$MYSTAT와 V$SESSION_EVENT 값을 변수에 담고, 루프를 돈 다음 같은 값을 다시 읽어 차이를 결과 테이블에 남깁니다. 기록한 항목은 user commits, redo size, redo synch writes, log file sync 대기 횟수와 시간입니다. 프로시저 안에서 V$ 뷰를 읽어야 하므로 V_$MYSTAT, V_$SESSION_EVENT 등의 SELECT 권한은 롤이 아니라 사용자에게 직접 부여했습니다. 정의자 권한 PL/SQL이 롤 권한을 쓰지 못하는 이유는 롤 권한과 PL/SQL ORA-00942 글에서 따로 확인했습니다.
FOR i IN 1 .. p_rows LOOP
  INSERT INTO point_earn_ledger (ledger_id, member_id, earn_point, earn_type, memo, earned_at)
  VALUES (i, MOD(i, 5000) + 1, MOD(i, 50) * 10 + 10,
          CASE MOD(i, 3) WHEN 0 THEN 'ORDER' WHEN 1 THEN 'REVIEW' ELSE 'EVENT' END,
          'TC43 earn ' || i, SYSDATE);

  IF p_interval > 0 AND MOD(i, p_interval) = 0 THEN
    IF p_wait = 'Y' THEN
      COMMIT WRITE IMMEDIATE WAIT;
    ELSE
      COMMIT;
    END IF;
  END IF;
END LOOP;

IF p_interval = 0 OR MOD(p_rows, p_interval) <> 0 THEN
  COMMIT;
END IF;
다섯 케이스를 한 회차로 묶어 세 번 돌렸습니다. 2회차는 실행 순서가 결과에 주는 영향을 줄이려고 E부터 A까지 거꾸로 돌렸습니다. 1회차가 첫 실행이고, 표의 값은 세 회차의 중앙값입니다. 회차 하나는 12~14초가 걸렸습니다.
프로시저 안에서는 log file sync가 한 번도 잡히지 않았습니다
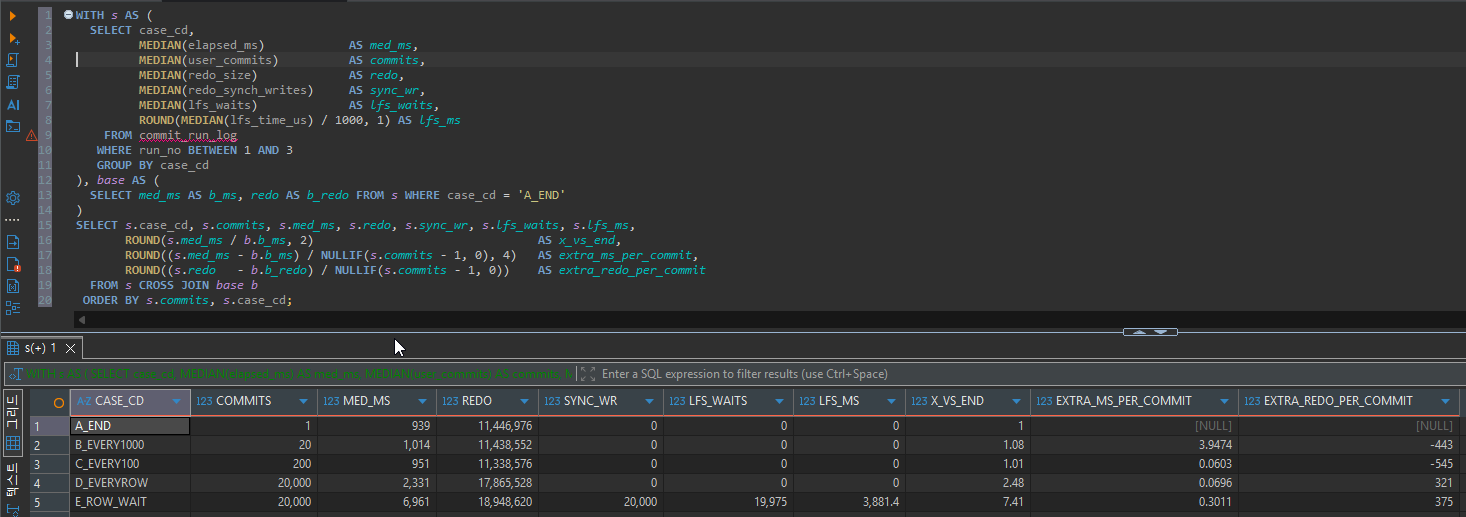
| 케이스 | 커밋 | 소요 시간 | A 대비 | redo synch writes | log file sync |
|---|---|---|---|---|---|
| A_END | 1 | 939ms | 1.00 | 0 | 0회 |
| B_EVERY1000 | 20 | 1,014ms | 1.08 | 0 | 0회 |
| C_EVERY100 | 200 | 951ms | 1.01 | 0 | 0회 |
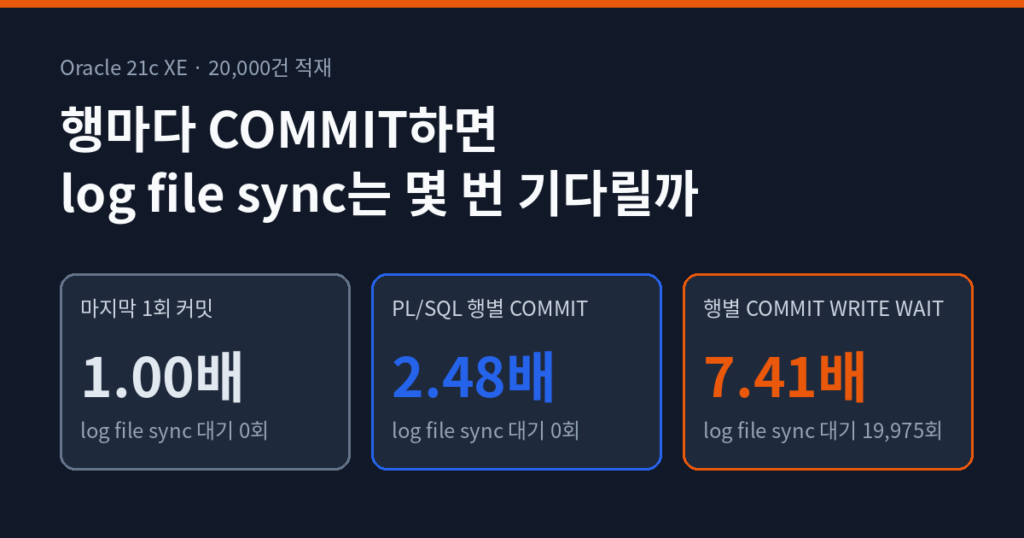
| D_EVERYROW | 20,000 | 2,331ms | 2.48 | 0 | 0회 |
| E_ROW_WAIT | 20,000 | 6,961ms | 7.41 | 20,000 | 19,975회 / 3,881.4ms |
D는 2만 번 커밋하는 동안 redo synch writes가 0이었고, log file sync도 한 번도 기록되지 않았습니다. 행마다 커밋하면 커밋마다 LGWR을 기다린다는 그림과는 다른 결과였습니다.
2만 번의 커밋이 기다린 것은 호출이 끝날 때 한 번이었습니다
그렇다면 대기가 아예 없는 것인지, 측정 범위 밖으로 밀려난 것인지 확인이 필요했습니다. 그래서 집계에서 제외할 확인용 호출(D_CHECK)을 하나 더 만들었습니다. 호출 전후로 세션 누적값을 프로시저 바깥에서 비교하는 방식입니다.
-- 호출 전 누적값
SELECT event, total_waits, ROUND(time_waited_micro / 1000, 1) AS waited_ms
  FROM v$session_event
 WHERE sid = SYS_CONTEXT('USERENV', 'SID')
   AND event = 'log file sync';

BEGIN
  run_commit_case('D_CHECK', 0, 20000, 1);
END;

-- 호출 후 누적값과 프로시저 내부 측정값 비교
SELECT e.total_waits                                AS session_lfs_total,
       ROUND(e.time_waited_micro / 1000, 1)         AS session_lfs_ms,
       (SELECT lfs_waits FROM commit_run_log
         WHERE case_cd = 'D_CHECK' AND run_no = 0)  AS in_call_lfs_waits,
       (SELECT user_commits FROM commit_run_log
         WHERE case_cd = 'D_CHECK' AND run_no = 0)  AS in_call_commits
  FROM v$session_event e
 WHERE e.sid = SYS_CONTEXT('USERENV', 'SID')
   AND e.event = 'log file sync';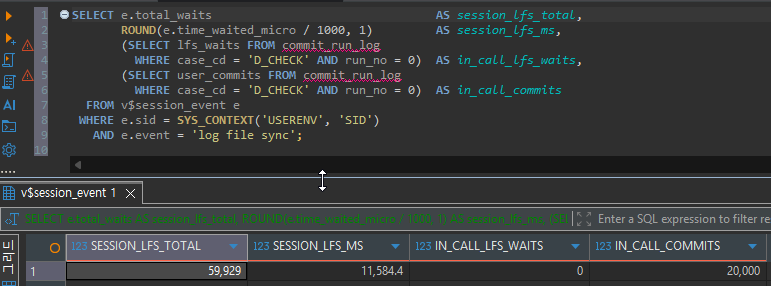
호출 전 세션 누적값은 59,928회, 11,584.1ms였습니다. 호출 후에는 59,929회, 11,584.4ms였습니다. 2만 번 커밋한 호출 하나가 늘린 대기는 1회, 0.3ms뿐입니다. PL/SQL 안의 커밋은 redo가 디스크에 기록될 때까지 매번 기다리지 않고, 클라이언트로 제어를 돌려주기 직전에 한 번만 기다리는 것으로 알려져 있습니다. 측정값이 그 동작과 정확히 맞아떨어졌습니다.
세션 누적 59,928회 가운데 59,922회는 E 케이스 세 회차의 대기를 합한 값과 같습니다. 나머지 6회는 회차별 블록 호출과 DDL 커밋이 끝날 때 생긴 대기로 추정합니다. 하나씩 대조해 확인하지는 않았습니다.
기다리지 않았는데도 1.4초가 늘어났습니다
대기가 0이라고 행별 커밋이 공짜인 것은 아니었습니다. D는 A보다 약 1,392ms 느렸습니다. 커밋 1회당 약 0.07ms가 더 든 셈입니다. redo size도 11,446,976바이트에서 17,865,528바이트로 늘었는데, 커밋 1회당 약 321바이트입니다. 커밋 레코드를 만들고 트랜잭션을 닫는 처리가 2만 번 반복된 비용으로 보입니다. 다만 이 1.4초를 CPU, 래치, redo 생성으로 나눠 보는 데까지는 측정하지 않았습니다.
커밋마다 기다리게 하자 시간의 절반 이상이 log file sync였습니다
E는 중앙값 6,961ms로 A의 7.41배였습니다. 그중 log file sync가 19,975회, 3,881.4ms로 전체의 약 56%를 차지했습니다. 1회차 기준으로 세션의 non-idle 대기 합계는 3,892.7ms였고, log file sync가 3,881.4ms였습니다. 대기 시간은 사실상 전부 log file sync였다고 볼 수 있습니다. SSD 환경에서 대기 1회는 평균 약 0.19ms였습니다.
E와 D는 커밋 횟수가 같고, redo도 약 17.9MB와 18.9MB로 큰 차이가 없습니다. 그런데 E가 약 4.6초 더 걸렸고, 그중 3.9초 정도는 log file sync로 설명됩니다. 남는 0.7초 남짓은 커밋마다 LGWR에 기록을 요청하고 완료 신호를 받는 왕복 비용으로 추정합니다. 확인된 값은 아닙니다.
하나 더 눈에 띈 점이 있습니다. redo synch writes는 세 회차 모두 정확히 20,000이었는데, log file sync 대기 횟수는 19,951~19,996회로 조금씩 모자랐습니다. 커밋을 요청한 시점에 LGWR가 이미 해당 redo를 기록해 두어서, 기다릴 필요가 없었던 경우가 섞였을 가능성이 있습니다.
운영 DB는 AWS RDS 환경이라 Database Insights에서 대기 이벤트를 확인했습니다. 단건 INSERT가 많은 API에는 커밋을 묶어서 처리할 수 있도록 가이드한 적이 있습니다. 애플리케이션이 SQL 호출마다 커밋하는 구조라면, 커밋 하나하나가 호출의 끝이 됩니다. 그래서 이번 결과의 D보다는 E에 가까운 형태로 나타날 수 있습니다. 로컬 SSD에서도 대기 1회가 0.19ms였으니, 쓰기 지연이 더 긴 네트워크 스토리지에서는 E와 다른 케이스의 차이가 이보다 커질 수 있습니다. 커밋 간격과 별개로 단건 INSERT 자체를 묶었을 때 redo가 어떻게 달라지는지는 BULK COLLECT와 FORALL의 redo size 비교 글에서 다뤘습니다.
1,000건 단위가 100건 단위보다 느리게 나온 회차
B(1,000건 단위)의 중앙값 1,014ms가 C(100건 단위) 951ms보다 컸습니다. 커밋을 덜 한 쪽이 더 느린 셈이라 처음에는 예상과 달라 보였습니다. 회차별 원자료를 펼쳐 보니 이유는 단순했습니다.
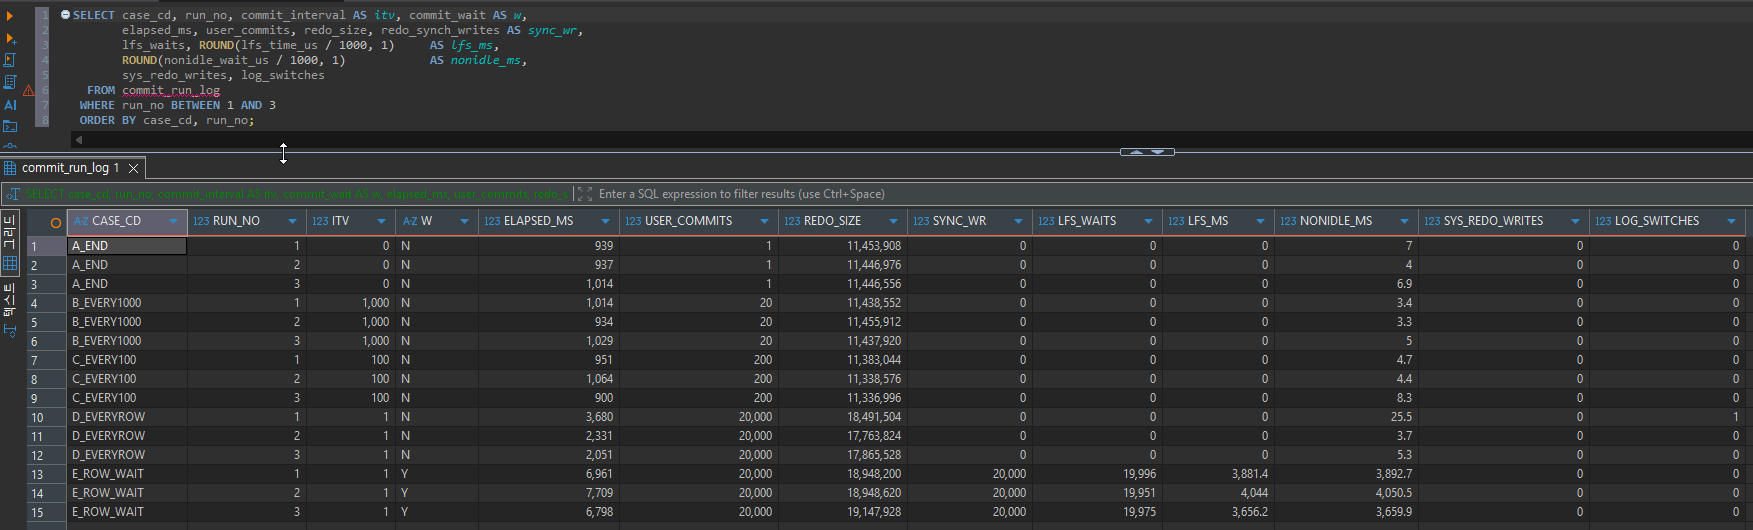
A는 937~1,014ms, B는 934~1,029ms, C는 900~1,064ms였습니다. 세 케이스의 범위가 완전히 겹칩니다. 20건과 200건의 커밋 비용은 이 규모에서 회차 간 흔들림보다 작았습니다. B의 커밋 1회당 추가 시간 3.9474ms는 75ms 차이를 커밋 19번으로 나눈 값입니다. 측정 잡음이 크게 부풀려진 숫자이므로 해석에서 제외했습니다. B의 커밋 1회당 redo가 음수로 나온 것도 같은 이유입니다. B의 redo는 A와 같은 범위 안에서 회차마다 수 KB씩 오르내렸고, 중앙값을 컬럼별로 따로 구하면서 서로 다른 회차의 값이 섞였습니다.
C는 사정이 달랐습니다. C의 redo는 세 회차 모두 11,336,996~11,383,044바이트였습니다. A의 어떤 회차보다도 약 63~117KB 적은 값입니다. 커밋을 200번 했는데 한 번 커밋한 A보다 redo가 꾸준히 적게 나온 셈입니다. 이 차이가 어디서 생겼는지는 이번 측정 항목으로 확인하지 못했습니다. 트랜잭션 하나가 2만 건을 끝까지 들고 갈 때와 100건마다 끊길 때 undo 처리 방식이 달라서일 수 있지만, 이는 추정입니다.
D도 1회차만 3,680ms로 나머지 두 회차(2,331ms, 2,051ms)보다 크게 튀었습니다. 같은 회차에서 로그 스위치가 1번 일어났고, non-idle 대기도 25.5ms로 다른 회차보다 컸습니다. 첫 실행 효과와 로그 스위치 영향이 겹쳤는데, 둘을 따로 떼어 보지는 못했습니다. LGWR의 쓰기 횟수를 보려던 V$SYSSTAT의 redo writes는 PDB 세션에서 모든 회차가 0으로 나와 비교에서 뺐습니다.
행별 커밋 코드를 만났을 때 이 숫자를 읽는 순서
먼저 커밋이 어디서 나가는지 봅니다. PL/SQL 루프 안이라면 커밋마다 생기는 대기는 거의 없고, 남는 비용은 커밋 처리 자체입니다. 이번 환경에서는 행별 커밋 2만 번이 1.4초를 늘렸습니다. 애플리케이션이 SQL 호출마다 커밋한다면 사정이 다릅니다. 커밋 수만큼 log file sync가 쌓이는 E에 가까워지고, 스토리지 쓰기 지연이 그대로 처리 시간에 더해집니다.
대기 이벤트로 판단할 때도 이 구분이 필요합니다. log file sync가 상위 대기로 올라와 있다면, 호출 단위로 커밋하는 프로그램이 있는지부터 찾는 것이 빠릅니다. 반대로 PL/SQL 배치가 느린데 log file sync가 거의 보이지 않는다면, 커밋 횟수는 1순위 원인이 아닐 가능성이 큽니다.
이번 결과는 세션 하나, 로컬 SSD, 21c XE, 20,000건이라는 조건에서 나온 값입니다. 여러 세션이 동시에 커밋하면 LGWR가 여러 커밋을 한 번의 쓰기로 묶어 처리할 수 있습니다. 이 경우 세션별 대기 시간과 횟수가 이번과 다르게 나올 수 있습니다. 동기식 redo 전송을 쓰는 대기 DB 구성이나 RDS 같은 네트워크 스토리지에서는 log file sync 1회의 길이가 달라지므로, 7.41배라는 숫자도 그대로 옮겨 쓸 수 없습니다.
커밋 간격은 이번 환경에서 100건 단위부터 마지막에 한 번 커밋하는 것과 구분되지 않았습니다. 그렇다고 무조건 간격을 크게 잡을 이유는 없습니다. 커밋을 너무 미루면 트랜잭션이 길어지고, 락을 오래 잡으며, 실패했을 때 다시 처리할 범위도 넓어집니다.

댓글 0
첫 댓글을 남겨보세요.