스칼라 서브쿼리는 몇 번 실행될까: 고유값 10개부터 5만 개까지 Starts를 세어 보니

SELECT 절에 붙은 상담원 이름 조회 한 줄
개발자 쿼리 검토에 올라오는 SQL 중에는 SELECT 목록 안에서 코드명이나 이름을 가져오는 스칼라 서브쿼리가 섞여 있습니다. 이런 SQL을 검토할 때 저는 조회 건수와 코드값의 반복 정도, 조회 대상 컬럼의 인덱스와 유일성을 확인했고, 조인으로 바꿀지는 실제 실행 통계를 비교해 정했습니다.
반복 정도를 본 이유는 스칼라 서브쿼리 캐싱 때문입니다. 같은 입력값이 다시 오면 서브쿼리를 다시 실행하지 않고 앞서 받은 결과를 쓴다는 설명이 있지만, 그 캐시가 몇 개의 값까지 버티는지는 숫자로 본 적이 없었습니다. 그래서 21c XE에서 아래 SQL의 참조 컬럼만 바꿔 가며 서브쿼리의 실제 실행 횟수(Starts)를 입력 고유값 개수와 나란히 세어 봤습니다.
SELECT /*+ GATHER_PLAN_STATISTICS */ 'SSQTC03' tc,
       SUM(LENGTH((SELECT /*+ NO_UNNEST */ a.agent_name
                   FROM   cs_agent a
                   WHERE  a.agent_id = t.agt_d1000))) s
FROM   cs_ticket t;
20만 행을 DBeaver로 가져오면 화면 출력 시간이 섞이므로 결과는 SUM(LENGTH(...)) 한 행으로 받았습니다. 'SSQTC03'은 V$SQL에서 이 커서를 찾기 위한 태그입니다.
상담 티켓 20만 건에 참조 컬럼 여섯 개
Oracle Database 21c Express Edition 21.3.0.0.0의 XEPDB1에 DBeaver로 접속했습니다. compatible은 21.0.0, optimizer_features_enable은 21.1.0, statistics_level은 TYPICAL입니다. 관리자 계정으로는 테스트 USER와 권한만 만들었고, 측정은 모두 테스트 USER의 세션 하나에서 했습니다. 측정 루프가 PL/SQL 안에서 V$MYSTAT을 읽기 때문에 V_$ 뷰 SELECT 권한은 롤이 아니라 직접 부여했습니다.
데이터는 가상의 상담원 마스터 CS_AGENT 50,000건(AGENT_ID가 PK)과 상담 티켓 CS_TICKET 200,000건입니다. 티켓 테이블에는 상담원을 가리키는 컬럼을 여섯 개 두고, 값의 범위만 1~10, 1~100, 1~1,000, 1~5,000, 1~20,000, 1~50,000으로 다르게 했습니다. 분포는 모두 균등이고 시드를 고정했습니다.
BEGIN
  DBMS_RANDOM.SEED(20261110);
  INSERT /*+ APPEND */ INTO cs_ticket
  SELECT LEVEL,
         DATE '2026-01-01' + TRUNC(DBMS_RANDOM.VALUE(0, 300)),
         TRUNC(DBMS_RANDOM.VALUE(1, 11)),
         TRUNC(DBMS_RANDOM.VALUE(1, 101)),
         TRUNC(DBMS_RANDOM.VALUE(1, 1001)),
         TRUNC(DBMS_RANDOM.VALUE(1, 5001)),
         TRUNC(DBMS_RANDOM.VALUE(1, 20001)),
         TRUNC(DBMS_RANDOM.VALUE(1, 50001)),
         RPAD('ticket memo ', 60, 'x')
  FROM   dual
  CONNECT BY LEVEL <= 200000;
  COMMIT;
END;

-- 입력 순서만 다른 복사본
CREATE TABLE cs_ticket_sorted AS
SELECT * FROM cs_ticket ORDER BY agt_d50000, ticket_id;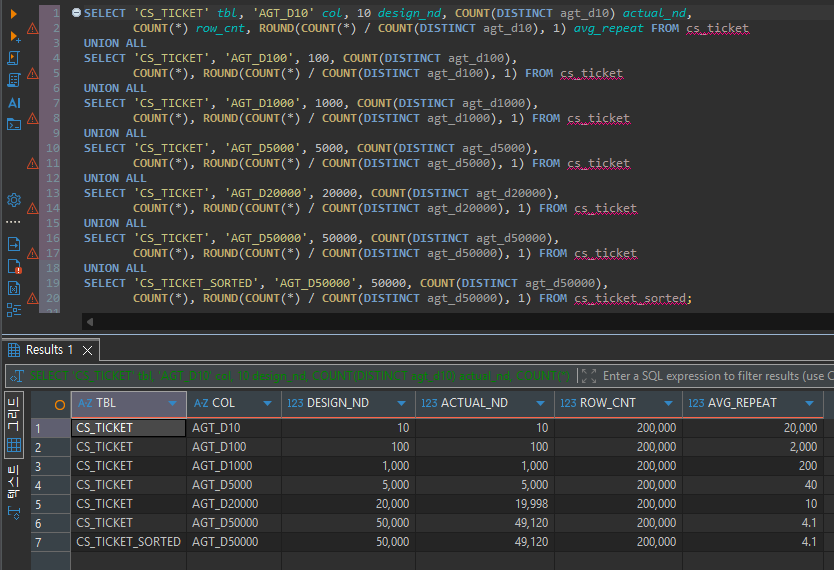
범위가 5만인 컬럼은 20만 행을 뿌려도 880개 값이 한 번도 나오지 않아 49,120개가 됐습니다. 값당 평균 반복은 4.1회입니다. 정렬본은 ROWID 순서로 읽었을 때 값이 거꾸로 가는 행이 0건이었습니다.
통계를 모으기 전 상태를 남기려고 USER_TAB_STATISTICS를 조회했는데, 세 테이블 모두 NUM_ROWS가 이미 채워져 있었습니다. LAST_ANALYZED도 DBMS_STATS를 실행하기 전인 21:38로 찍혀 있었습니다. 빈 테이블에 대한 APPEND 적재와 CTAS에서 Oracle이 적재하면서 통계를 함께 모은 것으로 보입니다. 이후 DBMS_STATS로 다시 모은 BLOCKS는 CS_TICKET 2,909, 정렬본 2,904, CS_AGENT 219입니다.
실행계획에서 서브쿼리 실행 횟수가 찍히는 자리
측정은 TC01~TC08 여덟 개 SQL을 PL/SQL 루프에서 각각 3회 실행하고, 회차마다 경과 시간과 세션의 session logical reads 증가분을 기록했습니다. SQL 문장이 같으므로 1회차만 하드 파스를 거칩니다. TC01~TC06은 참조 컬럼만, TC07은 TC06과 테이블(정렬본)만, TC08은 TC03과 NO_UNNEST 힌트 유무만 다릅니다.
FOR r IN 1 .. 3 LOOP
  SELECT m.value INTO v_lr0
  FROM   v$mystat m JOIN v$statname n ON n.statistic# = m.statistic#
  WHERE  n.name = 'session logical reads';

  v_t0 := SYSTIMESTAMP;
  EXECUTE IMMEDIATE p_sql INTO v_tc, v_sum;
  v_t1 := SYSTIMESTAMP;

  SELECT m.value INTO v_lr1
  FROM   v$mystat m JOIN v$statname n ON n.statistic# = m.statistic#
  WHERE  n.name = 'session logical reads';

  v_iv := v_t1 - v_t0;
  INSERT INTO ssq_run_log
  VALUES (p_tc, p_desc, r,
          ROUND(EXTRACT(MINUTE FROM v_iv) * 60000 + EXTRACT(SECOND FROM v_iv) * 1000, 1),
          v_lr1 - v_lr0, v_sum, SYSTIMESTAMP);
END LOOP;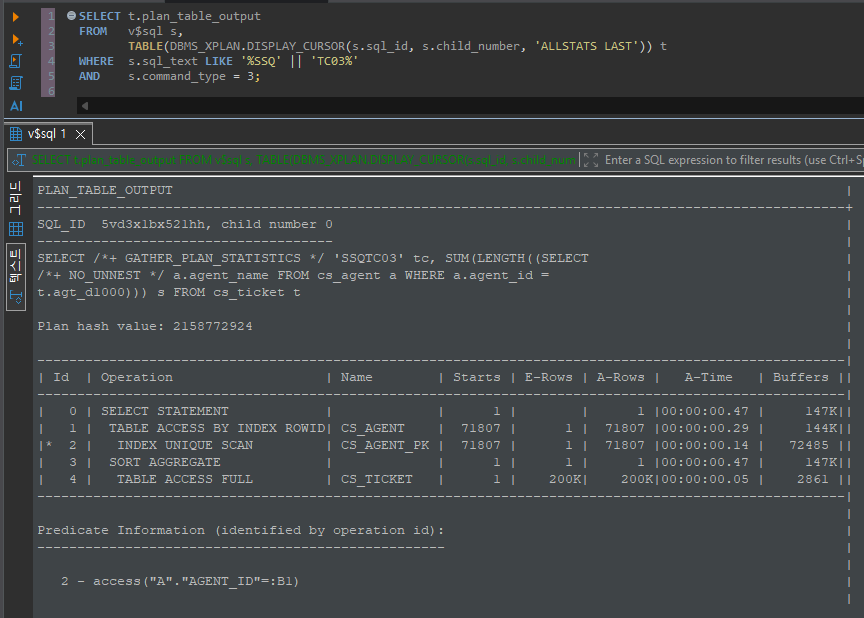
스칼라 서브쿼리는 SELECT STATEMENT 바로 아래, 본문 SORT AGGREGATE와 나란한 별도 가지(Id 1~2)로 나옵니다. 본문 쪽 TABLE ACCESS FULL은 Starts 1, A-Rows 200K이고, 서브쿼리 쪽 INDEX UNIQUE SCAN과 TABLE ACCESS BY INDEX ROWID는 둘 다 Starts 71,807입니다. Predicate의 "A"."AGENT_ID"=:B1은 바깥 행의 값을 바인드처럼 넘겨받아 실행한다는 표시입니다.
71,807은 행 수 20만의 36%이고 고유값 1,000의 약 72배입니다. 행마다 실행되지는 않았지만, 고유값마다 한 번씩만 실행된 것도 아닙니다.
고유값 100개에서 이미 어긋난 Starts
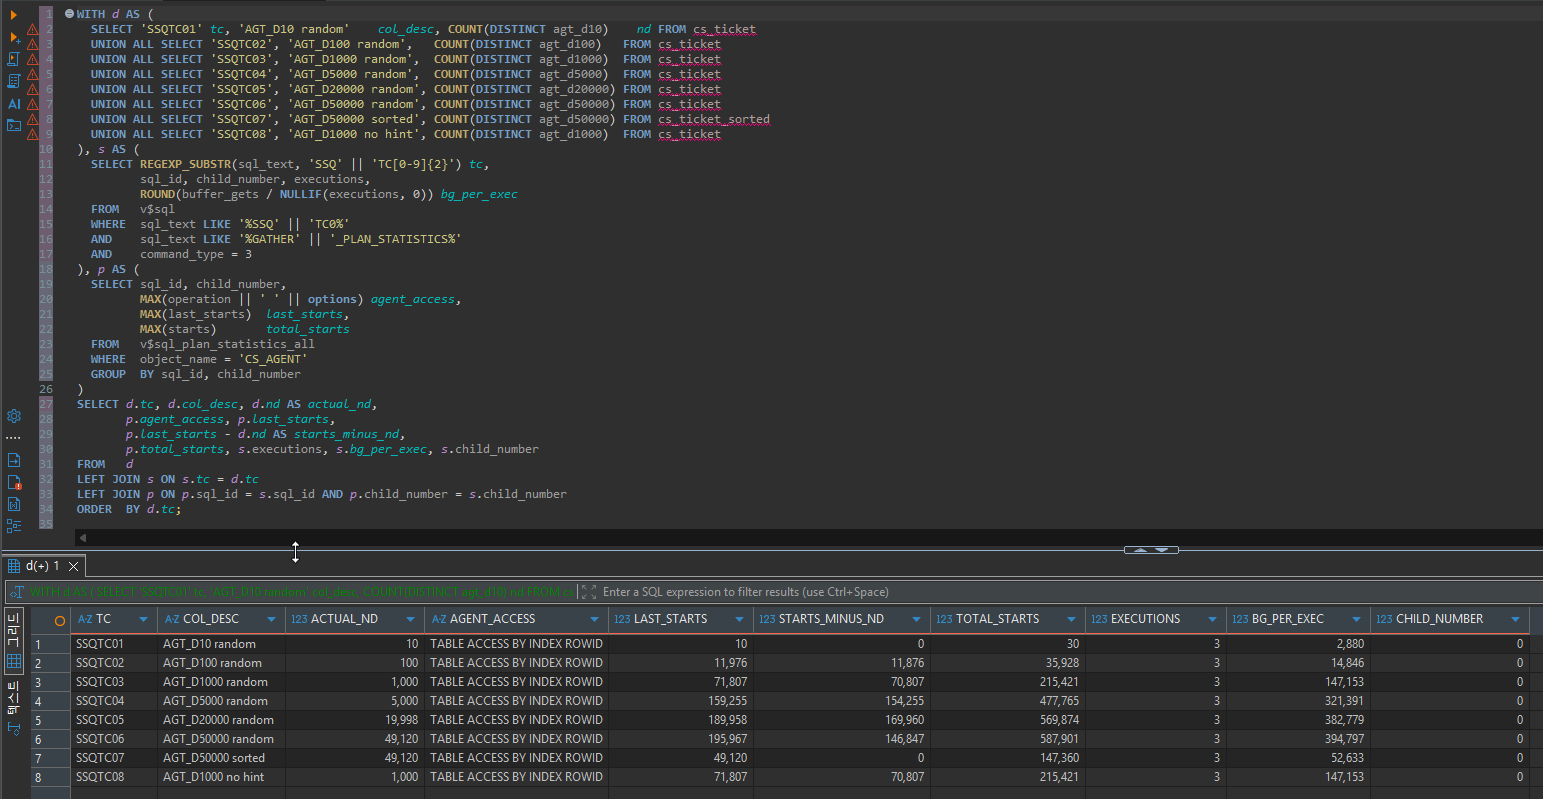
테스트 전에는 고유값 1,000개까지는 Starts가 고유값과 같을 것으로 예상했습니다. 결과는 달랐습니다. 고유값 10개는 Starts 10으로 정확히 같았지만, 100개에서 이미 11,976회가 나왔습니다. 1,000개는 71,807회, 5,000개는 159,255회로 행 수의 80%에 이르렀고, 19,998개와 49,120개에서는 189,958회와 195,967회로 행 수에 거의 붙었습니다. TOTAL_STARTS는 모든 TC에서 LAST_STARTS의 정확히 3배였으므로 캐시는 실행마다 새로 시작하고, 세 번 모두 같은 횟수가 나왔습니다.
이 숫자들이 어떤 규칙에서 나오는지 계산해 봤습니다. 캐시를 1,024칸짜리 해시 테이블로 두고, 두 값이 같은 칸에 걸리면 먼저 들어온 값만 남고 나중 값은 나올 때마다 다시 실행된다고 가정했습니다. 그러면 자리를 잡는 값의 기대 개수는 1,024×(1−e−n/1,024)이고, 나머지 값은 출현 횟수만큼 실행됩니다.
| 실제 고유값 | 실측 Starts | 1,024칸 가정 계산값 | 차이 |
|---|---|---|---|
| 100 | 11,976 | 9,551 | +25.4% |
| 1,000 | 71,807 | 72,967 | −1.6% |
| 5,000 | 159,255 | 160,367 | −0.7% |
| 19,998 | 189,958 | 190,783 | −0.4% |
| 49,120 | 195,967 | 196,855 | −0.5% |
고유값 1,000개 이상에서는 계산값과 실측이 2% 안에서 맞습니다. 계산값이 조금씩 큰 데는 같은 값이 연달아 오는 경우를 계산에서 빼지 않은 몫이 들어 있습니다. 100개에서는 충돌 값이 4.7개로 계산됐는데 실측은 6개 정도에 해당합니다. 이 구간은 값 하나가 2,000행씩이라, 충돌 값이 한 개만 달라져도 Starts가 2,000회 가까이 움직입니다. 1,024라는 크기는 문서에서 확인한 값이 아니라 이번 숫자에 맞춰 본 추정이고, 결과값의 길이나 키 타입이 바뀌어도 같은지는 이번에 확인하지 못했습니다.
캡처 3은 처음에 한 번 다시 찍었습니다. 첫 결과에 SSQTC01 행이 두 번 나왔고, 그중 하나는 LAST_STARTS가 비어 있고 EXECUTIONS가 1이었습니다. 원인은 조회 SQL 자신이었습니다. d 블록에 'SSQTC01'~'SSQTC08' 리터럴이 그대로 들어 있어서 LIKE '%SSQ' || 'TC0%' 검색에 자기 자신이 걸렸습니다. DBeaver가 SQL 위의 주석까지 서버로 보내 V$SQL의 SQL_TEXT가 주석으로 시작한다는 것도 이때 확인했습니다. 아래 조건을 더해 측정 SQL만 남기고 다시 실행했습니다.
WHERE  sql_text LIKE '%SSQ' || 'TC0%'
AND    sql_text LIKE '%GATHER' || '_PLAN_STATISTICS%'
AND    command_type = 3
실행 횟수는 그대로 시간과 블록 읽기로 이어졌다
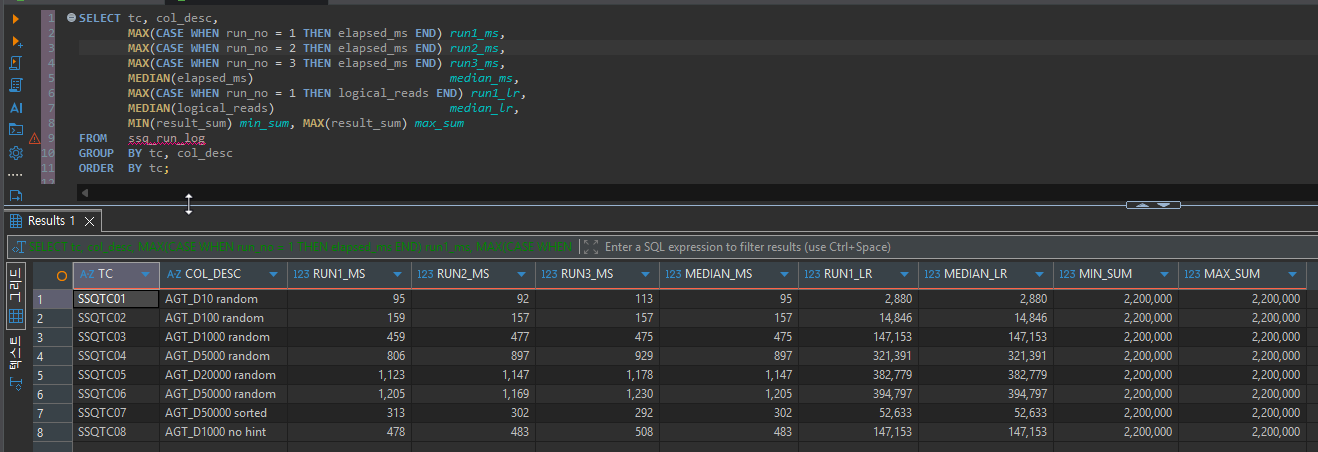
중앙값은 TC01부터 95, 157, 475, 897, 1,147, 1,205ms로 Starts가 늘어나는 순서를 그대로 따라갔습니다. 논리적 읽기는 2,880에서 394,797까지 늘었습니다. 본문 전체 스캔의 2,861블록을 빼고 Starts로 나누면 TC03~TC06은 Start 한 번에 2.0블록입니다. PK 인덱스 한 번, 테이블 한 번이고, 캐시를 놓친 값만큼 이 두 블록이 그대로 더해졌습니다.
TC02만 Start당 1.0블록이었는데, 계획을 따로 떠 보지 않아 인덱스와 테이블 몫을 나눠 확인하지 못했습니다. 1회차 하드 파스는 논리적 읽기에 차이를 만들지 않았고, 시간도 1회차가 늘 가장 길지는 않았습니다.
같은 49,120개 값, 정렬만 바꾼 입력
TC06과 TC07은 데이터가 같고 읽는 순서만 다릅니다. 무작위 순서인 TC06은 Starts 195,967, 중앙값 1,205ms, 논리적 읽기 394,797이었습니다. AGT_D50000 순으로 저장한 TC07은 Starts 49,120으로 고유값과 정확히 같았고, 302ms, 52,633블록이었습니다. 1,024칸 캐시가 이미 가득 찬 상태인데도 같은 값이 연달아 오면 직전 결과를 다시 쓰기 때문에 값마다 한 번만 실행된 것으로 보입니다.
| Id  | Operation                   | Name             | Starts | A-Rows | Buffers |
|   0 | SELECT STATEMENT            |                  |      1 |      1 |   52633 |
|   1 |  TABLE ACCESS BY INDEX ROWID| CS_AGENT         |  49120 |  49120 |   49777 |
|*  2 |   INDEX UNIQUE SCAN         | CS_AGENT_PK      |  49120 |  49120 |     657 |
|   3 |  SORT AGGREGATE             |                  |      1 |      1 |   52633 |
|   4 |   TABLE ACCESS FULL         | CS_TICKET_SORTED |      1 |    200K|    2856 |
TC07의 계획을 나눠 보면 블록이 줄어든 곳은 인덱스였습니다. INDEX UNIQUE SCAN은 49,120번 실행되면서 657블록만 읽었고, 무작위 입력인 TC03에서는 71,807번에 72,485블록이었습니다. 테이블 쪽은 49,777블록으로 Start당 약 1블록이 남았습니다. CS_AGENT_PK는 BLEVEL 1, LEAF_BLOCKS 93, CLUSTERING_FACTOR 207로 AGENT_ID 순서와 테이블 저장 순서가 거의 같은데도 테이블 읽기는 줄지 않았고, 인덱스의 657은 리프 블록 수 93보다 커서 리프 블록마다 한 번 읽었다는 계산과도 맞지 않습니다. 이 657의 구성은 이번 값으로 확인하지 못했습니다.
정렬본의 순서는 CTAS의 ORDER BY와 전체 스캔이 저장 순서대로 읽힌다는 전제에 기대고 있습니다. ROWID 순서에서 값이 거꾸로 가는 행이 0건인 것은 확인했지만, 전체 스캔이 그 순서를 보장하지는 않습니다. 업무 SQL에서는 앞단의 조인 방식이나 병렬 처리에 따라 같은 효과가 사라질 수 있습니다.
NO_UNNEST를 지운 TC08
21c 옵티마이저가 스칼라 서브쿼리를 외부 조인으로 바꿀 수 있다면, 힌트 없이는 Starts를 비교할 대상 자체가 사라질 수 있습니다. 그래서 TC01~TC07에는 NO_UNNEST를 넣었고, TC08은 TC03에서 이 힌트만 뺐습니다.
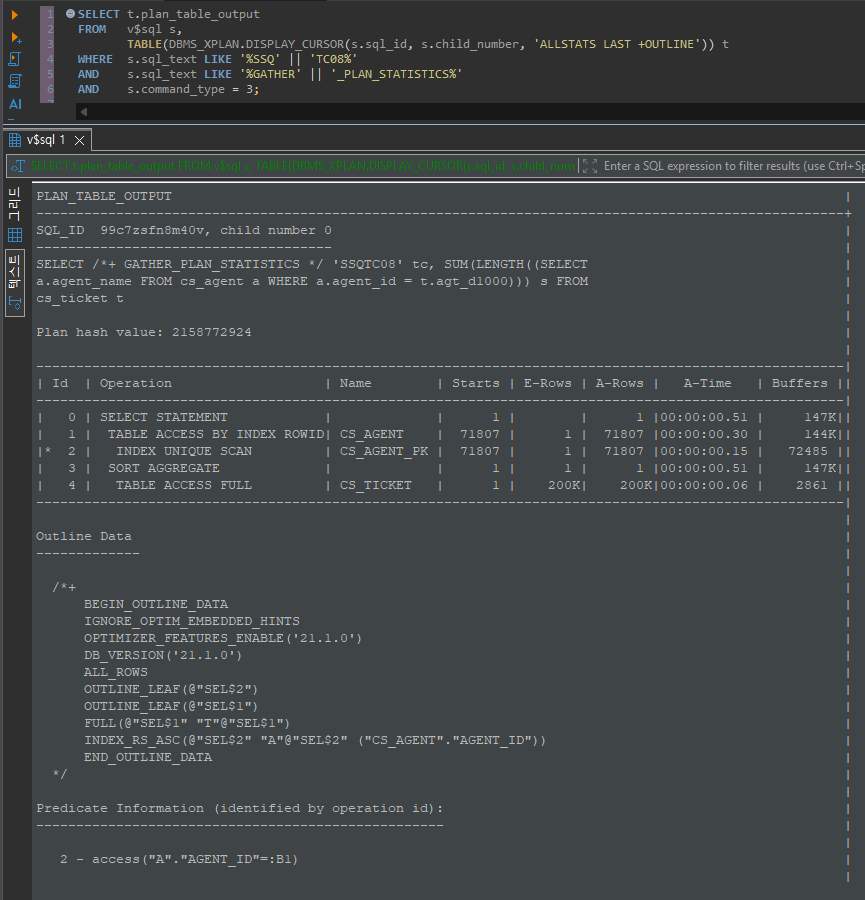
TC08의 Plan hash value는 2158772924로 TC03과 같고, CS_AGENT 쪽 Starts도 71,807로 같습니다. Outline Data에는 OUTLINE_LEAF(@"SEL$2")가 본문 SEL$1과 따로 남아 있고, UNNEST나 조인 순서 힌트는 없습니다. 중앙값도 483ms와 475ms로 차이가 없었습니다. 서브쿼리가 조인으로 바뀌는 쪽을 예상했지만, 이번 SQL 형태에서 21c는 스칼라 서브쿼리를 그대로 두었습니다. 다만 이번 SQL은 테이블 전체를 SUM 하나로 집계하고 서브쿼리가 PK 한 건만 찾는 형태입니다. 결과 행이 많은 목록 조회나 서브쿼리에 다른 조건이 붙는 SQL은 이번 범위 밖이라, 같은 판단을 옮겨 쓰기 전에 따로 떠 봐야 합니다.
Starts를 입력 고유값 옆에 놓고 보는 검토
스칼라 서브쿼리가 들어간 SQL이 느렸을 때 저는 실제 실행계획에서 서브쿼리 쪽 Starts와 Buffers를 확인했습니다. 반복 실행이 많았던 것인지, 한 번 조회할 때 읽는 블록이 많았던 것인지를 나눠 보고 인덱스를 손볼지, 조인으로 바꿀지를 검토했습니다. 이번 테스트는 그중 앞쪽 경우로, 한 번에 2블록뿐인 PK 조회가 20만 행에서 39만 블록이 됐습니다.
이번 결과로 보면 서브쿼리의 Starts를 그 서브쿼리에 들어가는 컬럼의 COUNT(DISTINCT)와 비교하는 것이 출발점입니다. 둘이 같다면 남은 비용은 한 번 실행할 때 읽는 블록입니다. Starts가 고유값의 몇십 배라면 캐시를 놓치고 있다는 뜻이고, 이번에는 고유값 100개에서도 그랬습니다. 이때 정렬된 입력은 SQL에서 보장하기 어려우므로 조인 변경을 먼저 따져 볼 수 있습니다.
조인으로 바꿀 때 저는 결과 행이 늘어나지 않는지, 매칭되지 않는 행이 빠지지 않는지를 함께 확인했습니다. 스칼라 서브쿼리는 찾는 값이 없으면 NULL을 돌려주고 행은 그대로 남지만, 내부 조인으로 바꾸면 그 행이 사라집니다. 조회 대상 키가 유일하지 않으면 행이 늘어나고, 스칼라 서브쿼리였다면 ORA-01427이 났을 상황이 조용히 지나갈 수 있습니다. 이번 테스트는 21c XE 기준이므로, 19c SE2 운영 DB에서 같은 고유값 구간에 같은 Starts가 나오는지는 따로 확인이 필요합니다.
1,024칸 계산이 아직 답하지 못한 것
계산값과 실측이 2% 안에서 맞았지만 그 크기가 어디서 정해지는지는 아직 모릅니다. 이번 서브쿼리는 NUMBER 키로 11바이트짜리 AGENT_NAME 하나를 돌려줬습니다. 결과 컬럼을 VARCHAR2(200)로 늘리거나 키를 문자열로 바꿨을 때 칸 수가 줄어드는지 보면, 캐시가 값의 개수로 정해지는지 메모리 크기로 정해지는지를 구분할 수 있습니다.
정렬 입력의 인덱스 657블록과 TC02의 Start당 1.0블록은 블록을 붙잡아 두고 다시 쓰는 동작과 관련 있어 보입니다. TC02 계획과 세션 통계 buffer is pinned count를 함께 떠 봐야 설명할 수 있습니다.
마지막으로 TC08에서 21c가 조인 변환을 하지 않은 이유입니다. 변환을 시도했지만 비용에서 밀린 것인지, 이 형태가 처음부터 변환 대상이 아니었는지는 Outline만으로는 구분되지 않습니다. 10053 트레이스로 변환 검토 기록을 열어 보는 것이 다음 순서입니다.

댓글 0
첫 댓글을 남겨보세요.