MERGE의 ORA-30926을 LOG ERRORS로 넘기자 먼저 적재된 행이 남았다

같은 고객이 스테이징에 두 번 들어온 동기화 배치
외부 포인트 시스템이 보낸 고객별 잔액을 스테이징 테이블에 쌓아 두고, MERGE 한 문장으로 고객 잔액 테이블에 반영하는 배치를 가정했습니다. 스테이징에 같은 고객이 두 번 들어오면 이 MERGE는 ORA-30926으로 멈춥니다. 여기까지는 오류 메시지만으로도 짐작할 수 있습니다.
제가 운영하는 DB에서는 개발자의 신규·수정 쿼리를 DBA가 검토합니다. MERGE가 올라오면 ON 조건 키가 소스에서 유일한지를 소스 테이블의 PK·유니크 제약으로 확인합니다. 그 확인이 어디까지 막아 주는지, 그리고 중복의 모양에 따라 오류가 어떻게 달라지는지는 직접 돌려 보지 않으면 알 수 없었습니다. 값이 다른 중복, 값까지 같은 중복, 대상에 없는 키의 중복, 그리고 LOG ERRORS를 붙인 경우를 Oracle 21c XE에서 재현했습니다.
21c XE에 만든 잔액 테이블과 스테이징
Oracle Database 21c Express Edition 21.3.0.0.0의 XEPDB1에 테스트 계정 MRG_TEST를 만들고, SQL은 DBeaver의 수동 커밋 편집기에서 실행했습니다. 테이블은 두 개입니다.
- 가상의 고객 포인트 잔액 테이블 CUST_POINT_BAL: 50,000건,
cust_id가 PK, 잔액은 0~100,000 균등 분포(DBMS_RANDOM.SEED(30926)) - 가상의 동기화 스테이징 POINT_SYNC_STG: 20,030건, PK는 적재 일련번호
stg_id
스테이징에는 중복의 종류를 구분하는 dup_type 컬럼을 두었습니다. UNI는 고객당 1건인 19,970건입니다. DV는 고객 10명에 대해 잔액이 다른 두 행을 넣었는데, 그중 5명은 두 번째 행이 30분 늦고 나머지 5명은 시각까지 같습니다. DS는 고객 10명에 대해 잔액·시각·배치 번호가 모두 같은 두 행입니다. NEW는 대상 테이블에 없는 고객 10명을 두 번씩 넣은 것입니다.
케이스마다 소스 조건 하나만 바꾼 MERGE
MERGE 본문은 모든 케이스에서 같습니다. 바뀌는 것은 USING 안의 dup_type 조건 하나뿐입니다. 아래는 UNI에 DV를 섞은 경우입니다.
MERGE INTO cust_point_bal t
USING (SELECT cust_id, point_bal, src_updated_at, batch_no
         FROM point_sync_stg
        WHERE dup_type IN ('UNI', 'DV')) s
   ON (t.cust_id = s.cust_id)
 WHEN MATCHED THEN
   UPDATE SET t.point_bal     = s.point_bal,
              t.last_sync_at  = s.src_updated_at,
              t.last_batch_no = s.batch_no
 WHEN NOT MATCHED THEN
   INSERT (cust_id, grade_cd, point_bal, last_sync_at, last_batch_no)
   VALUES (s.cust_id, 'NM', s.point_bal, s.src_updated_at, s.batch_no);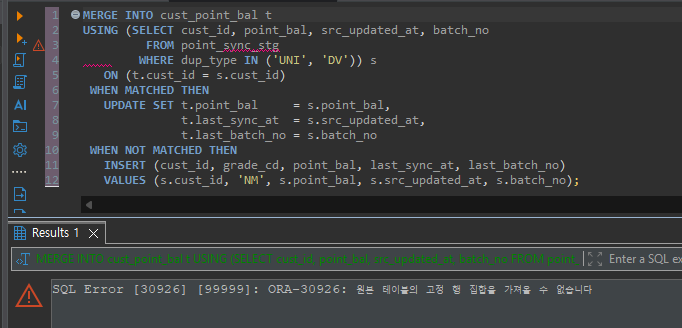
측정은 PL/SQL 블록으로 자동화했습니다. 케이스 여섯 개를 3회씩 실행하면서 MERGE 앞뒤의 V$MYSTAT 값을 비교했습니다. 비교한 통계는 redo size, undo change vector size, db block changes, rollback changes - undo records applied입니다. 실행 직후에는 대상에 반영된 행 수를 센 뒤 ROLLBACK해서 다음 회차가 같은 상태에서 시작하게 했습니다.
FOR i IN 1 .. 3 LOOP
  v_redo0 := st('redo size');
  v_undo0 := st('undo change vector size');
  v_blk0  := st('db block changes');
  v_app0  := st('rollback changes - undo records applied');
  BEGIN
    EXECUTE IMMEDIATE v_sql;      -- dup_type 조건만 다른 MERGE
    v_rows := SQL%ROWCOUNT;
  EXCEPTION
    WHEN OTHERS THEN
      v_code := SQLCODE;
      v_msg  := SUBSTR(SQLERRM, 1, 300);
  END;
  -- 통계 차이, 반영된 행 수, 오류 로그 건수를 변수에 담은 뒤
  ROLLBACK;
  INSERT INTO merge_case_log ( ... ) VALUES ( ... );
  COMMIT;
END LOOP;
갱신할 값이 같아도 ORA-30926
세 번 실행한 값의 중앙값입니다. 반영 건수는 MERGE 직후, ROLLBACK 전에 이번 배치 번호로 바뀐 대상 행 수입니다.
| 케이스 | 소스 | 결과 | 반영 건수 | redo(바이트) | 되돌린 undo 레코드 | 시간 |
|---|---|---|---|---|---|---|
| TC1 | UNI | 성공 | 19,970 | 5,869,512 | 0 | 0.19초 |
| TC2 | UNI + DV | ORA-30926 | 0 | 27,907,108 | 59,922 | 1.09초 |
| TC3 | UNI + DS | ORA-30926 | 0 | 27,907,108 | 59,922 | 1.11초 |
| TC4 | UNI + NEW | ORA-00001 | 0 | 10,071,096 | 19,971 | 0.36초 |
| TC5 | UNI + DV, LOG ERRORS | 성공, 오류 로그 10건 | 19,980 | 28,040,628 | 39,942 | 1.52초 |
| TC6 | UNI + NEW, LOG ERRORS | 성공, 오류 로그 10건 | 19,980 | 10,211,584 | 10 | 0.33초 |
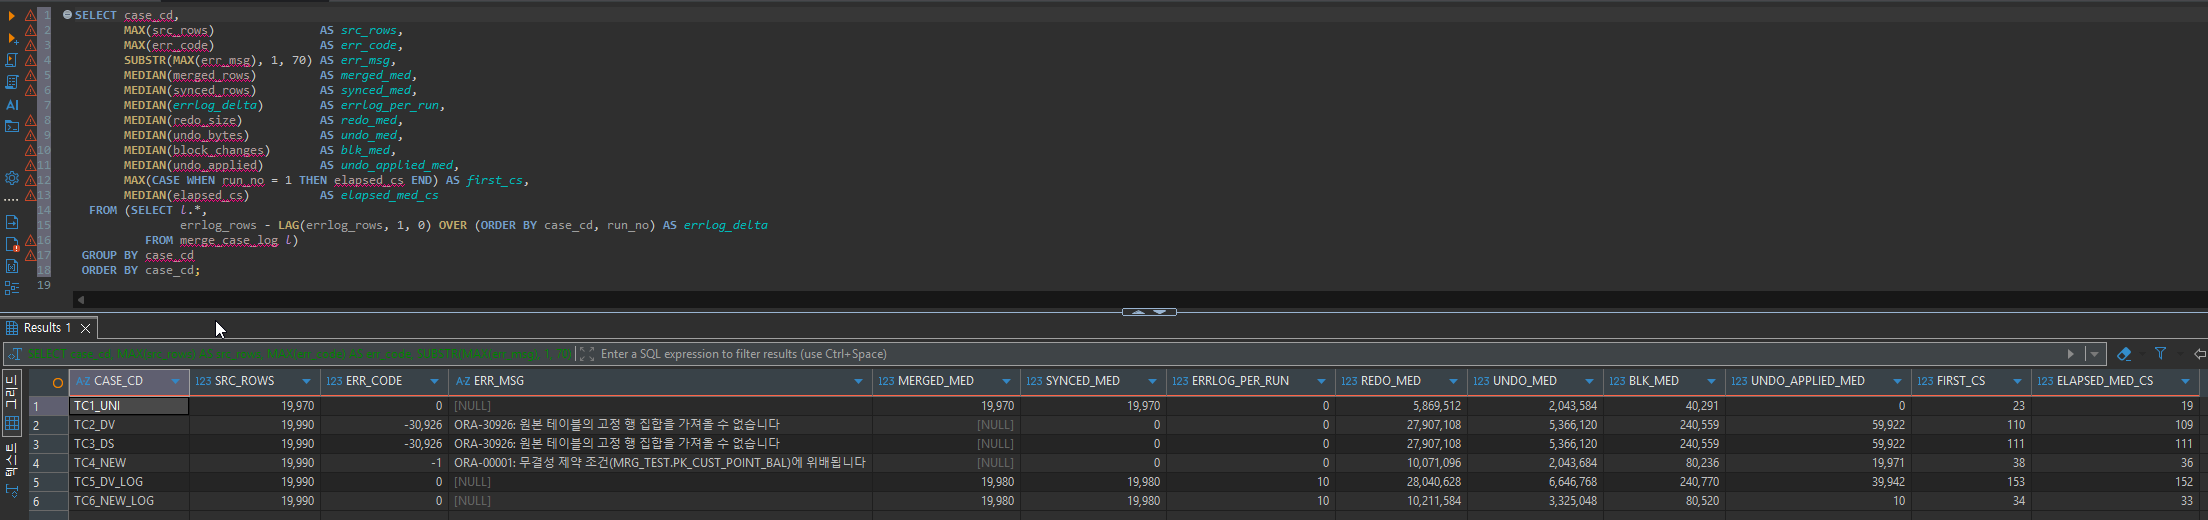
TC3의 두 행은 MERGE가 바꾸는 세 컬럼의 값이 모두 같습니다. 두 번째 갱신으로 바뀌는 값이 없는데도 ORA-30926이 났고, redo·undo·block changes 중앙값까지 TC2와 같았습니다. 이번 결과로 보면 Oracle은 값이 같은지를 따지지 않습니다. 대상 행 하나에 소스 행이 두 번째로 매칭되는 순간 오류를 내는 것으로 보입니다. 중복 행의 값이 완전히 같더라도 MERGE 전에 걸러 내야 한다는 뜻입니다.
실패한 MERGE가 성공보다 비쌌다
TC2와 TC3은 실패 뒤 반영 건수가 0입니다. 문장 단위로 모두 되돌아갔다는 뜻입니다. 대가는 작지 않았습니다. redo는 성공한 TC1의 약 4.8배, db block changes는 약 6배였고 시간은 0.19초에서 1.09초로 늘었습니다. 되돌린 undo 레코드 59,922건은 소스 19,990건의 약 3배입니다. 처리와 되돌리기가 한 번이 아니라 여러 번 일어난 흔적으로 보이지만, 내부에서 문장을 몇 번 다시 시작했는지는 이번 통계로 확인하지 못했습니다. 2만 건 규모에서 나온 비율이라, 건수가 커져도 같은 배수가 유지되는지도 확인이 더 필요합니다. 대량 변경의 redo·undo 크기를 따로 측정한 결과는 전체 DELETE와 TRUNCATE의 Redo·Undo 실측에 있습니다.
대상에 없는 키의 중복은 다른 오류 번호로 나왔다
NEW를 섞은 TC4는 ORA-30926이 아니라 ORA-00001: 무결성 제약 조건(MRG_TEST.PK_CUST_POINT_BAL)에 위배됩니다로 실패했습니다. 대상에 없는 키는 INSERT 분기로 가기 때문에 두 번째 행이 PK에 걸린 것입니다. 되돌린 undo 레코드 19,971건은 이미 끝낸 UPDATE 19,970건까지 전부 되돌린 규모입니다. 원인은 같은 소스 중복인데 오류 번호가 다르므로, 장애 이력을 ORA-30926으로만 찾으면 이 경우는 빠집니다.
소스 PK가 있어도 중복은 남아 있었다
POINT_SYNC_STG에는 PK가 있습니다. 다만 그 PK는 적재 일련번호 stg_id에 걸려 있고, MERGE의 ON 조건은 cust_id입니다. 소스에 PK가 있는지만 보면 이 스테이징은 검토를 통과합니다. 실제 중복은 ON 조건 키로 묶어야 보입니다.
WITH g AS (
  SELECT cust_id,
         MIN(dup_type)                  AS dup_type,
         COUNT(*)                       AS cnt,
         COUNT(DISTINCT point_bal)      AS val_cnt,
         COUNT(DISTINCT src_updated_at) AS ts_cnt
    FROM point_sync_stg
   WHERE batch_no = 20261106
   GROUP BY cust_id
  HAVING COUNT(*) > 1
)
SELECT g.dup_type,
       COUNT(*)                                                        AS dup_keys,
       SUM(g.cnt)                                                      AS dup_rows,
       SUM(CASE WHEN g.val_cnt > 1 THEN 1 ELSE 0 END)                  AS keys_diff_value,
       SUM(CASE WHEN g.val_cnt > 1 AND g.ts_cnt = 1 THEN 1 ELSE 0 END) AS keys_tie_ts,
       COUNT(t.cust_id)                                                AS keys_in_target
  FROM g
  LEFT JOIN cust_point_bal t ON t.cust_id = g.cust_id
 GROUP BY g.dup_type
 ORDER BY g.dup_type;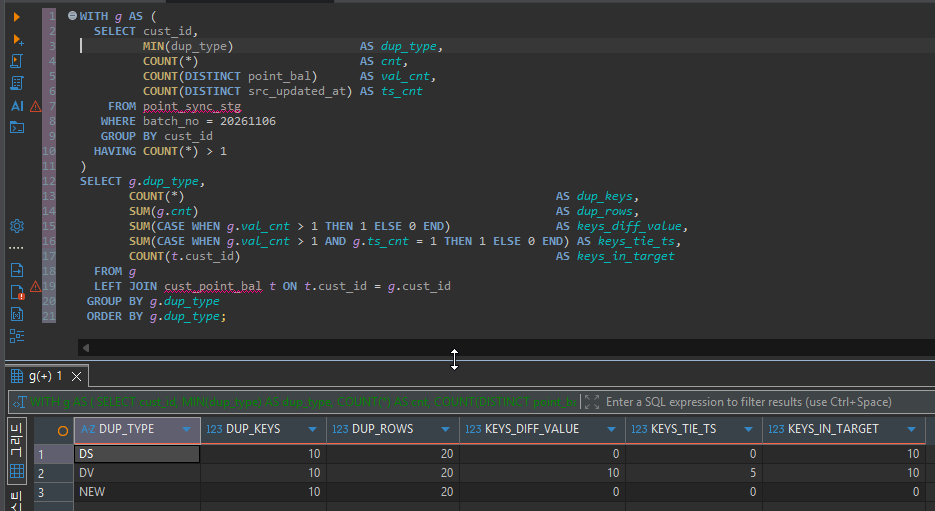
keys_in_target가 두 오류를 갈라 줍니다. DS와 DV는 각 10개 키가 모두 대상에 있어 ORA-30926 후보이고, NEW는 0이라 INSERT 분기에서 PK 위반이 납니다. 진단 쿼리에서 dup_type은 이름표일 뿐이고, 중복 판정은 HAVING COUNT(*) > 1로만 했습니다. 실제 배치에서는 이름표 없이 ON 조건 키로 묶은 결과만으로 충분합니다.
PK·유니크로 확인할 때는 그 제약이 걸린 컬럼이 ON 조건 컬럼과 같은지까지 맞춰 봐야 합니다. 일련번호 PK만 있는 스테이징이라면 위와 같은 GROUP BY 조회를 배포 전에 한 번 돌려 보는 편이 확실합니다.
어느 행을 남길지는 데이터가 정해 주지 않는다
중복을 찾았다면 다음은 키마다 한 행을 고르는 일입니다. DV 10개 키에 대해 최신 시각 기준과 최대값 기준이 고르는 값을 나란히 놓았습니다.
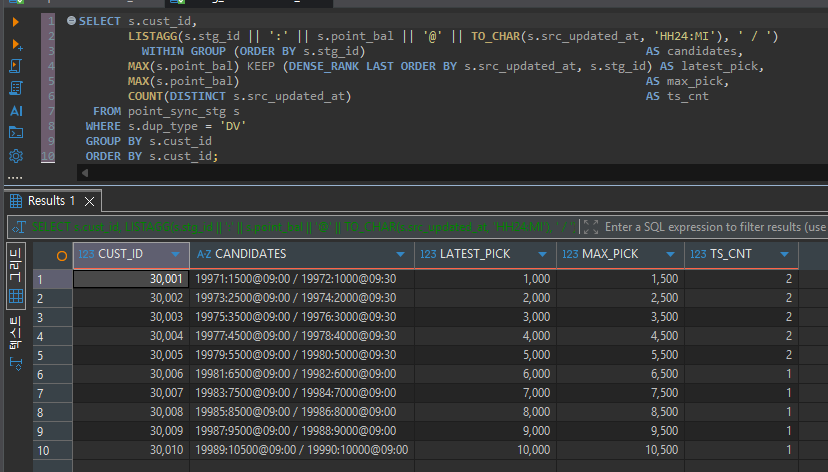
30001~30005는 09:30에 들어온 행이 잔액이 더 낮아 LATEST_PICK 1,000과 MAX_PICK 1,500처럼 갈렸습니다. 30006~30010은 TS_CNT가 1입니다. 시각만으로는 순서를 정할 수 없어 stg_id를 두 번째 정렬 기준으로 넣어야 결과가 고정됩니다. 스테이징이 잔액 스냅샷이라면 최신 행이 맞고, 적립 건별 내역이라면 둘 다 반영해야 할 수도 있습니다. ROW_NUMBER로 한 행만 고르든 SUM으로 합치든 SQL은 어느 쪽으로도 쓸 수 있으니, 이 기준은 데이터를 보낸 쪽의 업무 의미를 확인한 뒤 정해야 합니다.
최신 1건만 남긴 MERGE
잔액 스냅샷으로 보고 키마다 최신 시각 1건을 남기되, 동률이면 stg_id가 큰 행을 고르도록 USING을 바꿨습니다.
MERGE INTO cust_point_bal t
USING (SELECT cust_id, point_bal, src_updated_at, batch_no
         FROM (SELECT p.cust_id, p.point_bal, p.src_updated_at, p.batch_no,
                      ROW_NUMBER() OVER (PARTITION BY p.cust_id
                                         ORDER BY p.src_updated_at DESC, p.stg_id DESC) AS rn
                 FROM point_sync_stg p
                WHERE p.batch_no = 20261106)
        WHERE rn = 1) s
   ON (t.cust_id = s.cust_id)
 WHEN MATCHED THEN
   UPDATE SET t.point_bal     = s.point_bal,
              t.last_sync_at  = s.src_updated_at,
              t.last_batch_no = s.batch_no
 WHEN NOT MATCHED THEN
   INSERT (cust_id, grade_cd, point_bal, last_sync_at, last_batch_no)
   VALUES (s.cust_id, 'NM', s.point_bal, s.src_updated_at, s.batch_no);
DBeaver에는 Updated Rows 20000, 실행 시간 0.341초로 나왔습니다. UNI 19,970건에 DV·DS·NEW에서 키마다 1건씩 30건이 더해진 숫자입니다. COMMIT 전에 대상 테이블을 검증했습니다.
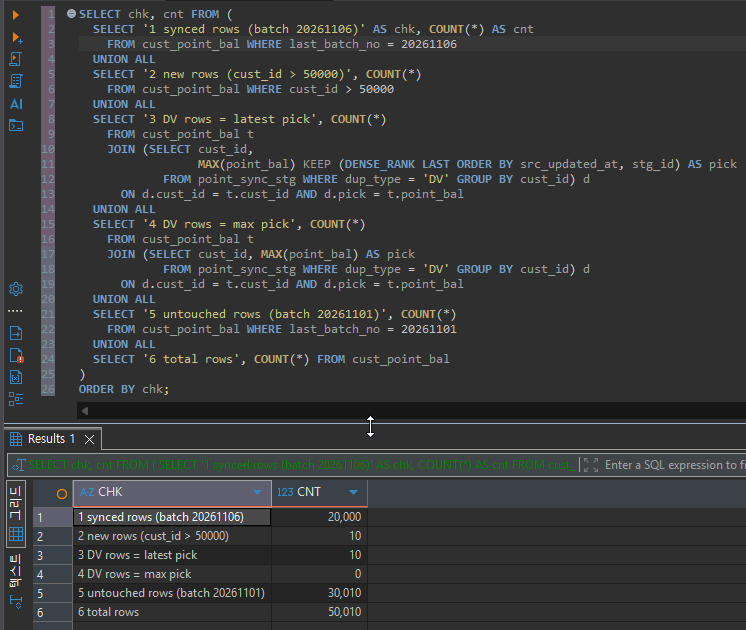
신규 고객 10건이 추가돼 전체는 50,010건이 됐고, 이번 배치와 무관한 30,010건은 그대로입니다. DV 10건은 최신 기준 값과 모두 일치했고 최대값 기준과는 하나도 맞지 않았습니다.
LOG ERRORS로 넘기면 대상에는 무엇이 남나
중복을 거르지 않고 LOG ERRORS INTO err_cust_point_bal REJECT LIMIT UNLIMITED만 붙인 TC5는 오류 없이 끝났습니다. 반영 건수 19,980은 UNI 19,970건과 DV 10개 키의 한 행씩을 더한 값입니다. 나머지 한 행씩은 오류 로그로 빠졌습니다. ORA-30926도 행 단위 오류처럼 기록된다는 뜻입니다.
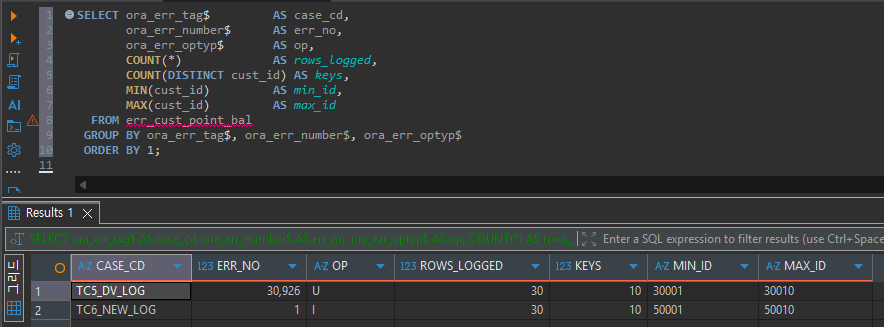
어떤 행이 버려졌는지는 오류 로그에 남은 잔액으로 확인했습니다.
SELECT cust_id, point_bal, COUNT(*) AS cnt
  FROM err_cust_point_bal
 WHERE ora_err_tag$ = 'TC5_DV_LOG'
 GROUP BY cust_id, point_bal
 ORDER BY TO_NUMBER(cust_id);

CUST_ID  POINT_BAL  CNT
30001         1000    3
30002         2000    3
30003         3000    3
30004         4000    3
30005         5000    3
30006         6000    3
30007         7000    3
30008         8000    3
30009         9000    3
30010        10000    3
버려진 쪽은 10개 키 모두 나중에 적재된 행이었고, 3회 모두 같았습니다. 30001~30005에서는 09:30의 최신 잔액이 오류 로그로 빠지고 09:00의 이전 잔액이 대상에 남았습니다. 배치는 성공으로 끝났는데 고객 5명의 잔액은 한 단계 오래된 값입니다. 테스트 전에는 ORA-30926만큼은 LOG ERRORS를 붙여도 문장 전체가 실패할 것으로 봤기 때문에, 가장 크게 어긋난 결과였습니다.
먼저 적재된 행이 남은 것은 MERGE가 소스를 읽은 순서 때문으로 보입니다. 다만 이번에는 실행계획으로 읽기 순서를 확인하지 않았고, 계획이 바뀌거나 병렬로 읽으면 남는 행도 달라질 수 있습니다. LOG ERRORS를 MERGE에 붙인다면 오류 로그 건수를 배치 성공 조건에 넣어야 합니다. 그렇지 않으면 어느 값이 남았는지 아무도 모르게 됩니다. 적재 중 실패 건만 따로 남기는 방식은 VARCHAR2(10)에 한글 네 글자가 안 들어가는 이유: ORA-12899를 바이트 단위로 확인한 결과와도 이어지는 주제입니다.
TC6에서는 NEW의 두 번째 행이 ORA_ERR_OPTYP$ = 'I', 오류 번호 1로 기록됐고 신규 고객 10명은 한 행씩 들어갔습니다. 되돌린 undo 레코드는 10건으로, 실패한 INSERT만 행 단위로 되돌렸다고 보면 맞는 숫자입니다.
ROLLBACK 뒤에도 쌓인 오류 로그
측정 블록은 회차마다 ROLLBACK했는데, MERGE 직후 센 오류 로그 건수가 TC5에서 10, 20, 30으로, TC6에서 40, 50, 60으로 계속 늘었습니다. MERGE가 바꾼 대상 행은 ROLLBACK으로 사라졌지만, 오류 로그 행은 그 트랜잭션과 별개로 남았습니다. 처음 요약 쿼리는 이 누적값의 중앙값을 보여 줘서 회차당 건수가 20, 50처럼 나왔습니다. 그래서 직전 회차와의 차이로 다시 계산했습니다.
errlog_rows - LAG(errlog_rows, 1, 0) OVER (ORDER BY case_cd, run_no) AS errlog_delta다시 계산하니 두 케이스 모두 회차당 10건이었습니다. 운영 배치로 옮기면 의미가 분명합니다. 실패한 배치를 ROLLBACK하고 다시 돌릴 때마다 오류 로그 테이블은 계속 커집니다. 실패 건수를 셀 때는 배치 번호 같은 태그로 걸러야 하고, 오류 로그 테이블을 따로 비우는 주기도 정해 둬야 합니다.
INSERT 분기가 섞이자 두 배가 된 block changes
표를 다시 보면 설명하지 못한 숫자가 하나 있습니다. NEW를 섞은 TC4와 TC6은 소스가 TC1보다 20건 많을 뿐인데, db block changes가 각각 80,236과 80,520으로 TC1 40,291의 두 배였습니다. redo도 약 1.7배였습니다. TC4는 실패해서 19,971건을 되돌렸고 TC6은 10건만 되돌렸는데 두 값이 거의 같습니다. 그러니 되돌리기 비용으로는 설명되지 않습니다.
INSERT 분기가 실제로 실행될 때 MERGE가 대상 블록을 다루는 방식이 달라진 것으로 보입니다. 하지만 이번에 본 통계 네 개로는 그 이상을 가려낼 수 없었습니다. 다음에는 같은 두 케이스에서 redo entries와 인덱스 관련 통계를 함께 받고, SQL Trace로 행 단위 처리 순서를 확인할 생각입니다. 같은 동작이 운영에서 쓰는 19c에서도 나오는지 역시 아직 답하지 못한 질문입니다.

댓글 0
첫 댓글을 남겨보세요.