VARCHAR2(10)에 한글 네 글자가 안 들어가는 이유: ORA-12899를 바이트 단위로 확인한 결과
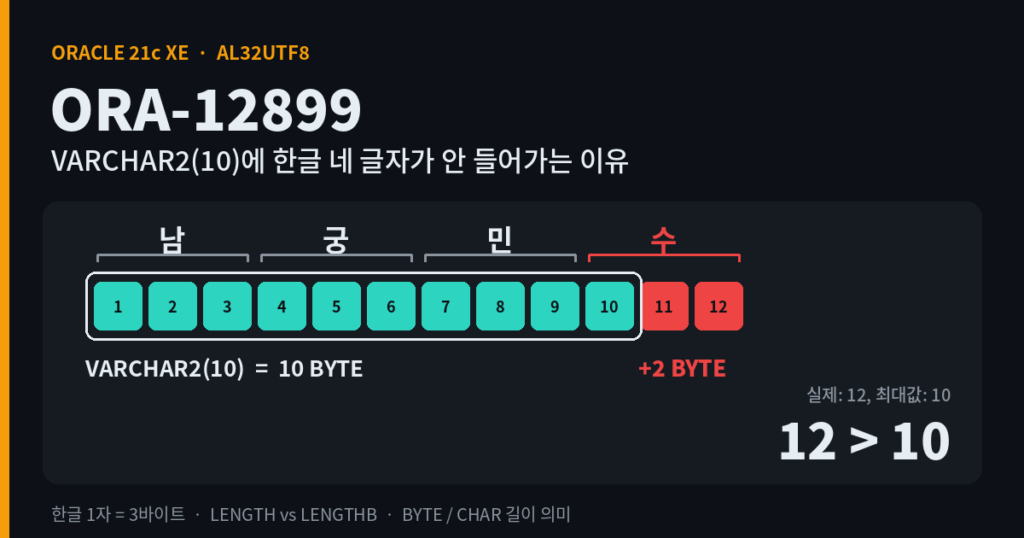
ORA-12899: 실제 12, 최대값 10
INSERT INTO col_len_test (c_byte) VALUES ('남궁민수');

SQL Error [12899] [72000]: ORA-12899: "HANGUL_LAB"."COL_LEN_TEST"."C_BYTE" 열에 대한 값이 너무 큼(실제: 12, 최대값: 10)
네 글자를 넣었는데 Oracle은 12라고 계산했습니다. 컬럼은 VARCHAR2(10)이었고, 이 컬럼의 10은 글자 수가 아니라 바이트 수였습니다. 여기까지는 알려진 내용입니다. 확인하고 싶었던 것은 그다음입니다. 10 CHAR로 바꾸거나 NVARCHAR2를 쓰면 정말 10글자가 보장되는지, 그리고 이관 전에 이 오류를 미리 걸러 내려면 무엇으로 점검해야 하는지를 Oracle 21c XE에서 확인했습니다.
측정 전에 세운 가설은 다섯 가지입니다.
- AL32UTF8에서 한글 1자는 3바이트이고, 네 글자는 12바이트라
VARCHAR2(10)을 넘는다. VARCHAR2(10 CHAR)와NVARCHAR2(10)에는 한글 10자가 들어가지만, 딕셔너리의DATA_LENGTH는 10이 아니다.- CHAR 길이 의미를 써도 4,000바이트 상한은 그대로다.
- 세션의
NLS_LENGTH_SEMANTICS는 이미 있는 컬럼을 바꾸지 않는다. - 이관 전에
LENGTH로 점검하면 실패할 행을 놓친다.
다섯 개 모두 맞았습니다. 그런데 이모지를 넣어 보니 NVARCHAR2에서 예상하지 못한 결과가 나왔습니다.
12바이트는 어디서 왔나
실습 환경은 Oracle Database 21c Express Edition(21.3.0.0.0)의 PDB인 XEPDB1이고, DBeaver로 테스트 전용 USER HANGUL_LAB에 접속했습니다. 운영 DB가 아닌 블로그 실습 환경입니다. 권한은 SYSTEM 계정으로 CREATE SESSION, CREATE TABLE, USERS 쿼터만 주었습니다. SYSTEM으로 확인한 max_string_size는 STANDARD였습니다. 즉 SQL에서 VARCHAR2의 최대 길이는 4,000바이트입니다.
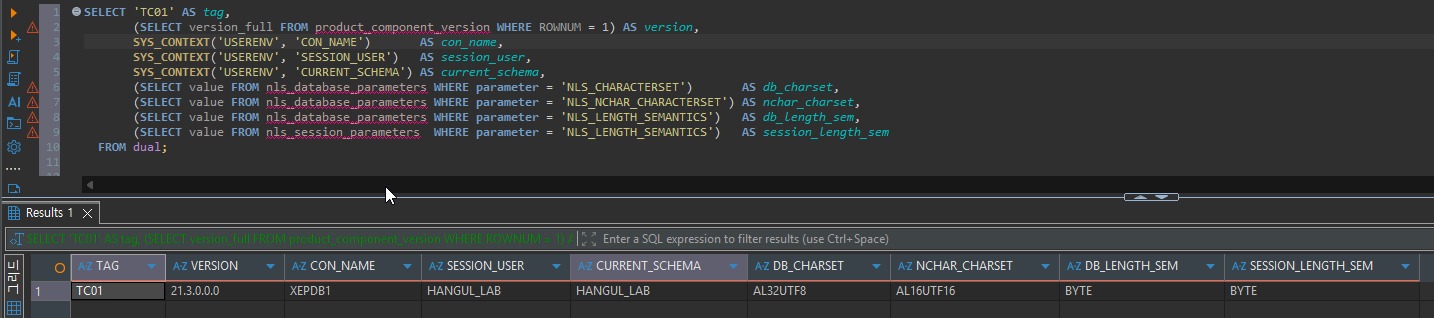
이 글의 모든 결과는 DB 문자셋이 AL32UTF8이라는 전제에서 나왔습니다. 한글을 2바이트로 저장하는 문자셋이었다면 네 글자는 8바이트라서 같은 컬럼에 들어갔을 것입니다. 실제로 몇 바이트가 저장되는지는 DUMP로 확인했습니다.
SELECT n, s,
       LENGTH(s)     AS len_char,
       LENGTHB(s)    AS len_byte,
       DUMP(s, 1016) AS dump_hex
  FROM (SELECT 1 AS n, CAST('홍길동'   AS VARCHAR2(40 CHAR)) AS s FROM dual
        UNION ALL SELECT 2, CAST('남궁민수' AS VARCHAR2(40 CHAR)) FROM dual
        UNION ALL SELECT 3, CAST('ABCD'     AS VARCHAR2(40 CHAR)) FROM dual
        UNION ALL SELECT 4, CAST('가나다A'  AS VARCHAR2(40 CHAR)) FROM dual
        UNION ALL SELECT 5, CAST(TO_CHAR(UNISTR('\D83D\DE00')) AS VARCHAR2(40 CHAR)) FROM dual)
 ORDER BY n;
리터럴을 VARCHAR2로 CAST한 데는 이유가 있습니다. 문자열 리터럴은 CHAR 타입이라, 길이가 다른 리터럴을 UNION하면 공백이 채워져 바이트 수가 부풀 수 있기 때문입니다.
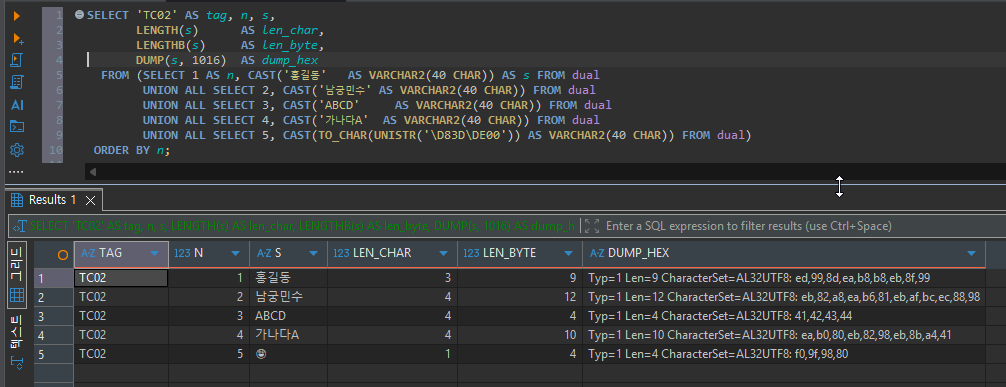
‘남궁민수’의 DUMP는 eb,82,a8,ea,b6,81,eb,af,bc,ec,88,98이었습니다. 3바이트씩 끊으면 네 글자가 정확히 나옵니다. 오류 메시지의 12는 이 바이트 수입니다. 가나다A는 4글자이지만 9바이트 + 1바이트로 정확히 10바이트이고, 이모지 하나는 LENGTH 1, LENGTHB 4였습니다.
같은 10이 다른 뜻이 되는 컬럼 네 개
길이 의미만 다른 컬럼 네 개로 테이블을 만들었습니다. 첫 번째 컬럼은 길이 의미를 쓰지 않았으므로 세션 기본값인 BYTE를 따릅니다.
CREATE TABLE col_len_test (
  c_byte VARCHAR2(10),
  c_char VARCHAR2(10 CHAR),
  n_char NVARCHAR2(10),
  c_big  VARCHAR2(4000 CHAR)
);
세션 설정이 언제 적용되는지도 함께 확인했습니다. 세션을 CHAR로 바꾼 상태에서 길이 의미 없이 컬럼을 하나 더 만들고, 바로 BYTE로 되돌렸습니다. 원복 후 NLS_SESSION_PARAMETERS는 BYTE였습니다.
ALTER SESSION SET NLS_LENGTH_SEMANTICS = CHAR;
CREATE TABLE col_len_sess (c_default VARCHAR2(10));
ALTER SESSION SET NLS_LENGTH_SEMANTICS = BYTE;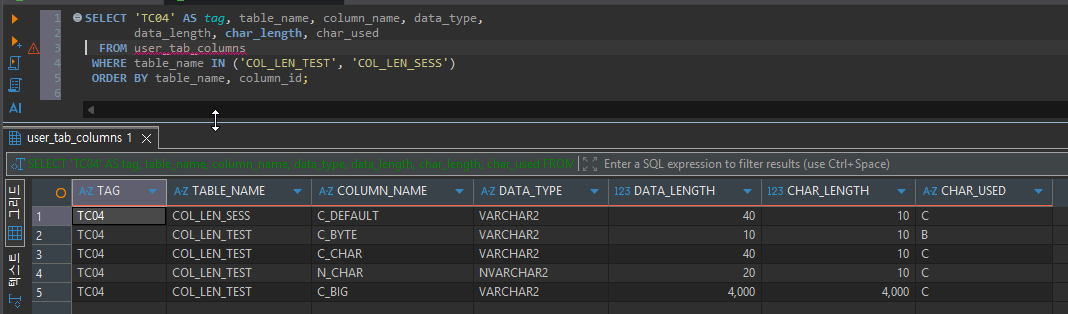
| 컬럼 | DATA_LENGTH | CHAR_LENGTH | CHAR_USED |
|---|---|---|---|
VARCHAR2(10) | 10 | 10 | B |
VARCHAR2(10 CHAR) | 40 | 10 | C |
NVARCHAR2(10) | 20 | 10 | C |
VARCHAR2(4000 CHAR) | 4,000 | 4,000 | C |
세션 CHAR에서 만든 VARCHAR2(10) | 40 | 10 | C |
길이를 10으로 선언한 컬럼은 CHAR_LENGTH가 모두 10인데 DATA_LENGTH는 10, 40, 20으로 다릅니다. 40은 AL32UTF8의 한 글자 최대 4바이트 × 10, 20은 AL16UTF16의 2바이트 × 10으로 보면 맞는 값입니다. VARCHAR2(4000 CHAR)는 4,000 × 4가 아니라 4,000에서 멈췄습니다. 그리고 DDL 문장이 완전히 같아도 세션 설정에 따라 BYTE 컬럼이 되기도 하고 CHAR 컬럼이 되기도 했습니다. 이미 만들어진 C_BYTE는 세션을 바꾼 뒤에도 B 그대로였습니다.
값 13개를 네 컬럼에 넣어 본 결과
값마다 네 컬럼에 하나씩 INSERT를 시도하고, 성공하면 ROLLBACK한 뒤 OK를, 실패하면 오류 메시지의 두 숫자를 결과 테이블에 남겼습니다. 이번 환경에서는 오류 메시지가 한국어로 나왔기 때문에, 영문 메시지에서도 동작하도록 정규식은 괄호 안의 숫자 두 개만 뽑게 만들었습니다.
FUNCTION try_col(p_col VARCHAR2, p_val VARCHAR2) RETURN VARCHAR2 IS
  v_code NUMBER;
  v_msg  VARCHAR2(4000);
BEGIN
  EXECUTE IMMEDIATE 'INSERT INTO col_len_test (' || p_col || ') VALUES (:1)' USING p_val;
  ROLLBACK;
  RETURN 'OK';
EXCEPTION
  WHEN OTHERS THEN
    v_code := SQLCODE;
    v_msg  := SQLERRM;
    ROLLBACK;
    IF v_code = -12899 THEN
      RETURN 'ORA-12899 '
          || REGEXP_SUBSTR(v_msg, '\(\D*(\d+)\D+(\d+)\)', 1, 1, NULL, 1) || '/'
          || REGEXP_SUBSTR(v_msg, '\(\D*(\d+)\D+(\d+)\)', 1, 1, NULL, 2);
    END IF;
    RETURN 'ORA-' || LPAD(ABS(v_code), 5, '0');
END;
한글 1,333자와 1,334자, 이모지 여러 개처럼 긴 값은 PL/SQL 루프에서 같은 문자를 이어 붙여 만들었습니다.
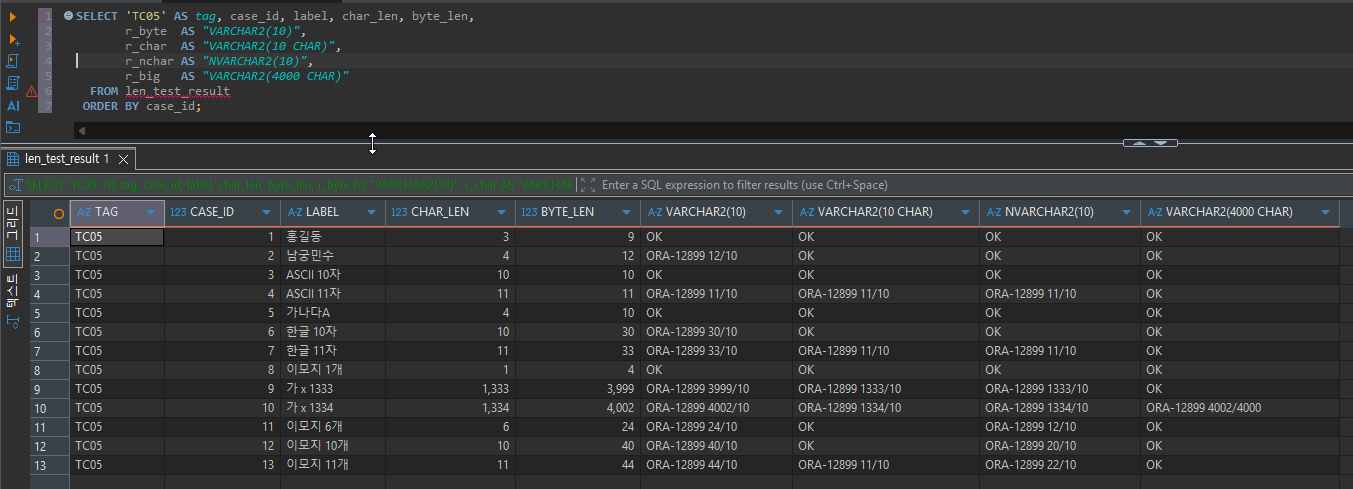
아래 표는 13개 중 결과가 갈린 행만 추린 것입니다.
| 값 | LENGTH / LENGTHB | VARCHAR2(10) | VARCHAR2(10 CHAR) | NVARCHAR2(10) | VARCHAR2(4000 CHAR) |
|---|---|---|---|---|---|
| 남궁민수 | 4 / 12 | 12/10 | OK | OK | OK |
| 한글 10자 | 10 / 30 | 30/10 | OK | OK | OK |
| 한글 11자 | 11 / 33 | 33/10 | 11/10 | 11/10 | OK |
| 가 × 1,333 | 1,333 / 3,999 | 3999/10 | 1333/10 | 1333/10 | OK |
| 가 × 1,334 | 1,334 / 4,002 | 4002/10 | 1334/10 | 1334/10 | 4002/4000 |
| 이모지 6개 | 6 / 24 | 24/10 | OK | 12/10 | OK |
| 이모지 10개 | 10 / 40 | 40/10 | OK | 20/10 | OK |
| 이모지 11개 | 11 / 44 | 44/10 | 11/10 | 22/10 | OK |
표의 오류 칸은 모두 ORA-12899이고, 숫자는 실제/최대값입니다. 영문 10자와 가나다A(10바이트)는 네 컬럼 모두 통과했습니다.
CHAR로 바꾸면 해결되는 것
VARCHAR2(10 CHAR)는 한글 10자(30바이트)를 받았고 11자에서 실패했습니다. 이때 오류 숫자는 11/10으로, 바이트가 아니라 글자 수로 찍혔습니다. 같은 ORA-12899라도 BYTE 컬럼은 바이트로, CHAR 컬럼은 글자 수로 보고된 것입니다. 오류 메시지의 숫자를 읽기 전에, 그 컬럼의 CHAR_USED부터 봐야 하는 이유입니다.
4000 CHAR는 4,000자가 아니었다
VARCHAR2(4000 CHAR)는 한글 1,333자(3,999바이트)를 받았고 1,334자(4,002바이트)에서 실패했습니다. 이번에는 글자 수 기준으로 1,334는 4,000보다 작은데도 실패했고, 오류 숫자는 다시 바이트인 4002/4000으로 찍혔습니다. CHAR 길이 의미는 글자 수 제한을 추가할 뿐, STANDARD 환경의 4,000바이트 상한을 없애지 않았습니다. 이 컬럼에 담을 수 있는 한글은 1,333자까지입니다. 메시지의 최대값 4000을 4,000자로 읽으면 원인을 잘못 짚게 됩니다.
이모지에서 NVARCHAR2만 다르게 셌다
이모지 6개는 VARCHAR2(10 CHAR)에 들어갔지만 NVARCHAR2(10)에서는 12/10으로 실패했습니다. 10개와 11개도 각각 20/10, 22/10이었습니다. NVARCHAR2는 이모지 하나를 2로 셌습니다. 이 결과로 보면 NVARCHAR2(10)에는 이모지가 5개까지만 들어갑니다. UTF-16에서 이모지는 2개의 코드 단위(서로게이트 쌍)로 표현되고, 그 단위로 길이를 센 결과로 해석됩니다(추정). 반면 VARCHAR2(10 CHAR)는 이모지 10개, 40바이트까지 받았습니다. 딕셔너리의 DATA_LENGTH 40과 정확히 맞는 값입니다.
이관 전 LENGTH 점검이 놓친 150건
마지막으로 이 차이가 이관 작업에서 어떻게 드러나는지 재현했습니다. 회원 이름을 VARCHAR2(40 CHAR)에서 VARCHAR2(10) 컬럼으로 옮기는 블로그용 가상 시나리오입니다. 1,000건이면 실패할 행의 비율을 보기에 충분하고, 길이 오류는 건수와 상관이 없어서 이 규모를 골랐습니다. 분포는 난수 대신 MOD로 고정했습니다. 3글자 이름 700건, 2글자 100건, 남궁·제갈·선우·독고 같은 복성 4글자 150건, 영문 Kim Minseo 50건입니다.
CREATE TABLE member_name_src (member_id NUMBER, member_name VARCHAR2(40 CHAR));

INSERT INTO member_name_src (member_id, member_name)
SELECT r.rn,
       CASE
         WHEN MOD(r.rn, 20) BETWEEN 0 AND 13 THEN
              SUBSTR(c.sn, MOD(r.rn, 20) + 1, 1)
           || SUBSTR(c.gv, MOD(r.rn * 3, 20) + 1, 1)
           || SUBSTR(c.gv, MOD(r.rn * 7, 20) + 1, 1)
         WHEN MOD(r.rn, 20) IN (14, 15) THEN
              SUBSTR(c.sn, MOD(r.rn, 20) + 1, 1)
           || SUBSTR(c.gv, MOD(r.rn * 3, 20) + 1, 1)
         WHEN MOD(r.rn, 20) IN (16, 17, 18) THEN
              SUBSTR(c.cs, MOD(r.rn, 4) * 2 + 1, 2)
           || SUBSTR(c.gv, MOD(r.rn * 3, 20) + 1, 1)
           || SUBSTR(c.gv, MOD(r.rn * 7, 20) + 1, 1)
         ELSE c.en
       END
  FROM (SELECT LEVEL AS rn FROM dual CONNECT BY LEVEL <= 1000) r
 CROSS JOIN (SELECT CAST('김이박최정강조윤장임한오서신권황안송류홍' AS VARCHAR2(40 CHAR)) AS sn,
                    CAST('민서준지우하윤도현수연예은시아건주원채린' AS VARCHAR2(40 CHAR)) AS gv,
                    CAST('남궁제갈선우독고' AS VARCHAR2(40 CHAR))                     AS cs,
                    CAST('Kim Minseo' AS VARCHAR2(40 CHAR))                           AS en
               FROM dual) c;
COMMIT;

CREATE TABLE member_name_tgt (member_id NUMBER, member_name VARCHAR2(10));
옮기기 전에 두 가지 방식으로 점검했습니다.
SELECT LENGTH(member_name)  AS len_char,
       LENGTHB(member_name) AS len_byte,
       COUNT(*)             AS cnt,
       CASE WHEN LENGTH(member_name)  <= 10 THEN 'OK' ELSE 'OVER' END AS check_by_length,
       CASE WHEN LENGTHB(member_name) <= 10 THEN 'OK' ELSE 'OVER' END AS check_by_lengthb
  FROM member_name_src
 GROUP BY LENGTH(member_name), LENGTHB(member_name)
 ORDER BY len_byte, len_char;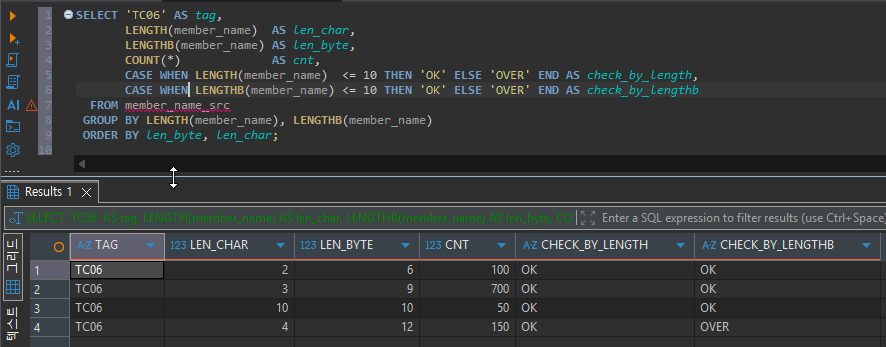
LENGTH 기준으로는 네 그룹이 모두 OK였습니다. 가장 긴 이름이 영문 10자이기 때문입니다. LENGTHB 기준으로는 4글자 12바이트 그룹 150건만 OVER였습니다. 이 상태로 INSERT ... SELECT를 실행했더니 앞에서 본 것과 같은 ORA-12899(실제: 12, 최대값: 10)가 났습니다. 실행 후 대상 테이블의 건수는 0이었습니다. 1,000건 중 150건만 문제였지만, 문장 하나로 옮겼기 때문에 나머지 850건도 함께 들어가지 않았습니다.
ALTER TABLE member_name_tgt MODIFY (member_name VARCHAR2(10 CHAR));

INSERT INTO member_name_tgt (member_id, member_name)
SELECT member_id, member_name FROM member_name_src;
COMMIT;
컬럼을 10 CHAR로 바꾼 뒤에는 1,000건이 모두 들어갔습니다. 딕셔너리는 DATA_LENGTH 40, CHAR_LENGTH 10, CHAR_USED C로 바뀌었습니다. 적재된 값의 최대 글자 수는 10, 최대 바이트 수는 12였습니다. 컬럼 정의가 10이어도 실제로는 10바이트를 넘는 값이 저장되고 있다는 뜻입니다.
컬럼 길이를 정할 때 볼 것
판단 기준
- AL32UTF8 DB에서 한글이 들어가는 컬럼은 DDL에
CHAR를 직접 적는 편이 안전합니다. 길이 의미를 생략하면 그 DDL을 실행한 세션의 설정에 따라 결과가 달라집니다. 이번 실험에서 같은VARCHAR2(10)문장이 세션 설정에 따라 B와 C로 갈렸습니다. - 이관 전 점검은 대상 컬럼의 길이 의미에 맞춰야 합니다. BYTE 컬럼이면
LENGTHB로, CHAR 컬럼이면LENGTH로 점검하되, 대상이 크다면LENGTHB4,000 이하인지도 함께 봐야 합니다. VARCHAR2(4000 CHAR)에 담을 수 있는 한글은 STANDARD 환경에서 1,333자까지였습니다. 그보다 긴 본문은 CLOB을 검토할 대상입니다.MAX_STRING_SIZE를 EXTENDED로 바꾸는 방법도 있지만, 한번 바꾸면 STANDARD로 되돌릴 수 없는 설정입니다.- 사용자 입력에 이모지가 섞일 수 있는 컬럼이라면
NVARCHAR2가 해법이 되지 않을 수 있습니다. 이번 결과로 계산하면NVARCHAR2(10)은 이모지를 5개까지만 받을 수 있는 길이입니다.
조건이 달라지면 결과가 바뀔 수 있는 지점
- DB 문자셋이 한글을 2바이트로 저장하는 문자셋이라면 ‘남궁민수’는 8바이트라서
VARCHAR2(10)에 들어갑니다. 이 글의 숫자는 AL32UTF8 기준입니다. MAX_STRING_SIZE가 EXTENDED인 DB에서는 4,000바이트 상한이 32,767바이트로 바뀝니다.- 자모를 분리해 저장한 한글(조합형 정규화, NFD)은 글자 하나가 여러 코드 포인트라
LENGTH와LENGTHB가 다르게 나올 수 있습니다. 이번에는 확인하지 않았습니다. - 데이터가 들어 있는 큰 테이블에서 BYTE를 CHAR로 바꾸는
MODIFY는 측정하지 않았습니다. 이번에는 빈 테이블에서만 실행했습니다.
운영에서 추가로 확인할 것
NLS_DATABASE_PARAMETERS의NLS_CHARACTERSET과NLS_LENGTH_SEMANTICS- 한글이 들어가는 VARCHAR2 컬럼 중
CHAR_USED가 B인 컬럼이 섞여 있는지 - 배포 스크립트를 실행하는 도구나 세션에
NLS_LENGTH_SEMANTICS설정이 걸려 있는지
SELECT table_name, column_name, char_length, char_used
  FROM user_tab_columns
 WHERE data_type = 'VARCHAR2'
 ORDER BY char_used, table_name, column_id;
이 테스트의 한계
AL32UTF8 문자셋 하나에서만 확인했습니다. 이모지는 한 종류(U+1F600)만 넣었고, 데이터는 1,000건이며, 접속 도구는 DBeaver 하나였습니다. 애플리케이션 드라이버마다 문자열을 변환하는 방식은 다를 수 있습니다.
10은 바이트였고, CHAR로 바꿔도 4,000바이트는 남았다
‘남궁민수’가 거부된 이유는 단순했습니다. AL32UTF8에서 한글 1자는 3바이트이고, 길이 의미를 적지 않은 VARCHAR2(10)의 10은 바이트였습니다. 하지만 CHAR로 바꾼다고 해서 모든 것이 글자 수로 바뀌지는 않았습니다. VARCHAR2(4000 CHAR)는 한글 1,334자에서 바이트 기준으로 실패했고, NVARCHAR2(10)은 이모지를 2자로 셌습니다. 이관 점검도 LENGTH만 보면 150건을 놓쳤습니다. 컬럼 길이를 정하거나 점검할 때는 숫자 옆에 그 숫자의 단위가 무엇인지를 함께 확인해야 합니다.

댓글 0
첫 댓글을 남겨보세요.