전체 DELETE와 TRUNCATE의 Redo·Undo 실측: 395배 차이가 인덱스 2개에 727배가 된 이유
33,338,892바이트와 84,384바이트
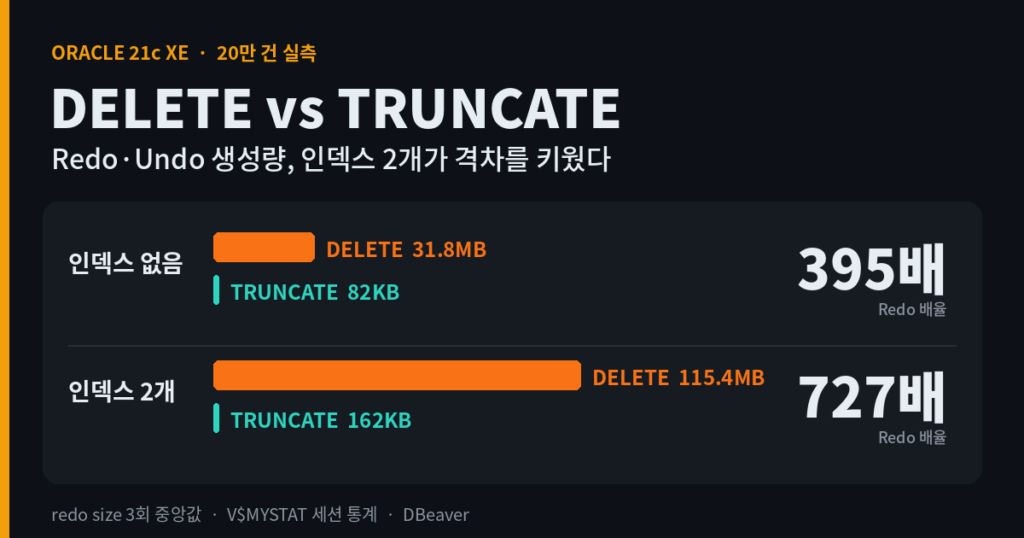
같은 20만 건 테이블을 두 가지 방법으로 비웠습니다. 한 번은 DELETE FROM noti_log; 뒤에 COMMIT을 했고, 한 번은 TRUNCATE TABLE noti_log;를 실행했습니다. 세션 통계 redo size는 전자가 33,338,892바이트, 후자가 84,384바이트였습니다. 약 395배 차이입니다.
TRUNCATE가 가볍다는 말은 익숙합니다. 그래서 확인하고 싶었던 것은 차이의 크기보다 그 구성이었습니다. TRUNCATE의 Redo와 Undo는 정말 0에 가까운지, DELETE의 Redo 중 Undo가 차지하는 몫은 얼마인지, 인덱스 2개가 붙으면 이 격차가 어떻게 바뀌는지를 Oracle 21c XE에서 측정했습니다. 측정 전에 세운 가설은 세 가지입니다.
- 전체 DELETE의
undo change vector size는 테이블 데이터 크기와 비슷한 규모이고,redo size는 그보다 크다. - TRUNCATE도 딕셔너리 변경분만큼 Redo와 Undo를 만든다. 0은 아니다.
- 인덱스 2개가 붙으면 DELETE의 Undo 레코드 수(
USED_UREC)는 행 수 × 3에 가까워진다.
앞의 두 가설은 맞았고, 세 번째는 절반만 맞았습니다.
측정 설계: 대조군을 둔 V$MYSTAT 스냅샷
테스트 환경
Oracle Database 21c Express Edition의 PDB인 XEPDB1에 테스트 전용 USER REDO_LAB을 만들고 DBeaver로 접속했습니다. 운영 DB가 아닌 블로그 실습 환경입니다. SYSTEM 계정으로 CREATE SESSION, CREATE TABLE, USERS 테이블스페이스 쿼터, SELECT_CATALOG_ROLE만 부여했습니다. 측정은 익명 PL/SQL 블록에서 하므로 롤로 받은 V$ 뷰 조회 권한이 그대로 동작합니다. AWR이나 ASH 같은 라이선스 기능은 쓰지 않았습니다.
블록 크기는 8KB입니다. Undo는 AUTO 관리이고 undo_retention은 900초였습니다. Undo 테이블스페이스 UNDOTBS1의 데이터파일은 100MB로 시작했고, 자동 확장이 켜져 있으며 최대 32,768MB입니다. Redo 로그는 200MB 그룹 3개입니다. 이 글의 MB는 모두 1024×1024바이트 기준입니다.
테스트 데이터
알림 발송 로그를 월 단위로 비우는 배치를 가정한 가상 시나리오입니다. 원본 NOTI_LOG_SRC에 20만 건을 만들고, 측정 대상인 NOTI_LOG는 매 회차 원본에서 다시 채웁니다. 20만 건은 DELETE의 Undo와 Redo가 수십 MB로 커지면서도, DELETE 6회분의 Undo 증가와 로그 스위치를 XE가 감당할 수 있는 규모로 골랐습니다. DBMS_RANDOM.SEED(41)를 써서 같은 데이터를 다시 만들 수 있게 했습니다.
BEGIN
  DBMS_RANDOM.SEED(41);
END;

CREATE TABLE noti_log_src AS
SELECT ROWNUM AS log_id,
       TRUNC(DBMS_RANDOM.VALUE(1, 50001)) AS member_id,
       CASE MOD(ROWNUM, 4) WHEN 0 THEN 'PUSH' WHEN 1 THEN 'SMS'
                           WHEN 2 THEN 'EMAIL' ELSE 'KAKAO' END AS channel,
       CASE WHEN MOD(ROWNUM, 20) = 0 THEN 'FAIL' ELSE 'SENT' END AS status,
       DATE '2026-09-01' + DBMS_RANDOM.VALUE(0, 30) AS sent_at,
       DBMS_RANDOM.STRING('X', 120) AS payload
  FROM (SELECT 1 FROM dual CONNECT BY LEVEL <= 1000) a,
       (SELECT 1 FROM dual CONNECT BY LEVEL <= 200) b;

CREATE TABLE noti_log AS SELECT * FROM noti_log_src WHERE 1 = 0;

CREATE TABLE redo_result (
  case_name VARCHAR2(10), op VARCHAR2(10), run_no NUMBER,
  redo_size NUMBER, undo_cv_size NUMBER, redo_entries NUMBER, db_block_changes NUMBER,
  used_ublk NUMBER, used_urec NUMBER, elapsed_cs NUMBER,
  seg_blocks_after NUMBER, seg_extents_after NUMBER,
  logged_at DATE DEFAULT SYSDATE
);
통계를 수집해 보니 원본은 200,000행, 4,412블록이었고 평균 행 길이는 149바이트였습니다.
측정 블록
한 회차는 재적재, 스냅샷, 작업, 스냅샷, 차이 저장 순서로 진행합니다. 재적재는 TRUNCATE와 APPEND 힌트로 매번 같은 상태를 만들며, 측정 구간에는 넣지 않았습니다. 스냅샷은 V$MYSTAT을 PL/SQL 변수로 읽기만 하므로 측정 자체는 Redo를 만들지 않아야 합니다. 이를 확인하려고 아무 작업 없이 스냅샷만 두 번 찍는 대조군을 3회 넣었습니다. DELETE는 커밋 직전에 V$TRANSACTION에서 Undo 사용량도 함께 읽습니다.
DECLARE
  v_case VARCHAR2(10);
  v_cnt  NUMBER;

  PROCEDURE snap(p_redo OUT NUMBER, p_undo OUT NUMBER,
                 p_ent  OUT NUMBER, p_chg  OUT NUMBER) IS
  BEGIN
    SELECT MAX(CASE n.name WHEN 'redo size'               THEN m.value END),
           MAX(CASE n.name WHEN 'undo change vector size' THEN m.value END),
           MAX(CASE n.name WHEN 'redo entries'            THEN m.value END),
           MAX(CASE n.name WHEN 'db block changes'        THEN m.value END)
      INTO p_redo, p_undo, p_ent, p_chg
      FROM v$mystat m
      JOIN v$statname n ON n.statistic# = m.statistic#
     WHERE n.name IN ('redo size', 'undo change vector size',
                      'redo entries', 'db block changes');
  END;

  PROCEDURE reload IS
  BEGIN
    EXECUTE IMMEDIATE 'TRUNCATE TABLE noti_log';
    INSERT /*+ APPEND */ INTO noti_log SELECT * FROM noti_log_src;
    COMMIT;
  END;

  PROCEDURE run_case(p_op VARCHAR2, p_run NUMBER) IS
    b_redo NUMBER; b_undo NUMBER; b_ent NUMBER; b_chg NUMBER;
    a_redo NUMBER; a_undo NUMBER; a_ent NUMBER; a_chg NUMBER;
    v_ublk NUMBER; v_urec NUMBER; v_t0 NUMBER; v_cs NUMBER;
    v_blocks NUMBER; v_ext NUMBER;
  BEGIN
    IF p_op <> 'NONE' THEN
      reload;
    END IF;

    snap(b_redo, b_undo, b_ent, b_chg);
    v_t0 := DBMS_UTILITY.GET_TIME;

    IF p_op = 'DELETE' THEN
      DELETE FROM noti_log;
      SELECT MAX(t.used_ublk), MAX(t.used_urec)
        INTO v_ublk, v_urec
        FROM v$transaction t
        JOIN v$session s ON s.saddr = t.ses_addr
       WHERE s.sid = TO_NUMBER(SYS_CONTEXT('USERENV', 'SID'));
      COMMIT;
    ELSIF p_op = 'TRUNCATE' THEN
      EXECUTE IMMEDIATE 'TRUNCATE TABLE noti_log';
    END IF;

    v_cs := DBMS_UTILITY.GET_TIME - v_t0;
    snap(a_redo, a_undo, a_ent, a_chg);

    SELECT MAX(blocks), MAX(extents) INTO v_blocks, v_ext
      FROM user_segments WHERE segment_name = 'NOTI_LOG';

    INSERT INTO redo_result
      (case_name, op, run_no, redo_size, undo_cv_size, redo_entries,
       db_block_changes, used_ublk, used_urec, elapsed_cs,
       seg_blocks_after, seg_extents_after)
    VALUES
      (v_case, p_op, p_run, a_redo - b_redo, a_undo - b_undo, a_ent - b_ent,
       a_chg - b_chg, v_ublk, v_urec, v_cs, v_blocks, v_ext);
    COMMIT;
  END;

BEGIN
  SELECT COUNT(*) INTO v_cnt FROM user_indexes WHERE table_name = 'NOTI_LOG';
  v_case := CASE WHEN v_cnt = 0 THEN 'NOIDX' ELSE 'IDX' || v_cnt END;

  FOR i IN 1 .. 3 LOOP run_case('NONE', i);     END LOOP;
  FOR i IN 1 .. 3 LOOP run_case('DELETE', i);   END LOOP;
  FOR i IN 1 .. 3 LOOP run_case('TRUNCATE', i); END LOOP;
END;
먼저 인덱스 없이 이 블록을 실행했습니다. 그다음 인덱스 2개를 만들고 같은 블록을 다시 실행했습니다. 두 번의 실행에서 바꾼 조건은 인덱스 유무 하나뿐입니다.
CREATE INDEX ix_noti_log_member ON noti_log (member_id);
CREATE INDEX ix_noti_log_sent   ON noti_log (sent_at);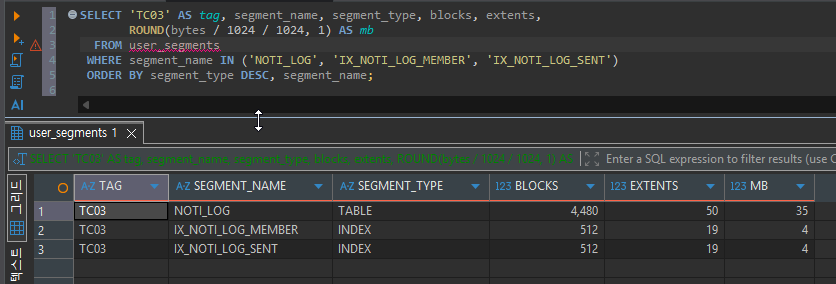
18회 측정 결과
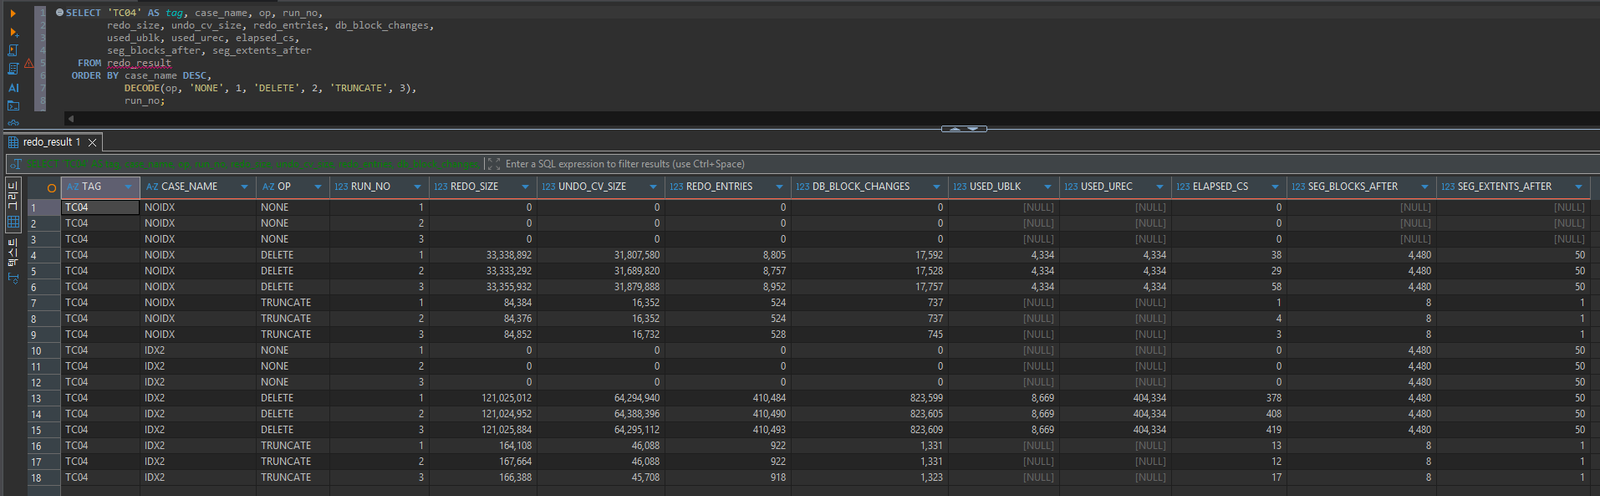
대조군 6회는 네 가지 통계가 모두 0이었습니다. 측정 블록 자체가 남긴 Redo는 없다는 뜻입니다. 같은 작업을 3회 반복한 값도 거의 같았습니다. 인덱스가 없을 때 DELETE의 redo size는 33,333,292~33,355,932바이트, TRUNCATE는 84,376~84,852바이트 범위였습니다. 첫 회차의 값이 특별히 크지도 않았습니다.
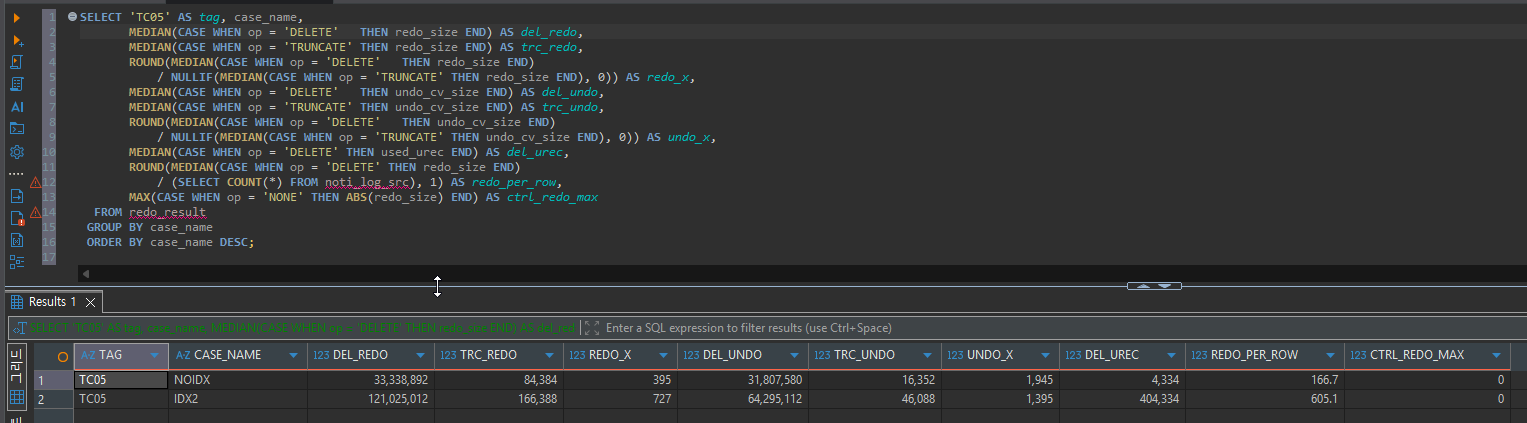
아래 표는 원자료에서 구한 3회 중앙값입니다. 시간 값은 참고용입니다.
| 항목 | DELETE (인덱스 없음) | TRUNCATE (인덱스 없음) | DELETE (인덱스 2개) | TRUNCATE (인덱스 2개) |
|---|---|---|---|---|
redo size | 33,338,892 | 84,384 | 121,025,012 | 166,388 |
undo change vector size | 31,807,580 | 16,352 | 64,295,112 | 46,088 |
redo entries | 8,805 | 524 | 410,490 | 922 |
db block changes | 17,592 | 737 | 823,605 | 1,331 |
USED_UREC | 4,334 | – | 404,334 | – |
| 작업 후 테이블 블록 | 4,480 | 8 | 4,480 | 8 |
| 경과 시간(초) | 0.38 | 0.03 | 4.08 | 0.13 |
DELETE의 Redo는 대부분 Undo를 기록한 것이었다
인덱스가 없을 때 DELETE의 undo change vector size는 30.3MB로, redo size 31.8MB의 약 95%였습니다. 30.3MB는 테이블 세그먼트 35MB와 비슷한 규모입니다. 지운 행의 이미지를 Undo에 남기고, 그 Undo 블록의 변경이 다시 Redo로 기록됐다고 보면 숫자가 맞아떨어집니다. 행당 Redo는 약 166.7바이트로, 평균 행 길이 149바이트보다 조금 큽니다. 네 경우 모두 redo size가 undo change vector size보다 컸습니다.
TRUNCATE의 Undo는 0이 아니었다
인덱스가 없을 때 TRUNCATE도 Redo 84,384바이트와 Undo 16,352바이트를 만들었습니다. “TRUNCATE는 Undo가 없다”는 말은 이 측정에서는 맞지 않습니다. 이 양은 행 데이터가 아니라 세그먼트 정보와 익스텐트 해제 같은 딕셔너리 변경분으로 추정됩니다. 공간 처리도 달랐습니다. DELETE 뒤에도 테이블은 4,480블록과 50개 익스텐트를 그대로 유지했고, TRUNCATE 뒤에는 8블록, 1개 익스텐트로 줄었습니다.
인덱스 2개가 바꾼 것
인덱스 2개가 붙자 DELETE의 Redo는 31.8MB에서 115.4MB로 약 3.6배가 됐습니다. Undo는 약 2.0배로 늘었습니다. redo entries는 8,805에서 410,490으로 늘었는데, 지워야 할 인덱스 엔트리 40만 개와 비슷한 규모입니다. Redo에서 Undo를 뺀 나머지도 약 1.5MB에서 약 54.1MB로 커졌습니다. 두 인덱스 세그먼트를 합쳐도 8MB인데, 인덱스 엔트리를 지우는 데 Undo만 약 31.0MB가 더해졌습니다. 계산하면 엔트리당 약 81바이트입니다.
TRUNCATE도 처리할 세그먼트가 1개에서 3개로 늘자 Redo는 약 2.0배, Undo는 약 2.8배가 됐습니다. 그 결과 Redo 배율은 395배에서 727배로 벌어졌고, Undo 배율은 1,945배에서 1,395배로 오히려 좁혀졌습니다.
DELETE의 경과 시간 중앙값은 0.38초에서 4.08초로 늘었습니다. 다만 인덱스가 있을 때는 DELETE 한 번에 Redo가 115MB를 넘습니다. 200MB 로그 3개 구성에서는 측정 중 로그 스위치가 섞였을 수 있으므로, 시간은 참고값으로만 봅니다.
USED_UREC 4,334는 행 수가 아니라 블록 수였다
세 번째 가설에서는 인덱스가 없을 때 USED_UREC가 200,000일 것으로 예상했습니다. 실제 값은 4,334였습니다. 인덱스가 있을 때는 404,334였는데, 이는 정확히 4,334 + 400,000입니다. 인덱스 쪽은 엔트리 하나당 Undo 레코드 하나라는 예상과 맞았습니다. 예상과 다른 것은 테이블 쪽뿐이었습니다. 그래서 4,334가 데이터 블록 수인지 확인했습니다.
SELECT 'TC08' AS tag,
       COUNT(*) AS row_cnt,
       COUNT(DISTINCT DBMS_ROWID.ROWID_RELATIVE_FNO(rowid) || '.' ||
                      DBMS_ROWID.ROWID_BLOCK_NUMBER(rowid)) AS used_blocks,
       ROUND(COUNT(*) / COUNT(DISTINCT DBMS_ROWID.ROWID_RELATIVE_FNO(rowid) || '.' ||
                                       DBMS_ROWID.ROWID_BLOCK_NUMBER(rowid)), 1) AS rows_per_block
  FROM noti_log;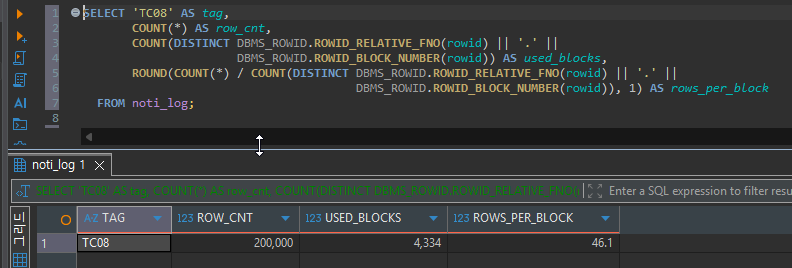
20만 행은 4,334개 블록에 블록당 평균 46.1행씩 들어 있었습니다. 한 문장으로 테이블 전체를 지울 때, 테이블 쪽 Undo 레코드는 행마다 만들어지지 않고 블록 하나당 하나로 묶여 기록됐습니다. 인덱스가 없을 때 USED_UBLK도 4,334였습니다.
한 행씩 지우면 어떻게 되는가
그렇다면 같은 20만 건을 루프로 한 행씩 지우면 어떻게 될까요. 삭제 방식만 바꿔 1회 측정했습니다. 이 측정은 실습 USER를 정리한 뒤 같은 SEED로 다시 만든 환경에서 했습니다. 블록 수가 4,334로 같았고, 뒤의 ROLLBACK 대조에서도 USED_UREC가 4,334로 나와 같은 데이터 배치가 재현된 것을 확인했습니다. 앞뒤 스냅샷, V$TRANSACTION 조회, COMMIT은 앞의 측정 블록과 같고, 삭제 부분만 아래처럼 바꿨습니다.
FOR r IN (SELECT rowid AS rid FROM noti_log) LOOP
  DELETE FROM noti_log WHERE rowid = r.rid;
END LOOP;| 항목 | 한 문장 DELETE (3회 중앙값) | 한 행씩 DELETE (1회) |
|---|---|---|
USED_UREC | 4,334 | 200,000 |
USED_UBLK | 4,334 | 6,453 |
redo size | 33,338,892 | 83,398,020 |
undo change vector size | 31,807,580 | 50,768,232 |
| 경과 시간(초) | 0.38 | 6.09 |
Undo 레코드 수가 행 수와 같아졌고, Redo는 약 2.5배, Undo는 약 1.6배가 됐습니다. 지운 데이터는 같은데 기록 단위가 블록에서 행으로 바뀌었습니다. 그만큼 레코드마다 붙는 부가 정보가 늘어난 결과로 추정됩니다.
되돌릴 수 있는 Undo와 되돌릴 수 없는 Undo
마지막으로 두 작업 뒤에 각각 ROLLBACK을 실행해 Undo가 실제로 무엇을 되살리는지 확인했습니다.
처음에는 DELETE도 되돌아오지 않았다
첫 시도에서는 DELETE 후 ROLLBACK을 했는데 0건이 나왔습니다. 원인 후보는 세 가지였습니다. DBeaver의 자동 커밋 모드, 재적재 구간 누락, 다른 세션에서의 실행입니다. DELETE 직후 아래 조회를 넣어 트랜잭션이 남아 있는지 확인했고, 원인은 자동 커밋이었습니다. DELETE가 실행 즉시 커밋돼 ROLLBACK할 트랜잭션이 없었던 것입니다. 측정 블록은 내부에서 직접 COMMIT하고 V$TRANSACTION도 블록 안에서 읽기 때문에, 이 문제와 상관없이 앞의 측정값은 유효합니다.
SELECT t.used_ublk, t.used_urec
  FROM v$transaction t
  JOIN v$session s ON s.saddr = t.ses_addr
 WHERE s.sid = TO_NUMBER(SYS_CONTEXT('USERENV', 'SID'));
수동 커밋 모드로 바꿔 다시 실행했습니다. 이번에는 커밋 전 트랜잭션에 USED_UBLK 4,334, USED_UREC 4,334가 남아 있었고, ROLLBACK 후 200,000건이 그대로 돌아왔습니다. 같은 절차로 TRUNCATE 후 ROLLBACK을 하면 0건이었습니다. TRUNCATE가 만든 16,352바이트의 Undo에는 행을 되살릴 정보가 없다는 해석과 맞는 결과입니다.
Undo 데이터파일은 100MB에서 550MB가 됐다
실습 전후로 UNDOTBS1 데이터파일 크기는 100MB에서 550MB로 늘었습니다. 측정한 DELETE 6회의 USED_UBLK만 더해도 39,009블록이고, 8KB 블록 기준으로 약 304.8MB입니다. 자동 커밋으로 실패했던 첫 ROLLBACK 대조의 DELETE까지 합하면 약 338.6MB입니다. 550MB와의 나머지 차이는 이번 측정 범위 밖이라 확인하지 못했습니다.
제 판단으로는, undo_retention 때문에 커밋된 Undo를 바로 재사용하지 못하고 데이터파일을 확장한 결과로 보입니다. Undo 데이터파일은 한번 커지면 자동으로 줄어들지 않으므로, 실습 USER를 DROP해도 이 크기는 그대로 남습니다.
TRUNCATE와 DELETE 사이에서 볼 것
판단 기준
- 테이블 전체를 비우고 되돌릴 필요가 없다면, Redo와 Undo 측면에서는 TRUNCATE가 압도적으로 가볍습니다. 다만 TRUNCATE는 DDL이라 실행 즉시 커밋되고 ROLLBACK으로 되돌릴 수 없습니다. 활성화된 FK가 참조하는 부모 테이블에는 실행되지 않습니다.
- DELETE를 써야 한다면 Undo 공간을 테이블 데이터 크기 이상으로 잡아야 합니다. 인덱스가 있으면 엔트리 수만큼 더 필요합니다. 이번 데이터와 인덱스 구성에서는 엔트리당 약 81바이트가 더해졌습니다.
- 대량 삭제를 PL/SQL 루프로 한 행씩 처리하면, 같은 데이터에서도 Redo가 약 2.5배였습니다. 배치 코드의 삭제 방식이 Redo 양을 직접 바꿉니다.
- ARCHIVELOG 모드인 운영 DB라면 DELETE의 Redo는 그대로 아카이브 로그 양이 됩니다. Data Guard 같은 구성에서는 전송량이 됩니다.
조건이 달라지면 결과가 바뀔 수 있는 지점
- 이번 테이블은 APPEND로 적재해 블록당 46.1행으로 빽빽했습니다. 일반 INSERT와 UPDATE로 채워진 테이블은 블록 수가 달라 테이블 쪽 Undo 레코드 수도 달라질 수 있습니다.
- WHERE 조건으로 일부만 지우는 DELETE에서도 블록 단위 기록이 유지되는지는 확인하지 않았습니다.
- 복제 도구 사용 등으로 보조 로깅이 켜진 DB에서는 DELETE의 Redo가 더 늘어날 수 있습니다.
- TRUNCATE는 세그먼트가 1개에서 3개가 되자 Redo가 약 2배가 됐습니다. 파티션, LOB, 인덱스가 많은 테이블에서는 TRUNCATE의 Redo도 더 커질 수 있습니다. REUSE STORAGE 옵션은 측정하지 않았습니다.
운영에서 추가로 확인할 것
- Undo 테이블스페이스의 여유 공간과 자동 확장 최대치
V$UNDOSTAT의TUNED_UNDORETENTION: 자동 튜닝 때문에 실제 보존 시간이 파라미터 값과 다를 수 있습니다.- 대량 DELETE가 도는 시간대의 로그 스위치 빈도
이 테스트의 한계
동시 부하가 없는 단일 세션에서 측정했습니다. 데이터 규모는 20만 건 한 가지이고, XE의 CPU와 메모리 제한 안에서 측정했습니다. DB는 NOARCHIVELOG였고, 한 행씩 삭제한 경우는 1회만 측정했습니다. 경과 시간은 로그 스위치와 캐시 상태의 영향을 받았을 수 있습니다.
전체 삭제의 Redo를 키운 것은 건수보다 인덱스와 삭제 방식이었다
같은 20만 건, 같은 35MB 테이블이었습니다. TRUNCATE는 84,384바이트의 Redo로 끝났지만 0은 아니었습니다. DELETE의 Redo는 31.8MB였고, 그중 95%가 Undo를 위한 기록이었습니다. 테이블 쪽 Undo는 행 단위가 아니라 4,334개 블록 단위로 묶였습니다. 반면 인덱스 엔트리 40만 개는 하나씩 기록됐고, 그것만으로 Redo가 115.4MB까지 늘었습니다. 같은 행을 루프로 지우면 블록 단위로 묶이는 효과도 사라졌습니다. 대량 삭제의 비용을 행 수만으로 추정하면 빗나갑니다. 테이블에 걸린 인덱스 수와 삭제 SQL의 형태를 함께 봐야 합니다.

댓글 0
첫 댓글을 남겨보세요.