BLOCKING_SESSION만 보면 엉뚱한 세션을 정리합니다: Oracle 차단 체인에서 원인 세션 찾는 SQL
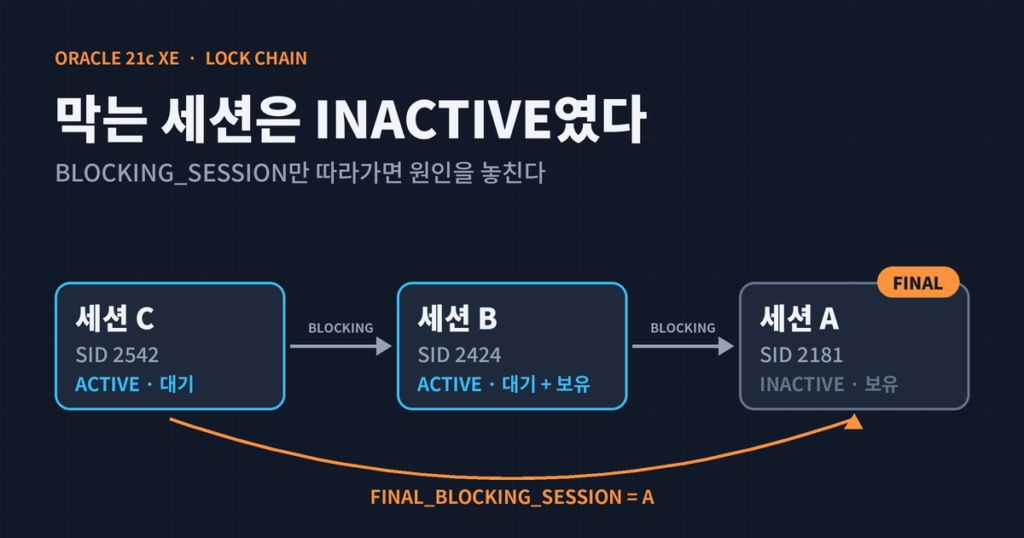
세션 C의 BLOCKING_SESSION은 2424, FINAL_BLOCKING_SESSION은 2181이었습니다. 같은 V$SESSION 한 행에서 두 컬럼이 서로 다른 세션을 가리킨 것입니다. C를 멈추게 한 직접 원인은 2424번 세션이지만, 2424번 역시 다른 세션을 기다리고 있었습니다. 차단의 출발점은 아무 SQL도 실행하지 않고 INACTIVE 상태로 있던 2181번이었습니다.
Oracle 21c XE에서 세 세션이 한 줄로 막히는 차단 체인을 만들고, V$SESSION, V$SQL, V$LOCK, V$LOCKED_OBJECT, V$TRANSACTION을 차례로 조회했습니다. 어느 세션이 원인인지, 어떤 행에서 막혔는지, 원인 세션이 COMMIT하면 체인이 어떻게 바뀌는지를 실측 결과로 정리합니다.
세 세션이 한 줄로 막히도록 만든 실습 구성
검색으로 찾을 수 있는 차단 세션 예제는 대부분 A가 B를 막는 두 세션 구조입니다. 이 구조에서는 BLOCKING_SESSION만 봐도 원인이 바로 나옵니다. 하지만 실제 장애에서는 대기 중인 세션이 다시 다른 세션을 막는 체인이 흔하기 때문에, 이번에는 세 세션이 한 줄로 이어지도록 설계했습니다.
| 항목 | 내용 |
|---|---|
| DB | Oracle Database 21c Express Edition, PDB XEPDB1 |
| 도구 | DBeaver, 편집기 4개를 각각 별도 연결과 수동 커밋 모드로 사용 |
| 테스트 USER | BLK_LAB32 (실습용 가상 시나리오) |
| 테이블 | PICKING_TASK 2,000건, PK(task_id) |
| 세션 역할 | A·B·C는 UPDATE, D는 관찰 전용 |
잠금 진단은 데이터 양과 관계가 없지만, 2,000건 중 막힌 행 하나를 ROWID로 찾아내는 과정을 보여 주기 위해 3행짜리 테이블보다 큰 규모로 정했습니다. 테스트 USER는 SYSTEM으로 XEPDB1에 접속해 만들었습니다. V$ 뷰를 조회하려고 SELECT ANY DICTIONARY를 부여했는데, 범위가 넓은 권한이라 실습 후 USER를 삭제하는 테스트 환경에서만 사용했습니다.
CREATE USER blk_lab32 IDENTIFIED BY "Lab32#Pass"
    DEFAULT TABLESPACE users
    QUOTA 50M ON users;

GRANT CREATE SESSION, CREATE TABLE TO blk_lab32;
GRANT SELECT ANY DICTIONARY TO blk_lab32;
CREATE TABLE picking_task (
task_id NUMBER NOT NULL,
zone_code VARCHAR2(10) NOT NULL,
status VARCHAR2(20) NOT NULL,
handled_by VARCHAR2(10),
pick_qty NUMBER NOT NULL,
created_at DATE NOT NULL,
CONSTRAINT pk_picking_task PRIMARY KEY (task_id)
);
INSERT INTO picking_task (task_id, zone_code, status, handled_by, pick_qty, created_at)
SELECT
LEVEL,
'Z' || LPAD(MOD(LEVEL, 8) + 1, 2, '0'),
'READY',
NULL,
MOD(LEVEL, 5) + 1,
DATE '2026-10-01' + MOD(LEVEL, 10)
FROM dual
CONNECT BY LEVEL <= 2000;
COMMIT;DBeaver에서 같은 USER로 편집기를 여러 개 열면, V$SESSION에서 어느 행이 어느 편집기인지 구분하기 어렵습니다. 그래서 각 편집기에서 DBMS_SESSION.SET_IDENTIFIER로 이름표를 붙이고, 진단 쿼리는 모두 CLIENT_IDENTIFIER로 걸렀습니다. 운영에서 애플리케이션이 이 값을 설정해 두면 같은 방식으로 세션을 추적할 수 있습니다.
ALTER SESSION SET CURRENT_SCHEMA = BLK_LAB32;

BEGIN
    DBMS_SESSION.SET_IDENTIFIER('LAB32_A');
END;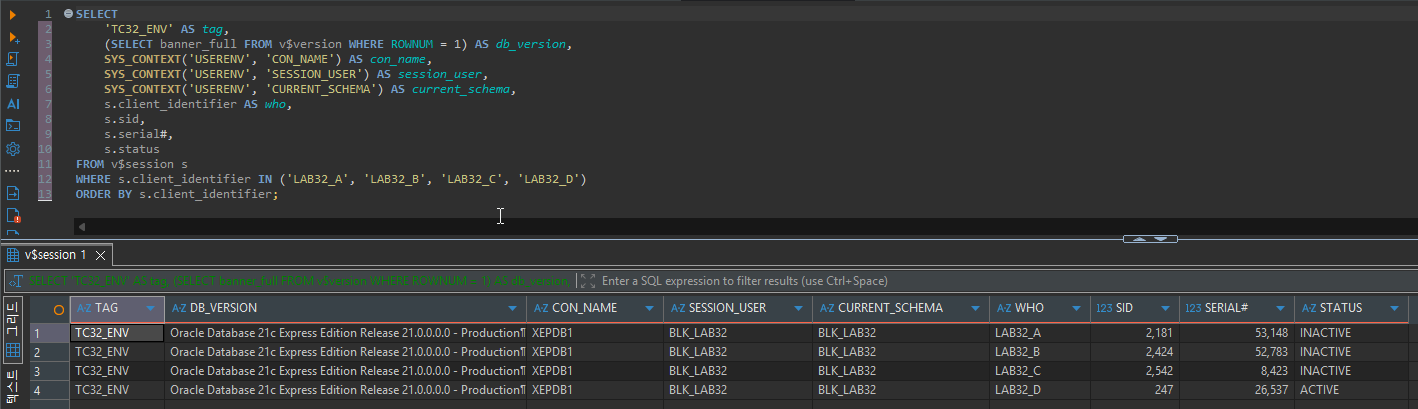
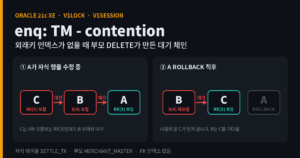
세션별 UPDATE 순서는 다음과 같습니다. B는 202번을 먼저 잡은 상태에서 101번을 기다리므로, 대기 세션이면서 동시에 차단 세션이 됩니다.
| 순서 | 세션 | 실행 내용 | 결과 |
|---|---|---|---|
| 1 | A (2181) | 101번 UPDATE, COMMIT 안 함 | 즉시 완료 |
| 2 | B (2424) | 202번 UPDATE | 즉시 완료 |
| 3 | B (2424) | 101번 UPDATE | A를 기다리며 멈춤 |
| 4 | C (2542) | 202번 UPDATE | B를 기다리며 멈춤 |
-- 세션 A
UPDATE picking_task
SET status = 'HOLD_A', handled_by = 'A', pick_qty = pick_qty + 1
WHERE task_id = 101;

-- 세션 B (두 문장을 순서대로)
UPDATE picking_task
SET status = 'B_FIRST', handled_by = 'B', pick_qty = pick_qty + 100
WHERE task_id = 202;

UPDATE picking_task
SET status = 'B_SECOND', handled_by = 'B', pick_qty = pick_qty + 10
WHERE task_id = 101;

-- 세션 C
UPDATE picking_task
SET status = 'C_LAST', handled_by = 'C', pick_qty = pick_qty + 1000
WHERE task_id = 202;
V$SESSION 한 번으로 보이는 직접 차단자와 최종 차단자
B와 C가 멈추고 잠시 뒤, 관찰 세션 D에서 세 세션의 대기 상태를 조회했습니다.
SELECT
    s.client_identifier AS who,
    s.sid,
    s.status,
    s.state,
    s.event,
    ROUND(s.wait_time_micro / 1000000, 1) AS wait_sec,
    s.last_call_et,
    s.blocking_session_status AS blk_status,
    s.blocking_session AS blk_sid,
    s.final_blocking_session_status AS final_status,
    s.final_blocking_session AS final_sid
FROM v$session s
WHERE s.client_identifier IN ('LAB32_A', 'LAB32_B', 'LAB32_C')
ORDER BY s.client_identifier;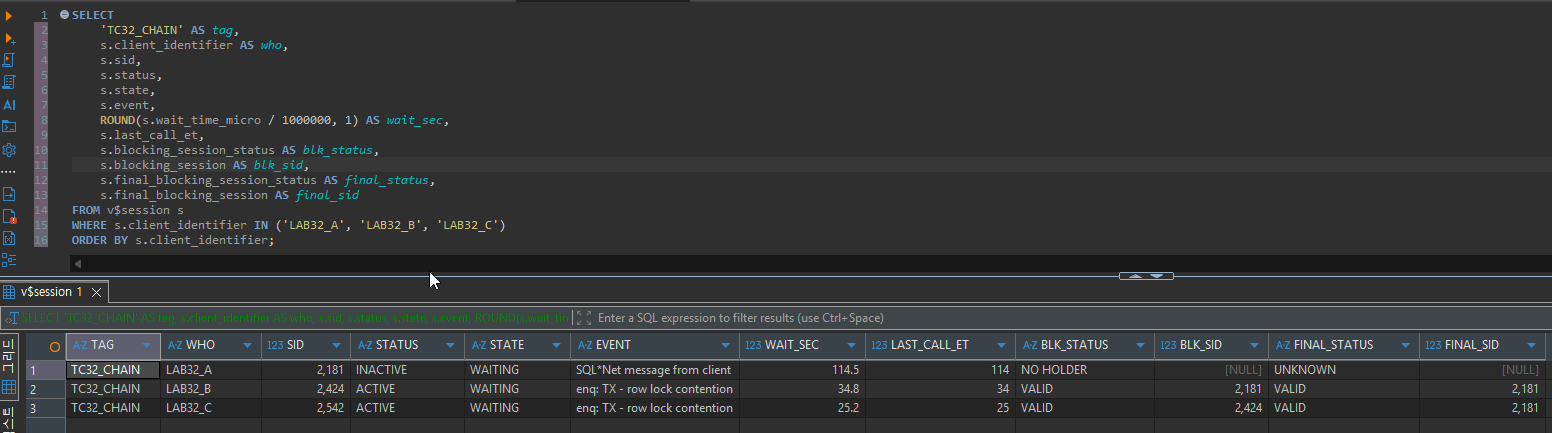
| 세션 | STATUS | EVENT | WAIT_SEC | BLK_SID | FINAL_SID |
|---|---|---|---|---|---|
| A (2181) | INACTIVE | SQL*Net message from client | 114.5 | NULL (NO HOLDER) | NULL (UNKNOWN) |
| B (2424) | ACTIVE | enq: TX – row lock contention | 34.8 | 2181 | 2181 |
| C (2542) | ACTIVE | enq: TX – row lock contention | 25.2 | 2424 | 2181 |
C 행만 보고 BLOCKING_SESSION을 따라가면 B를 원인으로 판단하게 됩니다. B를 정리하면 202번 행은 풀리지만, 101번을 쥐고 있는 A는 그대로 남습니다. FINAL_BLOCKING_SESSION은 체인을 끝까지 따라간 결과를 바로 보여 주므로, 원인 세션을 찾을 때는 이 컬럼을 먼저 봐야 합니다.
STATE가 WAITING인 A를 대기 세션으로 읽지 않습니다
A의 STATE도 WAITING으로 나왔습니다. 처음 보면 A 역시 무언가를 기다린다고 오해하기 쉽습니다. 하지만 A의 EVENT는 SQL*Net message from client로, 클라이언트의 다음 요청을 기다리는 유휴 대기입니다. A의 WAIT_SEC 114.5와 LAST_CALL_ET 114가 거의 같다는 점도, A가 마지막 호출 이후 아무 일도 하지 않고 트랜잭션만 열어 둔 상태임을 보여 줍니다.
같은 관계를 계층 쿼리로 그리면 체인이 한눈에 보입니다.
SELECT
    LPAD(' ', 2 * (LEVEL - 1)) || who || ' (SID ' || sid || ')' AS chain,
    status,
    event
FROM (
    SELECT sid, blocking_session, client_identifier AS who, status, event
    FROM v$session
    WHERE client_identifier IN ('LAB32_A', 'LAB32_B', 'LAB32_C')
)
START WITH blocking_session IS NULL
CONNECT BY PRIOR sid = blocking_session;| CHAIN | STATUS | EVENT |
|---|---|---|
| LAB32_A (SID 2181) | INACTIVE | SQL*Net message from client |
| LAB32_B (SID 2424) | ACTIVE | enq: TX – row lock contention |
| LAB32_C (SID 2542) | ACTIVE | enq: TX – row lock contention |
막는 세션의 SQL은 PREV_SQL_ID로도 찾을 수 없었습니다
원인 세션을 찾았다면 다음 질문은 “A가 무엇을 실행했는가”입니다. 실행 중인 SQL이 없는 세션은 PREV_SQL_ID로 직전 SQL을 보라는 조언이 많아서, V$SQL과 함께 조회했습니다.
SELECT
    s.client_identifier AS who,
    s.sid,
    s.status,
    s.sql_id,
    SUBSTR(cur.sql_text, 1, 90) AS current_sql,
    s.prev_sql_id,
    SUBSTR(prv.sql_text, 1, 90) AS prev_sql
FROM v$session s
LEFT JOIN v$sql cur
    ON cur.sql_id = s.sql_id
   AND cur.child_number = s.sql_child_number
LEFT JOIN v$sql prv
    ON prv.sql_id = s.prev_sql_id
   AND prv.child_number = s.prev_child_number
WHERE s.client_identifier IN ('LAB32_A', 'LAB32_B', 'LAB32_C')
ORDER BY s.client_identifier;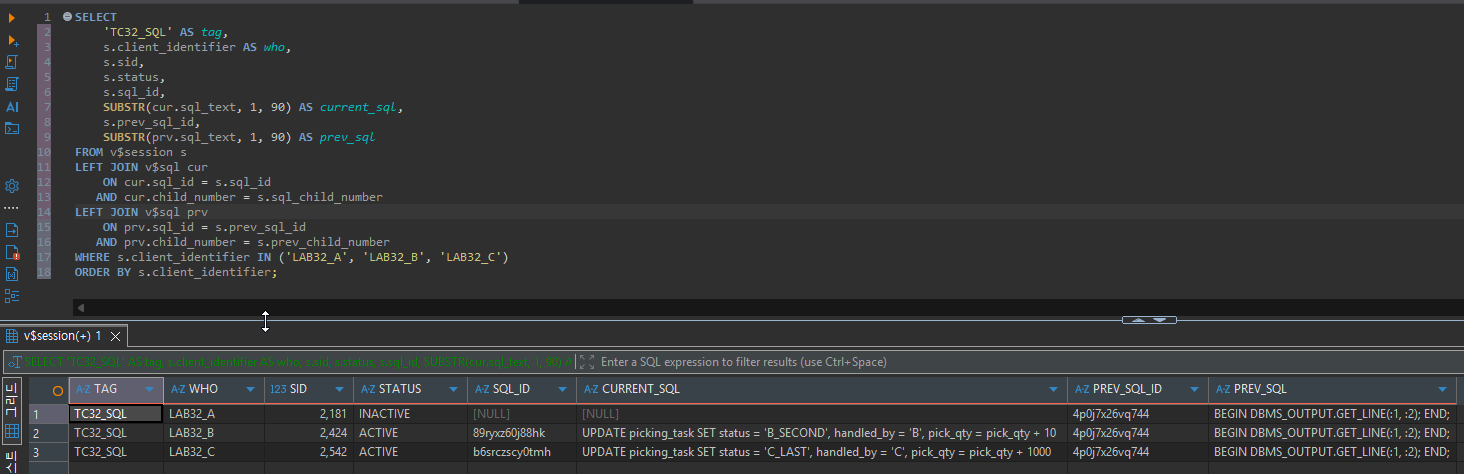
B와 C는 실행 중인 UPDATE가 SQL_ID와 함께 그대로 보입니다. 반면 A는 SQL_ID가 NULL이고, PREV_SQL_ID에도 101번을 바꾼 UPDATE가 아니라 BEGIN DBMS_OUTPUT.GET_LINE(:1, :2); END;가 남아 있었습니다. B와 C의 PREV_SQL_ID도 같은 4p0j7x26vq744였습니다.
이 호출은 실습에서 직접 실행한 문장이 아닙니다. DBeaver가 SQL을 실행한 뒤 서버 출력을 읽으려고 같은 세션에서 보낸 것으로 보입니다. 같은 실습을 처음 시도했을 때는 A의 직전 SQL이 DBeaver의 객체 목록 조회(SELECT DISTINCT OWNER,OBJECT_NAME,OBJECT_TYPE ...)로 나오기도 했습니다. 클라이언트 도구나 커넥션 풀이 사용자 SQL 뒤에 자체 호출을 보내면, PREV_SQL_ID는 그 호출을 가리킵니다.
운영에서도 애플리케이션 프레임워크가 검증 쿼리나 세션 초기화 호출을 보낼 수 있으므로, PREV_SQL_ID만으로 차단 세션의 작업을 판단해서는 안 됩니다. 이번 실습에서 A의 작업을 특정할 수 있었던 근거는 SQL 텍스트가 아니라, 다음에 볼 막힌 행과 트랜잭션 정보였습니다.
어느 행에서 막혔는지 ROWID로 좁히기
대기 세션의 V$SESSION에는 기다리는 행의 위치가 ROW_WAIT_OBJ#, ROW_WAIT_FILE#, ROW_WAIT_BLOCK#, ROW_WAIT_ROW#로 남아 있습니다. 이 값으로 ROWID를 만들어 테이블과 조인하면, 막힌 행을 정확히 꺼낼 수 있습니다.
WITH w AS (
    SELECT
        s.client_identifier AS who,
        s.sid,
        o.object_name,
        s.row_wait_file#,
        s.row_wait_block#,
        s.row_wait_row#,
        DBMS_ROWID.ROWID_CREATE(
            1, o.data_object_id,
            s.row_wait_file#, s.row_wait_block#, s.row_wait_row#
        ) AS waiting_rowid
    FROM v$session s
    JOIN dba_objects o
        ON o.object_id = s.row_wait_obj#
    WHERE s.client_identifier IN ('LAB32_B', 'LAB32_C')
      AND s.event LIKE 'enq: TX%'
)
SELECT
    w.who, w.sid, w.object_name,
    w.row_wait_file#, w.row_wait_block#, w.row_wait_row#,
    w.waiting_rowid,
    p.task_id, p.status, p.handled_by, p.pick_qty
FROM w
LEFT JOIN picking_task p
    ON p.ROWID = w.waiting_rowid
ORDER BY w.who;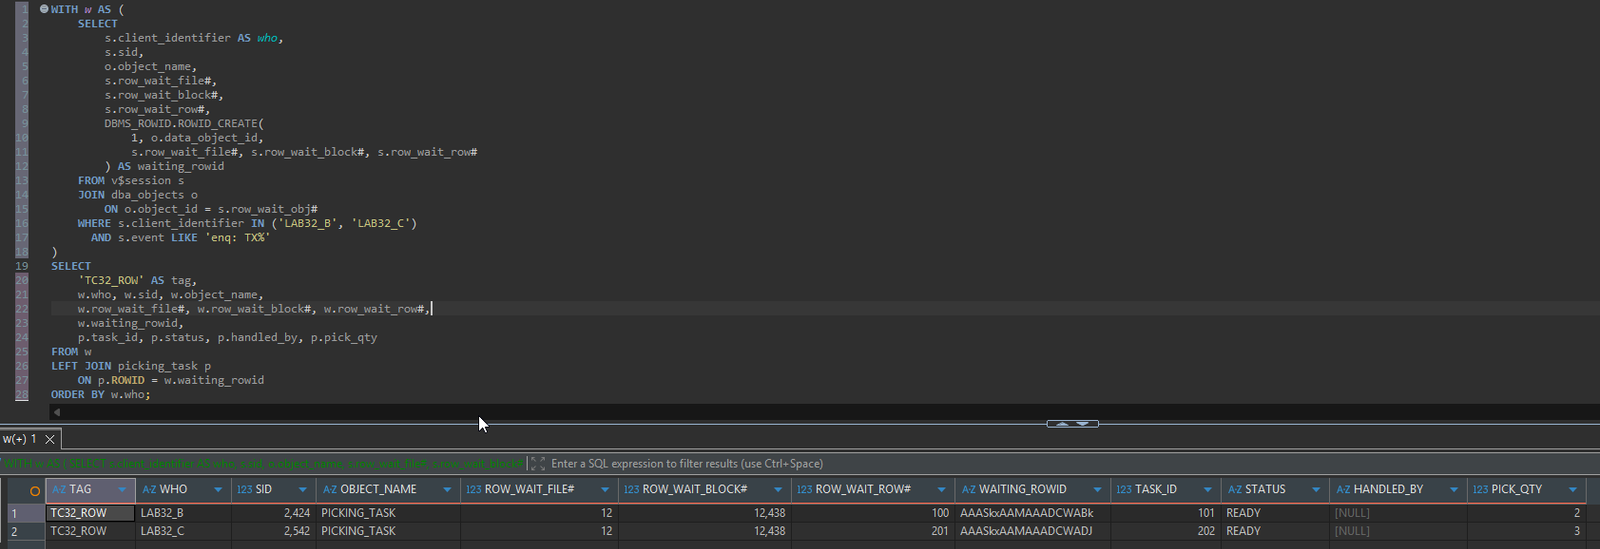
B는 101번, C는 202번 행에서 기다리는 것으로 확인되었습니다. 두 행은 같은 블록(파일 12, 블록 12438)의 100번째와 201번째 슬롯에 있었습니다.
조회된 행 값도 눈여겨볼 만합니다. 관찰 세션 D에는 두 행 모두 READY와 원래 pick_qty(2, 3)로 보였습니다. A와 B가 이미 UPDATE했지만 COMMIT 전이라, D는 마지막으로 커밋된 값을 읽은 것입니다. 이 방법으로 찾은 행 값은 “잠금을 쥔 세션이 바꾸려는 값”이 아니라 “현재 커밋된 값”입니다.
DBMS_ROWID.ROWID_CREATE는 상대 파일 번호를 기대하지만, ROW_WAIT_FILE#은 절대 파일 번호입니다. 이번 XE 환경에서는 두 번호가 같아서 변환 없이 행이 조회되었습니다. 데이터 파일이 많은 운영 DB에서 결과가 비어 있다면, DBA_DATA_FILES의 RELATIVE_FNO로 변환해야 하는지 확인해야 합니다.
V$LOCK에서 B는 보유자이면서 대기자입니다
SELECT
    s.client_identifier AS who,
    l.sid, l.type, l.id1, l.id2,
    l.lmode, l.request, l.ctime, l.block
FROM v$lock l
JOIN v$session s
    ON s.sid = l.sid
WHERE s.client_identifier IN ('LAB32_A', 'LAB32_B', 'LAB32_C')
  AND l.type IN ('TX', 'TM')
ORDER BY s.client_identifier, l.type, l.request;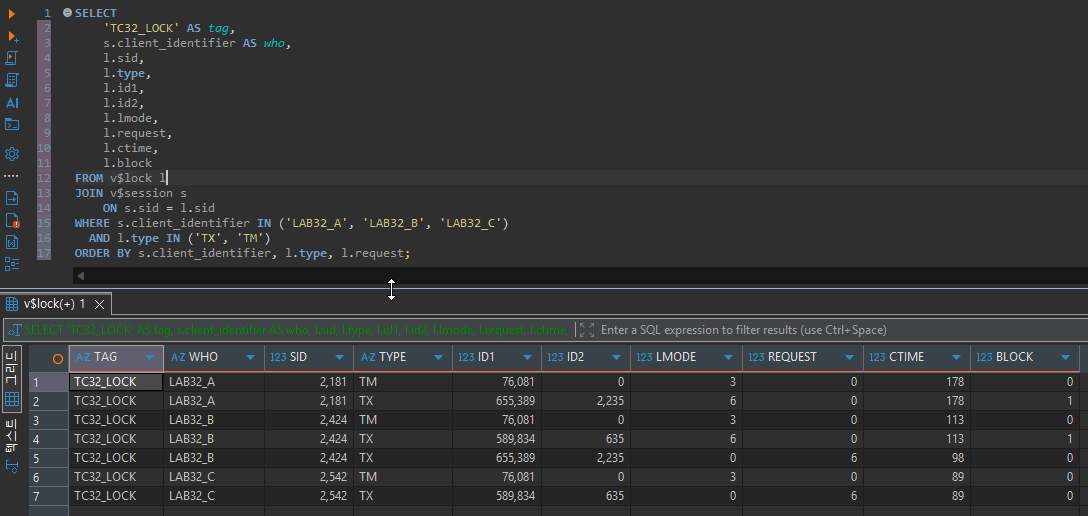
| 세션 | TYPE | ID1 | ID2 | LMODE | REQUEST | BLOCK |
|---|---|---|---|---|---|---|
| A | TM | 76081 | 0 | 3 | 0 | 0 |
| A | TX | 655389 | 2235 | 6 | 0 | 1 |
| B | TM | 76081 | 0 | 3 | 0 | 0 |
| B | TX | 589834 | 635 | 6 | 0 | 1 |
| B | TX | 655389 | 2235 | 0 | 6 | 0 |
| C | TM | 76081 | 0 | 3 | 0 | 0 |
| C | TX | 589834 | 635 | 0 | 6 | 0 |
TM 잠금의 ID1 76081은 USER_OBJECTS에서 조회한 PICKING_TASK의 OBJECT_ID와 같습니다. 세 세션 모두 LMODE 3(Row Exclusive)의 TM을 보유하는데, 이 모드끼리는 호환되므로 여기서 충돌이 일어난 것은 아닙니다.
실제 대기는 TX에서 일어났습니다. 대기 세션의 REQUEST 행과 보유 세션의 LMODE 행은 ID1과 ID2가 같은 값으로 짝지어집니다. B가 요청한 655389/2235는 A가 보유한 TX이고, C가 요청한 589834/635는 B가 보유한 TX입니다. B는 BLOCK 1로 C를 막으면서 동시에 REQUEST 6으로 A를 기다리고 있습니다.
TX의 ID1은 Undo 세그먼트 번호와 슬롯을 합친 값이라, TRUNC(ID1/65536)로 Undo 세그먼트 번호를 꺼낼 수 있습니다. 655389는 10, 589834는 9가 나오며, 아래 V$LOCKED_OBJECT의 XIDUSN과 일치합니다. 캡처마다 CTIME이 다른 것은 조회 시점이 조금씩 달랐기 때문입니다.
V$LOCKED_OBJECT에 나왔다고 잠금 보유자는 아닙니다
잠긴 객체를 찾을 때 자주 쓰는 V$LOCKED_OBJECT도 함께 조회했습니다.
SELECT
    s.client_identifier AS who,
    lo.session_id, lo.xidusn, lo.locked_mode,
    o.object_name
FROM v$locked_object lo
JOIN dba_objects o
    ON o.object_id = lo.object_id
JOIN v$session s
    ON s.sid = lo.session_id
WHERE s.client_identifier IN ('LAB32_A', 'LAB32_B', 'LAB32_C')
ORDER BY s.client_identifier;| 세션 | SESSION_ID | XIDUSN | LOCKED_MODE | OBJECT_NAME |
|---|---|---|---|---|
| A | 2181 | 10 | 3 | PICKING_TASK |
| B | 2424 | 9 | 3 | PICKING_TASK |
| C | 2542 | 0 | 3 | PICKING_TASK |
아무 행도 바꾸지 못하고 기다리기만 하는 C도 LOCKED_MODE 3으로 나왔습니다. 세 세션의 차이는 XIDUSN뿐이었습니다. C는 0인데, 아직 트랜잭션이 시작되지 않아 Undo 세그먼트를 할당받지 않았다는 뜻입니다. 실제로 V$TRANSACTION에는 A와 B만 조회되었습니다.
SELECT
    s.client_identifier AS who,
    s.sid, t.start_time, t.status, t.used_ublk, t.used_urec
FROM v$transaction t
JOIN v$session s
    ON s.taddr = t.addr
WHERE s.client_identifier IN ('LAB32_A', 'LAB32_B', 'LAB32_C')
ORDER BY s.client_identifier;| 세션 | START_TIME | STATUS | USED_UBLK | USED_UREC |
|---|---|---|---|---|
| A (2181) | 10/10/26 20:55:55 | ACTIVE | 1 | 1 |
| B (2424) | 10/10/26 20:57:00 | ACTIVE | 1 | 1 |
V$LOCKED_OBJECT는 “이 테이블을 쓰고 있는 세션 목록”이지 “다른 세션을 막는 세션 목록”이 아닙니다. 차단 여부는 V$SESSION의 차단 컬럼이나 V$LOCK의 BLOCK 값으로 판단해야 합니다.
A가 COMMIT해도 C의 대기는 끝나지 않았습니다
원인 세션 A에서 COMMIT한 직후 체인을 다시 조회했습니다.
SELECT
    s.client_identifier AS who,
    s.sid, s.status, s.event,
    s.blocking_session AS blk_sid,
    s.final_blocking_session AS final_sid,
    s.final_blocking_session_status AS final_status
FROM v$session s
WHERE s.client_identifier IN ('LAB32_A', 'LAB32_B', 'LAB32_C')
ORDER BY s.client_identifier;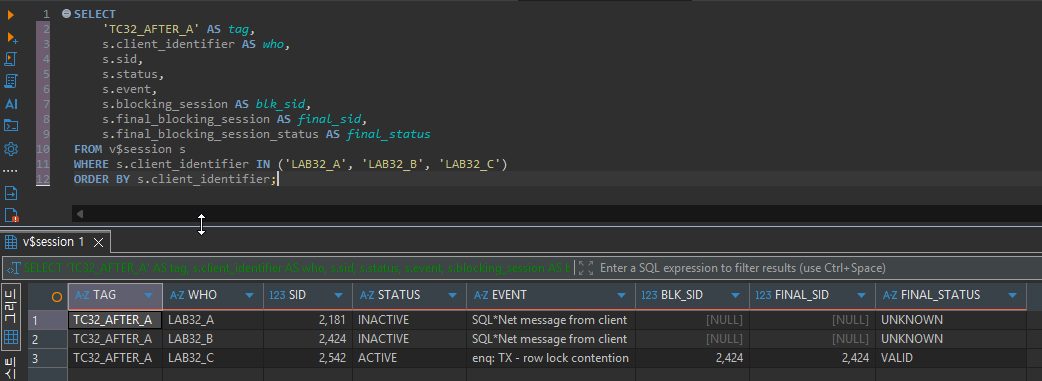
A가 101번을 놓자 B의 두 번째 UPDATE가 끝났고, B는 INACTIVE가 되었습니다. 그런데 B는 아직 COMMIT하지 않아 202번을 계속 쥐고 있으므로, C는 여전히 대기 중입니다. C의 BLOCKING_SESSION과 FINAL_BLOCKING_SESSION은 모두 2424로 바뀌었습니다. 처음 상태에서 A만 정리하면 문제가 끝났다고 판단하기 쉽지만, 체인이 한 단계 짧아졌을 뿐입니다.
B가 COMMIT한 뒤에는 C의 UPDATE가 진행되었습니다. 이때 C가 COMMIT하기 전에 조회하면, 202번은 B_FIRST와 103으로 보이고 남은 TX 잠금은 1개였습니다. C가 COMMIT한 뒤의 최종 값은 다음과 같습니다.
| task_id | STATUS | HANDLED_BY | PICK_QTY | 남은 TX 잠금 |
|---|---|---|---|---|
| 101 | B_SECOND | B | 13 (2 + 1 + 10) | 0 |
| 202 | C_LAST | C | 1,103 (3 + 100 + 1,000) | 0 |
세 세션의 변경이 빠짐없이 순서대로 반영되었습니다. 대기 세션은 앞선 트랜잭션이 확정한 값을 기준으로 계산을 이어 갔습니다.
정리할 세션을 고르는 기준과 이 실습의 한계
이번 결과를 운영 판단으로 옮기면 기준은 세 가지입니다. 첫째, 원인 세션은 FINAL_BLOCKING_SESSION으로 찾고, 중간 세션(B)을 정리 대상으로 착각하지 않습니다. 둘째, 원인 세션이 무엇을 했는지는 PREV_SQL_ID가 아니라 막힌 행(ROW_WAIT)과 트랜잭션 시작 시각(V$TRANSACTION)으로 추적하고, 애플리케이션 로그와 대조합니다. 셋째, 세션을 강제로 정리하면 트랜잭션이 롤백되므로 USED_UREC로 롤백할 양을 먼저 확인합니다. 이번에는 1건이라 부담이 없었지만, 대량 변경을 쥔 세션은 롤백에도 시간이 걸립니다.
Oracle의 행 잠금 대기에는 MySQL의 innodb_lock_wait_timeout 같은 기본 제한 시간이 없습니다. 원인 세션이 끝나지 않으면 대기 세션은 계속 기다리고, 체인 뒤에 새 요청이 쌓입니다. 대기 시간을 제한하려면 애플리케이션에서 SELECT ... FOR UPDATE WAIT n 같은 방식을 따로 써야 합니다.
이 실습은 단일 인스턴스 21c XE에서 세 세션, 한 블록 안의 두 행으로 진행했습니다. RAC에서는 차단 세션이 다른 인스턴스에 있을 수 있어 GV$SESSION과 BLOCKING_INSTANCE, FINAL_BLOCKING_INSTANCE를 함께 봐야 합니다. 체인이 갈라지거나 여러 세션이 같은 행을 기다리는 경우도 이번에는 재현하지 않았습니다. PREV_SQL_ID에 나온 호출 역시 DBeaver 기준의 결과이며, 다른 도구나 애플리케이션에서는 다른 SQL이 남을 수 있습니다.
INACTIVE 세션 하나가 체인 전체를 붙잡고 있었습니다
이번 체인의 출발점은 SQL을 실행하지 않고 유휴 대기 중이던 INACTIVE 세션이었습니다. 실행 중인 SQL만 보면 ACTIVE인 B와 C가 문제처럼 보이고, BLOCKING_SESSION만 따라가면 B에서 멈추게 됩니다. FINAL_BLOCKING_SESSION으로 원인 세션을 찾고, ROW_WAIT로 막힌 행을 특정하고, V$LOCK의 ID1·ID2로 보유와 요청을 짝지은 뒤 V$TRANSACTION으로 정리 영향을 확인하는 순서를 따르면, 세션이 멈춘 상황을 “A가 101번 행을 쥔 채 클라이언트 응답을 기다리고 있다”는 구체적인 사실로 바꿀 수 있습니다.

댓글 0
첫 댓글을 남겨보세요.