VARCHAR2 컬럼을 숫자로 비교하면 인덱스가 사라지는 이유: Oracle 21c XE 실행계획 검증
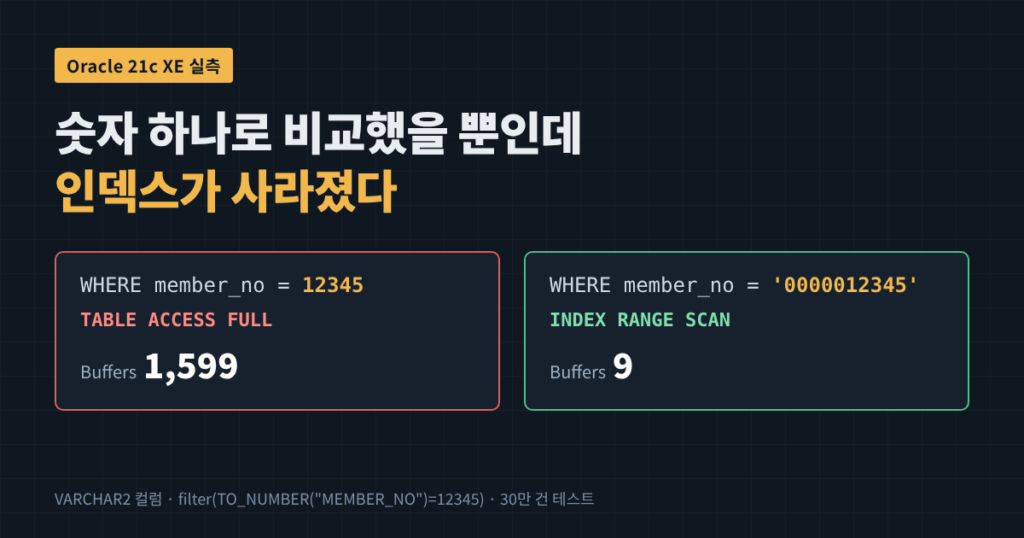
Oracle 21c XE에서 VARCHAR2 컬럼을 숫자와 비교하자 TO_NUMBER가 컬럼에 적용되어 Full Scan으로 1,599블록을 읽었습니다. 문자 비교는 9블록이었습니다. 앞자리 0, ORA-01722, NUMBER 컬럼 반대 비교까지 실측했습니다.
같은 6건, Buffers는 1,599와 9
sql
WHERE member_no = 12345          -- Buffers 1,599
WHERE member_no = '0000012345'   -- Buffers 9
두 SQL은 같은 회원의 거래 6건을 똑같이 돌려줍니다. 결과만 보면 차이가 없습니다. 그런데 실제 실행 통계를 보면 첫 번째 SQL은 테이블 전체를 읽었고, 두 번째 SQL은 인덱스로 9블록만 읽고 끝났습니다.
여기서 확인하려는 질문은 하나입니다. VARCHAR2 컬럼을 숫자와 비교하면 Oracle은 어느 쪽을 변환하고, 그 결과로 인덱스 사용, 읽은 블록 수, 결과 건수, 오류 발생 여부가 어떻게 달라지는가입니다.
테스트 환경과 데이터
| 항목 | 내용 |
|---|---|
| DB | Oracle Database 21c Express Edition Release 21.0.0.0.0 |
| 접속 | DBeaver, PDB XEPDB1, 테스트 전용 사용자 BLOG_CONV |
| 옵티마이저 | optimizer_mode ALL_ROWS, optimizer_features_enable 21.1.0, statistics_level TYPICAL |
| NLS_NUMERIC_CHARACTERS | ., |
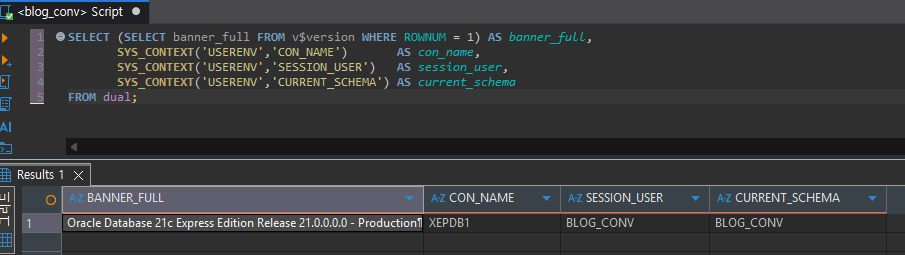
테스트가 21c XE의 XEPDB1에서 BLOG_CONV 사용자와 BLOG_CONV 스키마로 수행되었음을 보여주는 환경 확인 결과입니다.
테이블은 블로그 테스트용 가상 시나리오인 포인트 거래 이력(POINT_TX_HISTORY)입니다. 회원번호 MEMBER_NO를 10자리 문자열로 저장했고, 앞자리는 0으로 채웠습니다. 실무에서 회원번호나 코드값을 VARCHAR2로 두는 경우를 흉내 낸 구조입니다.
sql
CREATE TABLE point_tx_history (
  tx_id      NUMBER(10)   NOT NULL,
  member_no  VARCHAR2(10) NOT NULL,
  tx_type    VARCHAR2(10) NOT NULL,
  point_amt  NUMBER(8)    NOT NULL,
  tx_dt      DATE         NOT NULL,
  CONSTRAINT pk_point_tx_history PRIMARY KEY (tx_id)
);

INSERT /*+ APPEND */ INTO point_tx_history
SELECT rn,
       LPAD(TO_CHAR(MOD(rn - 1, 50000) + 1), 10, '0'),
       CASE MOD(rn, 3) WHEN 0 THEN 'EARN' WHEN 1 THEN 'USE' ELSE 'EXPIRE' END,
       MOD(rn * 37, 10000) + 1,
       DATE '2026-01-01' + MOD(rn, 270)
FROM (SELECT (a.lv - 1) * 300 + b.lv AS rn
      FROM (SELECT LEVEL lv FROM dual CONNECT BY LEVEL <= 1000) a,
           (SELECT LEVEL lv FROM dual CONNECT BY LEVEL <= 300) b);
COMMIT;

CREATE INDEX ix_point_tx_member_no ON point_tx_history (member_no);

BEGIN
  DBMS_STATS.GATHER_TABLE_STATS(ownname => USER, tabname => 'POINT_TX_HISTORY', cascade => TRUE);
END;
데이터는 30만 건입니다. 회원 5만 명이 6건씩 고르게 분포합니다. Full Scan과 Index Scan의 블록 수 차이가 분명히 드러나면서도 XE에서 몇 초 안에 만들어지는 규모라서 이 건수를 골랐습니다. 난수 대신 ROWNUM 계산식을 써서 다시 만들어도 같은 데이터가 나옵니다.
통계 수집 후 상태는 다음과 같습니다.
| 객체 | 주요 값 |
|---|---|
| POINT_TX_HISTORY | NUM_ROWS 300,000, BLOCKS 1,629 |
| PK_POINT_TX_HISTORY | BLEVEL 1, LEAF_BLOCKS 562, CLUSTERING_FACTOR 1,595 |
| IX_POINT_TX_MEMBER_NO | BLEVEL 2, LEAF_BLOCKS 921, DISTINCT_KEYS 50,536, CLUSTERING_FACTOR 300,000 |
IX_POINT_TX_MEMBER_NO의 CLUSTERING_FACTOR가 행 수와 같은 300,000입니다. 한 회원의 6건이 5만 행 간격으로 흩어지도록 만들었기 때문입니다. 인덱스로 찾은 행마다 다른 테이블 블록을 읽어야 하는, 인덱스 입장에서 가장 불리한 배치입니다.
실습 전에 만난 ORA-01031
테이블을 만드는 첫 단계에서 ORA-01031(권한이 불충분합니다)이 발생했습니다. session_privs를 조회하면 BLOG_CONV에는 CREATE TABLE 권한이 분명히 있었습니다. 원인은 DBeaver의 활성 스키마였습니다. 접속 사용자는 BLOG_CONV였지만 현재 스키마는 다른 스키마로 잡혀 있었습니다. 그래서 스키마 이름 없는 CREATE TABLE이 다른 사용자 스키마에 테이블을 만드는 문장으로 해석된 것입니다.
sql
SELECT SYS_CONTEXT('USERENV','SESSION_USER')   AS session_user,
       SYS_CONTEXT('USERENV','CURRENT_SCHEMA') AS current_schema
FROM dual;

ALTER SESSION SET CURRENT_SCHEMA = BLOG_CONV;
현재 스키마를 BLOG_CONV로 바꾼 뒤 같은 CREATE TABLE이 정상 실행되었습니다. 권한이 있는데 ORA-01031이 난다면 SESSION_USER와 CURRENT_SCHEMA를 따로 확인해야 합니다.
실행계획으로 본 네 가지 비교
모든 SQL에 /*+ GATHER_PLAN_STATISTICS */ 힌트를 넣었습니다. 실제 실행 통계는 DBMS_XPLAN.DISPLAY_CURSOR(sql_id, NULL, 'ALLSTATS LAST')로 확인했습니다.
| 구분 | 조건 | 결과 | Operation | Buffers |
|---|---|---|---|---|
| TC01 | VARCHAR2 = 숫자 12345 | 6건 | TABLE ACCESS FULL | 1,599 |
| TC02 | VARCHAR2 = ‘0000012345’ | 6건 | INDEX RANGE SCAN | 9 |
| TC03 | VARCHAR2 = ‘12345’ | 0건 | INDEX RANGE SCAN | 3 |
| TC04 | NUMBER = 문자 ‘150000’ | 1건 | INDEX UNIQUE SCAN | 3 |
VARCHAR2 = 숫자: 함수는 컬럼 쪽에 씌워졌다
sql
SELECT /*+ GATHER_PLAN_STATISTICS */ 'TC01' tc, tx_id, member_no, point_amt
FROM point_tx_history WHERE member_no = 12345;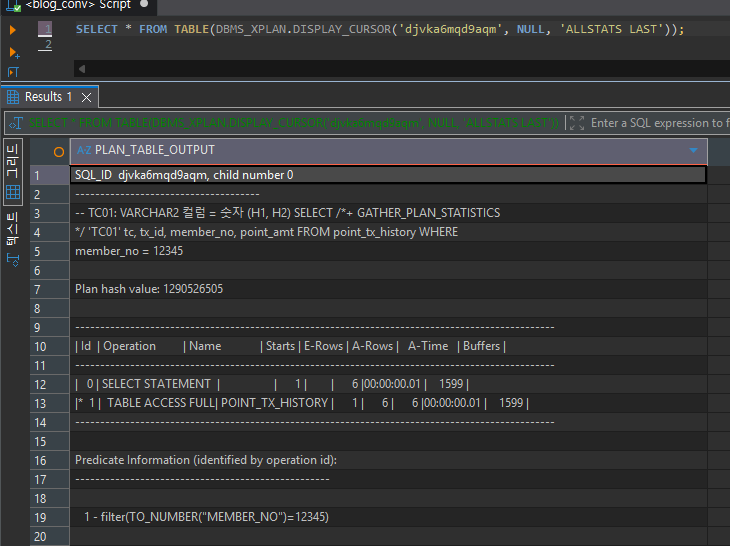
숫자 리터럴과 비교한 TC01이 인덱스를 쓰지 않고 테이블 전체를 읽었으며, 변환 함수가 컬럼에 적용되었음을 보여주는 실제 실행계획입니다.
Predicate Information에는 filter(TO_NUMBER("MEMBER_NO")=12345)가 찍혔습니다. Oracle은 문자와 숫자를 비교할 때 문자 쪽을 숫자로 바꿉니다. 이 SQL에서 문자 쪽은 컬럼이었습니다. IX_POINT_TX_MEMBER_NO는 MEMBER_NO의 원래 문자값으로 정렬되어 있습니다. TO_NUMBER(MEMBER_NO)의 값으로 정렬된 인덱스가 아니므로 이 조건으로는 인덱스를 탐색할 수 없습니다.
Buffers 1,599는 테이블 BLOCKS 1,629와 거의 같습니다. 6건을 찾으려고 테이블을 처음부터 끝까지 읽으면서 모든 행에 TO_NUMBER를 적용한 것입니다(확인됨).
같은 회원을 문자로 비교하면
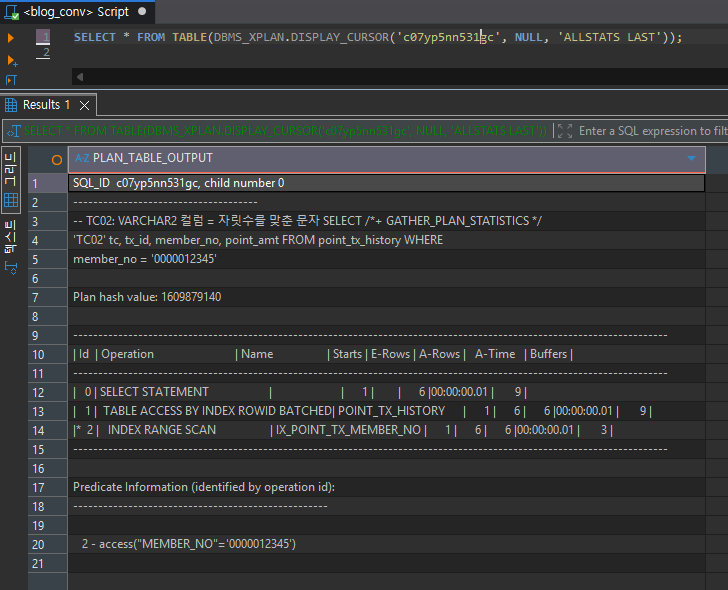
컬럼과 같은 형식의 문자 리터럴로 비교한 TC02가 인덱스 접근 조건으로 처리되어 9블록만 읽었음을 보여주는 실행계획입니다.
조건이 filter가 아닌 access("MEMBER_NO"='0000012345')로 바뀌었습니다. 인덱스 탐색에 3블록, 전체 9블록을 읽었습니다. 테이블 쪽 6블록은 6건이 서로 다른 블록에 흩어져 있어서 행마다 한 블록씩 읽은 것으로 보입니다. CLUSTERING_FACTOR 300,000과도 맞는 결과입니다(추정). 가장 불리한 클러스터링에서도 6건 조회는 Full Scan보다 약 178배 적게 읽었습니다.
앞자리 0을 빼면 0건
sql
SELECT /*+ GATHER_PLAN_STATISTICS */ 'TC03' tc, tx_id, member_no, point_amt
FROM point_tx_history WHERE member_no = '12345';
이 SQL은 인덱스를 3블록 읽고 0건을 돌려줬습니다. 문자열 ‘12345’와 ‘0000012345’는 다른 값이기 때문입니다. 반면 TC01은 ‘0000012345’를 숫자 12345로 바꿔 비교했으므로 6건이 정상으로 나왔습니다.
이 차이가 숫자 비교가 오래 방치되는 이유라고 봅니다. 결과가 맞게 나오니 기능 테스트에서는 걸리지 않습니다. 문자로 고치려다 앞자리 0을 빠뜨리면 오히려 0건이 나와서, 숫자 비교가 맞는 것처럼 보이기도 합니다. 고칠 때는 따옴표만 붙일 게 아니라 컬럼에 저장된 형식 그대로의 값을 넘겨야 합니다.
반대 방향: NUMBER 컬럼 = 문자
“타입이 다르면 인덱스를 못 탄다”는 말이 늘 맞는지 확인하려고 방향을 뒤집었습니다.
sql
SELECT /*+ GATHER_PLAN_STATISTICS */ 'TC04' tc, tx_id, member_no, point_amt
FROM point_tx_history WHERE tx_id = '150000';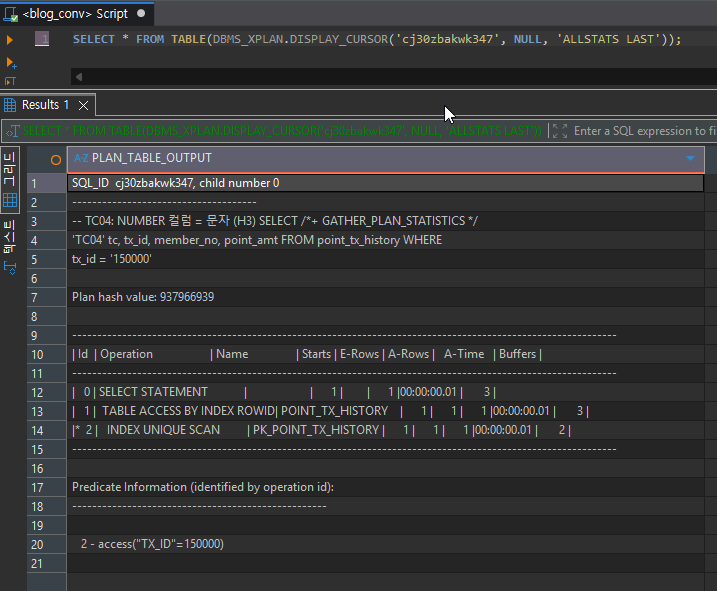
NUMBER 컬럼을 문자 리터럴과 비교했을 때 변환이 리터럴 쪽에서 일어나 PK 인덱스를 정상적으로 사용했음을 보여주는 실행계획입니다.
Predicate는 access("TX_ID"=150000)이고, 따옴표가 사라졌습니다. 이번에는 문자 쪽이 리터럴이라 리터럴이 숫자로 바뀌었고, 컬럼은 그대로 남아 PK 인덱스를 썼습니다. 타입 불일치라는 사실 자체보다 변환이 어느 쪽에 적용되느냐가 인덱스 사용을 결정했습니다(21c XE에서 확인됨).
V$SQL에 같은 SQL이 두 번씩 나온 이유
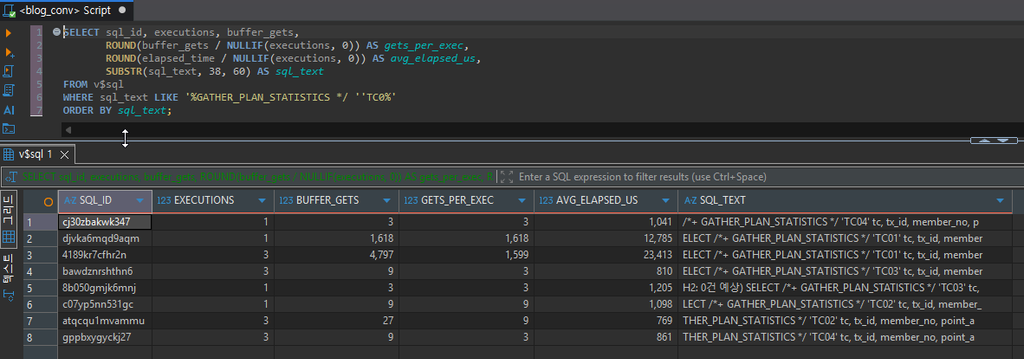
TC01~TC04의 실행 횟수, 실행당 Buffer Gets, 평균 경과시간을 V$SQL에서 비교한 결과입니다. 같은 테스트가 주석 차이로 SQL_ID 두 개로 나뉜 것도 보입니다.
SQL_ID를 찾으려고 처음 작성한 조회 조건은 sql_text LIKE 'SELECT /*+ GATHER_PLAN_STATISTICS */ ''TC0%'였는데, 결과가 0건이었습니다. DBeaver가 SQL 위에 적어 둔 주석 줄까지 함께 서버로 보냈기 때문입니다. 그래서 SQL_TEXT가 SELECT가 아니라 -- TC01: ... 같은 주석으로 시작했습니다. 조건을 LIKE '%GATHER_PLAN_STATISTICS */ ''TC0%'로 바꾸고 나서야 조회되었습니다.
같은 이유로 테스트마다 SQL_ID가 두 개씩 생겼습니다. 본문은 같아도 앞의 주석이 다르면 Oracle은 다른 SQL로 다룹니다.
| 구분 | 실행 | 실행당 Buffer Gets | 평균 경과시간(μs) |
|---|---|---|---|
| TC01 | 1회 / 3회 | 1,618 / 1,599 | 12,785 / 23,413 |
| TC02 | 1회 / 3회 | 9 / 9 | 1,098 / 769 |
| TC03 | 1회 / 3회 | 3 / 3 | 1,205 / 810 |
| TC04 | 1회 / 3회 | 3 / 3 | 1,041 / 861 |
TC01 첫 실행의 1,618과 실행계획 Buffers 1,599의 차이 19는 하드 파스 때 수행된 재귀 SQL 몫으로 추정합니다. 이번 테스트에서 따로 확인하지는 않았습니다.
경과시간은 판단 근거로 약합니다. DISPLAY_CURSOR의 A-Time은 TC01과 TC02 모두 00:00:00.01로 표시되었습니다. V$SQL 값도 회차별 기록이 아닌 평균이라 중앙값을 낼 수 없었습니다. 30만 건, 로컬 단일 세션에서는 시간 차이가 체감되지 않습니다. 그래서 이 글의 비교 근거는 읽은 블록 수로 잡았습니다.
데이터 한 건이 SQL을 오류로 바꾼다
숫자로 바꿀 수 없는 회원번호를 한 건 넣었습니다.
sql
INSERT INTO point_tx_history VALUES (300001, 'TMP-00001', 'EARN', 100, SYSDATE);
COMMIT;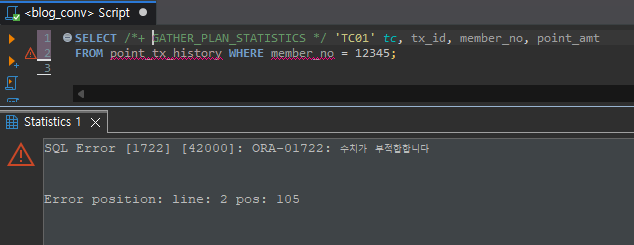
숫자로 변환할 수 없는 값 1건이 들어간 뒤, 조금 전까지 정상이던 숫자 비교 SQL이 ORA-01722로 실패한 화면입니다.
조금 전까지 6건을 잘 돌려주던 TC01이 ORA-01722로 실패했습니다. Full Scan은 모든 행에 TO_NUMBER를 적용하므로 ‘TMP-00001’을 만나는 순간 오류가 납니다. 같은 상태에서 문자 비교인 TC02는 그대로 6건을 돌려줬습니다.
함수 기반 인덱스로 우회할 수 있는지도 시험했습니다.
sql
CREATE INDEX ix_point_tx_member_num ON point_tx_history (TO_NUMBER(member_no));이 문장도 ORA-01722로 실패했습니다. 인덱스를 만들려면 모든 행의 TO_NUMBER 값을 계산해야 하는데, 그 과정에서 같은 값에 걸렸습니다. 컬럼에 숫자가 아닌 값이 하나라도 섞일 수 있다면 TO_NUMBER 함수 기반 인덱스는 해결책이 되지 못합니다.
성능 문제로 보이던 SQL이 데이터 한 건 때문에 장애로 바뀌었습니다. 코드값 체계가 바뀌거나 테스트용 값이 들어가는 순간 터질 수 있는 구조입니다.
운영에서 이 문제를 판단하는 기준
운영 환경에서 묵시적 형변환이 있었는데도 실행계획이 정상적으로 수행된 적이 있고, 타입 불일치로 인덱스 대신 테이블 풀스캔으로 풀린 경험도 있습니다. 이번 실험만 놓고 보면 두 경우를 가르는 요인은 변환이 리터럴이나 바인드 쪽에 걸리는지, 컬럼 쪽에 걸리는지였습니다. 운영 사례가 모두 같은 이유였는지는 이 테스트로 단정할 수 없습니다.
실행계획을 볼 때는 Operation 이름보다 Predicate Information을 먼저 봅니다. 컬럼이 TO_NUMBER, TO_CHAR, INTERNAL_FUNCTION 같은 함수에 감싸여 filter에 있다면 형변환을 의심합니다. 커서 캐시에 남은 SQL 중 후보를 찾을 때는 아래처럼 조회할 수 있습니다.
sql
SELECT p.sql_id, p.object_name, p.filter_predicates
FROM v$sql_plan p
WHERE p.filter_predicates LIKE '%TO_NUMBER("%'
  AND p.object_owner = 'BLOG_CONV';
고치는 순서는 이렇습니다.
- 애플리케이션이 넘기는 리터럴이나 바인드 변수의 타입을 컬럼 타입과 맞춥니다. VARCHAR2 컬럼에는 같은 형식의 문자열을, 이번 데이터라면 앞자리 0까지 포함한 값을 넘깁니다.
- 바인드 변수를 숫자 타입으로 넘기는 경우에도 같은 변환이 생길 수 있습니다. 이번 테스트는 리터럴로만 확인했고 바인드 변수 경로는 재현하지 않았습니다.
- 함수 기반 인덱스는 컬럼에 숫자로 바꿀 수 없는 값이 절대 들어가지 않는다고 보장될 때만 검토합니다. 이번처럼 한 건만 섞여도 생성 자체가 실패합니다.
- 컬럼에 숫자만 들어간다면 컬럼 타입을 NUMBER로 바꾸는 것도 방법입니다. 다만 앞자리 0이 의미를 갖는 값이라면 바꾸면 안 됩니다.
이번 테스트가 말해 주지 않는 것
- 데이터 규모와 시간: 30만 건, 1,629블록 테이블이라 Full Scan도 체감 시간이 거의 없었습니다. 수천만 건 테이블이나 동시 호출이 많은 환경에서는 같은 1,599 대 9의 비율이 CPU와 I/O 부하로 드러날 것으로 봅니다(추정).
- 반환 건수: 한 회원당 6건이라 인덱스가 유리했습니다. 조건에 걸리는 행이 많다면 문자 비교로 바꿔도 Full Scan이 더 나은 경우가 있습니다.
- 바인드 변수와 실행 환경: JDBC 같은 드라이버가 바인드 타입을 정하는 경로는 확인하지 않았습니다. 테스트는 21c XE 단일 세션이며, 운영 19c, RAC, RDS 환경의 수치로 옮겨 해석하지 않았습니다.
결과가 맞는다는 사실이 이 문제를 가장 오래 숨겨 둡니다. 21c XE에서 VARCHAR2 컬럼을 숫자와 비교하자 결과는 6건으로 정확했지만, 컬럼에 TO_NUMBER가 씌워져 인덱스를 잃었습니다. 숫자로 바꿀 수 없는 값 한 건이 들어가자 같은 SQL은 ORA-01722로 멈췄습니다. 반대로 NUMBER 컬럼에 문자를 넘긴 경우는 리터럴 쪽만 바뀌어 인덱스를 그대로 썼습니다. 판단 기준은 타입이 다른지가 아니라, 변환 함수가 컬럼에 걸렸는지를 Predicate에서 확인하는 것입니다.

댓글 0
첫 댓글을 남겨보세요.