PCTFREE 10에서 4,697건이 옮겨 간 UPDATE, MOVE 뒤에도 줄지 않은 인덱스 읽기

배송 완료 처리 UPDATE 한 번이 지나간 뒤
이력 테이블 중에는 행을 먼저 넣어 두고, 처리 결과 컬럼을 나중에 UPDATE로 채우는 구조가 있습니다. 처리 결과가 UPDATE로 추가되는 이력 테이블에 PCTFREE를 20으로 설정한 적이 있습니다. UPDATE 후 행 크기가 늘어나는 것과 공간 사용량을 함께 고려해 정한 값이었습니다.
PCTFREE가 모자라면 길어진 행은 원래 블록에 남지 못하고 다른 블록으로 옮겨 갑니다. 이번에는 같은 UPDATE를 PCTFREE 0, 10, 30인 테이블에 실행했습니다. 그리고 옮겨 간 행이 몇 건인지, 그 행을 읽는 비용이 어느 경로에서 얼마나 늘어나는지, MOVE가 무엇을 되돌리는지를 21c XE에서 확인했습니다.
PCTFREE만 다른 배송 이력 테이블 세 개
Oracle Database 21c Express Edition 21.3.0.0.0의 XEPDB1에서 테스트 계정 RMIG_TEST로 DBeaver를 써서 실행했습니다. USERS 테이블스페이스의 블록 크기는 8,192바이트입니다. 가상의 배송 이력 테이블 DLV_P0, DLV_P10, DLV_P30은 PCTFREE만 다르고 나머지는 같습니다. 각 테이블에 30,000건을 memo가 빈 상태로 넣은 뒤, 모든 행의 memo에 30자를 채우는 UPDATE를 실행했습니다.
CREATE TABLE dlv_p10 (
  id        NUMBER        CONSTRAINT pk_dlv_p10 PRIMARY KEY,
  order_no  VARCHAR2(20)  NOT NULL,
  status    VARCHAR2(10)  NOT NULL,
  addr      VARCHAR2(100) NOT NULL,
  memo      VARCHAR2(100)
) PCTFREE 10;          -- DLV_P0은 PCTFREE 0, DLV_P30은 PCTFREE 30

INSERT INTO dlv_p10 (id, order_no, status, addr, memo)
SELECT LEVEL, 'ORD-' || LPAD(LEVEL, 8, '0'), 'READY', RPAD('ADDR-' || LEVEL, 70, '.'), NULL
FROM   dual CONNECT BY LEVEL <= 30000;
COMMIT;

-- 배송 완료 처리
UPDATE dlv_p10 SET status = 'DONE', memo = RPAD('DONE-' || id, 30, '#');
COMMIT;

-- 옮겨 간 행 목록 (CHAINED_ROWS는 utlchain.sql과 같은 구조로 직접 생성)
ANALYZE TABLE dlv_p10 LIST CHAINED ROWS INTO chained_rows;
비교용으로 가상의 반품 메모 테이블 RTN_NOTE도 하나 더 만들었습니다. VARCHAR2(4000) 컬럼 세 개에 3,000자씩 채워 행 하나가 약 9KB가 되므로, 처음부터 한 블록에 들어가지 않는 행입니다. 적재 직후와 UPDATE 직후에 통계를 수집하고 LIST CHAINED ROWS를 실행해, 두 시점의 상태를 한 표에 모았습니다.
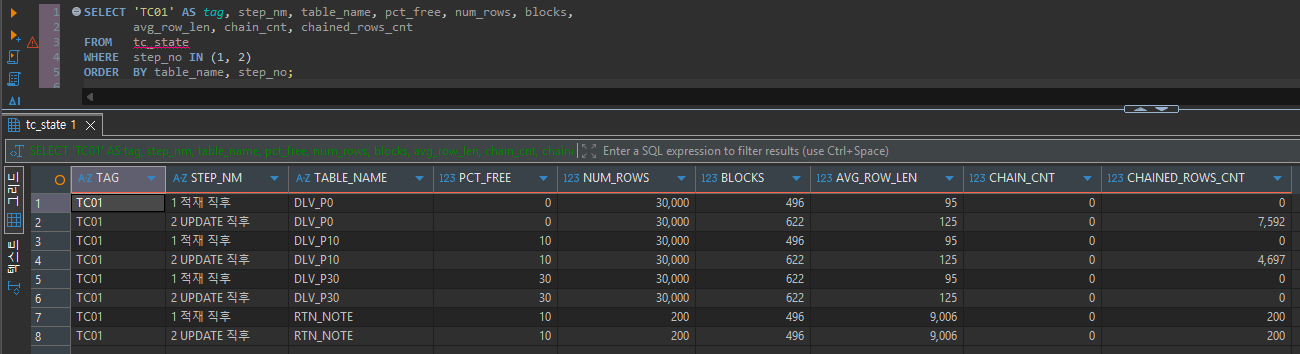
AVG_ROW_LEN은 세 테이블 모두 95에서 125로 늘었습니다. 행마다 30바이트, 원래 길이의 약 32%입니다. 이 증가를 받아 내지 못한 행이 PCTFREE 0에서 7,592건(25.3%), 10에서 4,697건(15.7%)이었고, 30에서는 한 건도 없었습니다. PCTFREE 0인데도 전체의 4분의 1만 옮겨 간 것은, 행 하나가 빠져나가면서 원래 블록에 자리가 생겨 이웃 행이 그 자리를 쓸 수 있었기 때문으로 보입니다.
USER_TABLES의 CHAIN_CNT는 네 테이블, 두 시점 모두 0이었습니다. 블록보다 큰 RTN_NOTE 200건도 마찬가지입니다. DBMS_STATS로 통계를 모으는 운영 DB라면 이 컬럼만 보고 행 이전이 없다고 판단할 수 없습니다. 실제 건수는 LIST CHAINED ROWS를 돌려야 나왔습니다.
적재 직후 BLOCKS가 DLV_P0과 DLV_P10에서 똑같이 496인 것은 통계의 BLOCKS가 HWM 아래 블록 수이기 때문입니다. 행 헤더가 실제로 들어 있는 블록을 ROWID로 세어 보니 DLV_P0은 374개, DLV_P30은 533개였습니다. PCTFREE 30은 적재 시점에 블록을 약 42% 더 쓰고 이전을 막았습니다. 반면 PCTFREE 0의 절약분은 UPDATE 뒤 BLOCKS가 622로 늘면서 사라졌고, 세 테이블의 FULL SCAN logical reads도 모두 568로 같아졌습니다.
같은 SUM, 경로에 따라 갈린 table fetch continued row
읽기 비용은 V$MYSTAT의 table fetch continued row와 session logical reads를 SQL 실행 전후로 읽어 차이를 구했습니다. 테이블마다 INDEX 힌트와 FULL 힌트로 같은 합계를 세 번씩 구하는 PL/SQL을 돌렸고, 캡처에는 세 번의 중앙값을 실었습니다. 아래쪽 AFTER_MOVE 행은 MOVE와 REBUILD 뒤에 같은 측정을 다시 한 결과로, 뒤에서 다룹니다.
v_sql := 'SELECT ' || v_hint || ' SUM(NVL(LENGTH(t.' || v_col(i) || '), 0)) FROM '
         || v_tab(i) || ' t WHERE t.id > 0';     -- v_hint: /*+ INDEX(t) */ 또는 /*+ FULL(t) */
FOR r IN 1 .. 3 LOOP
  c0 := my_stat('table fetch continued row');
  l0 := my_stat('session logical reads');
  EXECUTE IMMEDIATE v_sql INTO v_sum;
  c1 := my_stat('table fetch continued row');
  l1 := my_stat('session logical reads');
  INSERT INTO tc_stat VALUES (1, 'BEFORE_MOVE', v_tab(i), v_path(p), r, c1 - c0, l1 - l0, v_sum);
END LOOP;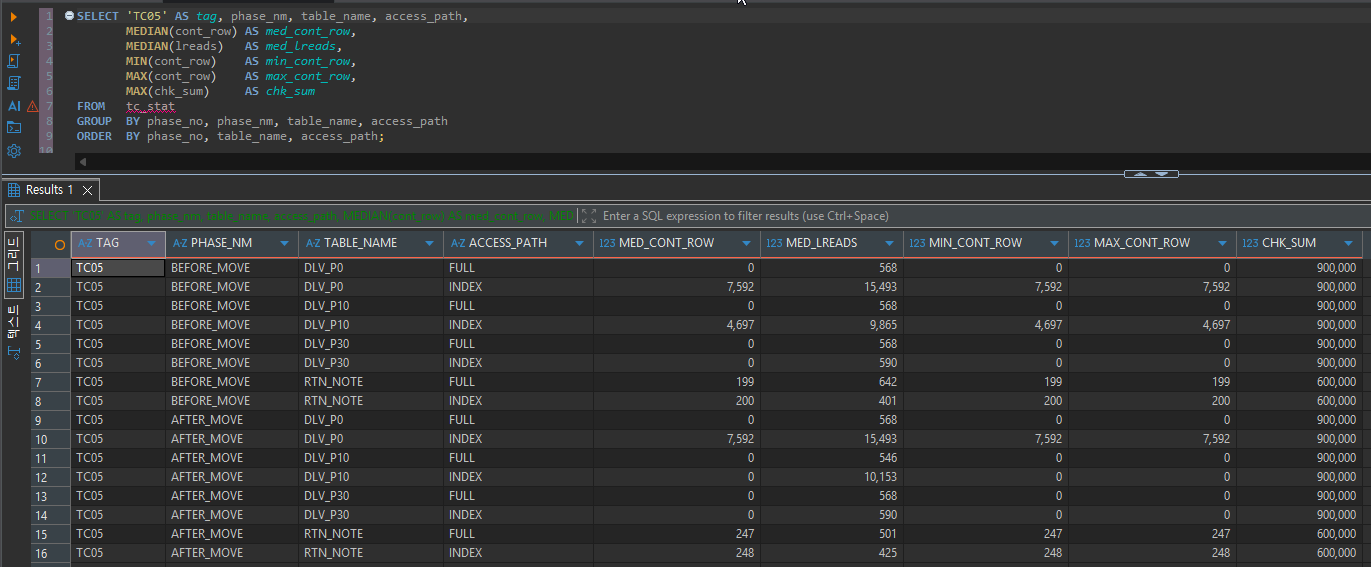
MOVE 전 인덱스 경로의 table fetch continued row는 DLV_P0 7,592, DLV_P10 4,697로 LIST CHAINED ROWS 건수와 정확히 같았고, 세 번 모두 같은 값이었습니다. 같은 테이블을 FULL SCAN으로 읽으면 0입니다. ROWID로 찾아간 원래 블록에는 옮겨 간 주소만 남아 있어 한 번 더 따라가야 하지만, FULL SCAN은 옮겨 간 블록에서 행을 그대로 읽기 때문으로 보입니다. 합계 CHK_SUM은 모든 테이블에서 900,000으로 같아, 결과는 같고 읽는 양만 달랐습니다.
logical reads는 인덱스 경로에서 DLV_P0 15,493, DLV_P10 9,865, DLV_P30 590이었습니다. 실행계획 모양은 셋 다 같은 인덱스 경유 조회라서, 계획만 보면 이 차이는 드러나지 않습니다. 뒤에서 구한 DLV_P0의 클러스터링 팩터 374와 리프 블록 56을 빼고 나누면, 옮겨 간 행 하나당 약 2블록을 더 읽었다는 계산이 나옵니다. 측정 1회차는 2·3회차보다 7~14블록 많았고, 2·3회차는 같은 값이었습니다.
블록보다 큰 RTN_NOTE는 경로를 가리지 않았습니다. MOVE 전 FULL 199, INDEX 200으로, 행이 처음부터 여러 블록에 걸쳐 있으니 어느 경로로 읽어도 다음 조각을 따라가야 합니다. FULL에서 한 건이 적은 이유는 이번에는 확인하지 못했습니다.
MOVE가 없앤 것과 남긴 것
MOVE의 주목적은 삭제 후 남은 공간을 회수하는 것이었고, 행 이전은 재배치 과정에서 함께 해소되는 효과로 봤습니다. 행 자체가 블록보다 커서 생기는 행 연결은 별도로 구분했습니다. 같은 구분이 테스트에서도 나오는지 보려고 DLV_P10과 RTN_NOTE만 ALTER TABLE ... MOVE 한 뒤 PK 인덱스를 REBUILD했습니다. 공간 회수 쪽 결과는 DELETE 뒤 HWM과 SHRINK·MOVE 테스트에서 따로 다뤘습니다.
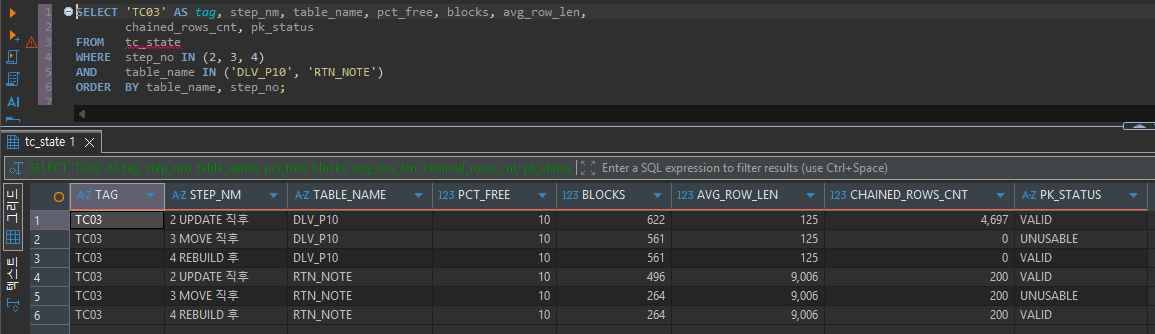
DLV_P10은 CHAINED_ROWS가 4,697에서 0이 되고 BLOCKS가 622에서 561로 줄었습니다. FULL SCAN logical reads도 568에서 546으로 내려갔습니다. RTN_NOTE는 BLOCKS가 496에서 264로 거의 절반이 됐지만 CHAINED_ROWS 200은 그대로였습니다. 블록보다 큰 행은 다시 쌓아도 한 블록에 들어가지 않으니, 이 200건은 MOVE로 해결할 대상이 아닙니다.
RTN_NOTE에서 예상하지 못한 숫자가 하나 나왔습니다. MOVE 뒤 table fetch continued row가 FULL 199에서 247로, INDEX 200에서 248로 오히려 늘었습니다. 블록을 빈틈없이 채워 쌓으면서 약 9KB짜리 행이 블록 중간에서 시작해 세 블록에 걸치는 경우가 생긴 것으로 보입니다. FULL SCAN logical reads는 642에서 501로 줄었으니, 블록 수가 줄어든 효과와 조각 수가 늘어난 효과가 함께 나타난 결과입니다.
이전 행은 0인데 인덱스 읽기는 10,153
MOVE와 REBUILD를 마친 DLV_P10은 인덱스 경로의 table fetch continued row가 0이 됐습니다. 그런데 logical reads는 9,865에서 10,153으로 오히려 늘었습니다. 이전 행이 하나도 없는 DLV_P30이 590인 것과 비교하면 열일곱 배가 넘습니다. 원인 후보는 행 순서였습니다. 그래서 인덱스 통계를 다시 모아 클러스터링 팩터와 실제 행이 든 블록 수를 함께 조회했습니다.

DLV_P30은 클러스터링 팩터 533이 행이 든 블록 수 533과 같았습니다. id 순서대로 읽으면 블록도 순서대로 넘어간다는 뜻입니다. DLV_P10은 블록 543개에 클러스터링 팩터가 10,090입니다. 인덱스 경로 logical reads 10,153은 이 10,090에 리프 블록 62를 더한 값과 거의 같고, DLV_P30의 590도 533에 리프 블록 56을 더한 값과 맞아떨어집니다.
UPDATE 때 테이블 뒤쪽 블록으로 옮겨 간 4,697건은 MOVE가 테이블을 블록 순서로 읽어 다시 쓰는 과정에서 그 뒤쪽 위치대로 놓인 것으로 보입니다. 그 결과 id 순서와 블록 순서가 어긋났습니다. 행 이전은 해소됐지만 인덱스로 범위를 읽는 SQL의 비용은 줄지 않았습니다. 같은 적재 순서 문제는 적재 순서에 따라 달라진 클러스터링 팩터 테스트에서도 확인한 적이 있습니다.
REBUILD 전 UNUSABLE PK 앞에서 갈린 두 SQL
MOVE 직후에는 PK 인덱스가 UNUSABLE이 됩니다. SKIP_UNUSABLE_INDEXES는 TRUE였기 때문에, INDEX 힌트를 준 SQL도 인덱스를 건너뛰고 FULL SCAN으로 실행될 것이라고 예상했습니다. 결과는 달랐습니다. 힌트를 준 조회는 ORA-01502: 인덱스 'RMIG_TEST.PK_DLV_P10'또는 인덱스 분할영역은 사용할 수 없은 상태입니다로 실패했고, 커서가 만들어지지 않아 실행계획도 남지 않았습니다.
힌트 없는 SQL은 어떻게 되는지 보려고 같은 조건의 100건 조회를 MOVE 전과 후로 나눠 실행했습니다.
-- 인덱스 VALID 상태
SELECT /*+ GATHER_PLAN_STATISTICS */ 'TC07A' AS tag, COUNT(*) AS cnt, MAX(memo) AS max_memo
FROM   dlv_p10 t
WHERE  t.id BETWEEN 1 AND 100;

ALTER TABLE dlv_p10 MOVE;          -- PK_DLV_P10 → UNUSABLE

-- 힌트 없음
SELECT /*+ GATHER_PLAN_STATISTICS */ 'TC07B' AS tag, COUNT(*) AS cnt, MAX(memo) AS max_memo
FROM   dlv_p10 t
WHERE  t.id BETWEEN 1 AND 100;

-- INDEX 힌트: ORA-01502
SELECT /*+ GATHER_PLAN_STATISTICS INDEX(t) */ 'TC07C' AS tag, COUNT(*) AS cnt, MAX(memo) AS max_memo
FROM   dlv_p10 t
WHERE  t.id BETWEEN 1 AND 100;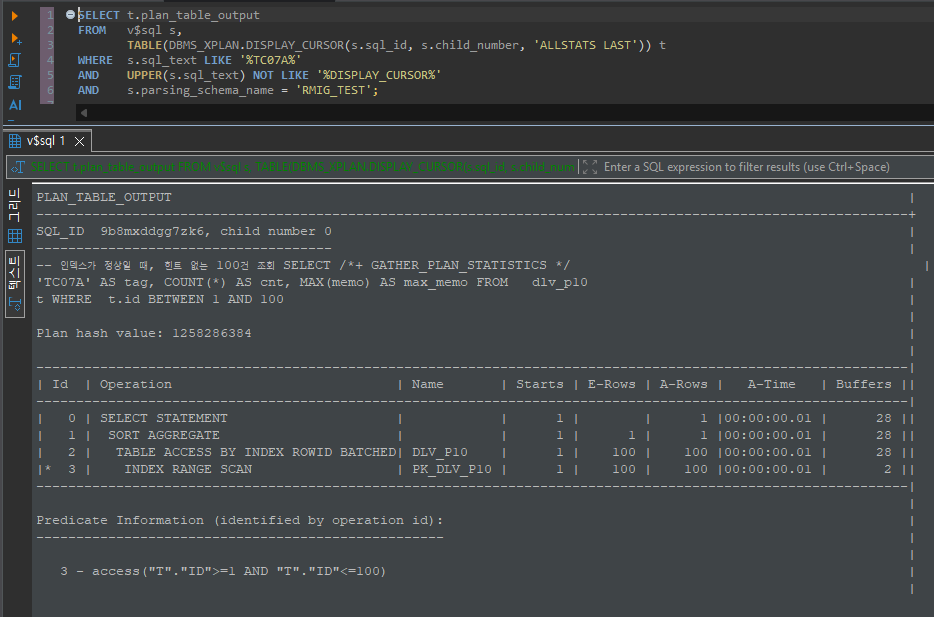
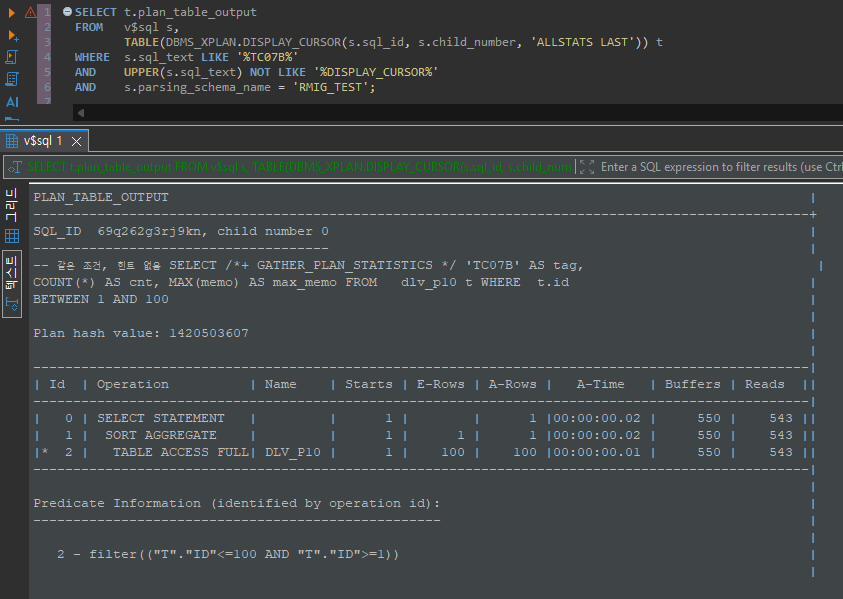
인덱스가 정상일 때 TC07A는 INDEX RANGE SCAN에 Buffers 28이었습니다. MOVE 뒤 힌트 없는 TC07B는 같은 100건을 TABLE ACCESS FULL로 읽어 Buffers 550, Reads 543이 됐고 Predicate도 access에서 filter로 바뀌었습니다. 오류는 없었습니다. 힌트가 있는 SQL은 실패로 바로 드러나지만, 힌트가 없는 SQL은 결과는 맞게 나오면서 읽는 블록만 약 20배로 늘어 조용히 지나갑니다.
MOVE 뒤 REBUILD가 빠져서 문제가 된 적은 없었습니다. MOVE 방식에 따른 인덱스 영향과 작업 후 인덱스 상태를 확인하고, 필요한 REBUILD까지 작업 절차에 포함해 왔습니다. 이번 결과는 그 절차가 빠졌을 때 힌트 유무에 따라 오류와 FULL SCAN으로 다르게 나타난다는 것을 보여 줍니다. UNUSABLE 상태의 유일 인덱스가 걸린 테이블에 DML을 실행하는 경우는 이번에 확인하지 않았습니다.
PCTFREE 20과 30 사이에서 이번 숫자로 계산할 수 있는 것
이번 데이터는 UPDATE로 행이 95바이트에서 125바이트로 늘었습니다. 늘어난 행이 블록 안에 모두 남으려면 처음부터 비워 둘 공간이 30/125, 약 24% 이상이어야 합니다. PCTFREE 30이 0건, 10이 4,697건이었던 결과와 어긋나지 않는 계산입니다. PCTFREE 20은 이번에 측정하지 않았지만, 이 계산대로라면 이번 증가 폭에서는 일부 행이 옮겨 갈 수 있는 값입니다.
반대로 PCTFREE를 올리면 적재 시점의 블록이 늘어납니다. 이번에는 행이 든 블록이 PCTFREE 0의 374개에서 30의 533개로 늘었습니다. 운영 테이블의 PCTFREE는 UPDATE 전후 AVG_ROW_LEN의 차이와, 그 테이블을 인덱스로 읽는 SQL이 얼마나 되는지를 함께 놓고 정해야 합니다. 이번 결과에서 비용이 커진 쪽은 인덱스 경로였습니다.
행 이전이 의심되는 테이블에 돌려 볼 SQL 세 묶음
이번 테스트에서 쓴 조회를 운영 점검 순서대로 옮겼습니다. CHAINED_ROWS 테이블은 미리 만들어 두어야 합니다. LIST CHAINED ROWS는 테이블 전체를 읽으니, 큰 테이블은 업무 시간대를 피해서 돌리는 쪽을 권합니다.
-- 1) 의심 SQL을 실행한 세션에서 전후 차이로 보기
SELECT n.name, m.value
FROM   v$mystat m, v$statname n
WHERE  m.statistic# = n.statistic#
AND    n.name IN ('table fetch continued row', 'session logical reads');

-- 2) 옮겨 간 행과 연결된 행을 함께 세기 (CHAIN_CNT는 DBMS_STATS로 채워지지 않음)
ANALYZE TABLE dlv_p10 LIST CHAINED ROWS INTO chained_rows;
SELECT table_name, COUNT(*) AS chained_cnt
FROM   chained_rows
GROUP  BY table_name;

-- 3) MOVE와 REBUILD 뒤 인덱스 상태와 클러스터링 팩터
SELECT index_name, status, clustering_factor, leaf_blocks
FROM   user_indexes
WHERE  table_name = 'DLV_P10';
2번 결과에 블록보다 큰 행이 섞여 있으면 MOVE를 해도 그 건수는 남습니다. MOVE 대상인지는 AVG_ROW_LEN과 블록 크기를 먼저 비교해 가를 수 있습니다. 남은 질문은 MOVE 대신 ORDER BY id로 다시 적재했을 때 DLV_P10의 클러스터링 팩터가 DLV_P30 수준으로 돌아오는가입니다.

댓글 0
첫 댓글을 남겨보세요.