대량 DELETE 뒤 인덱스 리빌드, DEL_LF_ROWS 54%는 두 인덱스에서 다른 뜻이었다

보관 대상만 남기고 지운 DELETE 한 문장
DELETE FROM parcel_scan_log
WHERE scan_id <= 180000
  AND status_cd = 'DONE';
오래된 스캔 이력 가운데 완료(DONE) 건만 지우고 보류(HOLD) 건은 남기는 퍼지입니다. DBeaver에 찍힌 삭제 건수는 162,000건이었습니다. 이 테이블에는 순번으로 증가하는 PK(PSL_PK)와 무작위 값이 들어가는 송장 번호 인덱스(IX_PSL_PARCEL)가 함께 걸려 있습니다. 같은 DELETE를 맞은 두 인덱스를 ANALYZE INDEX ... VALIDATE STRUCTURE로 단계마다 열어 보면, 대량 삭제 뒤 리빌드가 정말 필요한지 숫자로 가를 수 있다고 봤습니다.
따져 보고 싶었던 것은 리빌드 판단에 쓰이는 DEL_LF_ROWS 비율입니다. 삭제 표시가 붙은 리프 엔트리가 많으면 리빌드하라는 말은 자주 보이지만, 이 비율이 실제 읽기 비용을 대변하는지 직접 확인한 자료는 드뭅니다. 미리 세운 예상은 네 가지였습니다. 순번 PK는 새 키가 오른쪽 끝으로만 들어가니 왼쪽의 듬성한 블록이 재사용되지 않을 것이고, 무작위 키 인덱스는 새 INSERT가 빈자리를 채워 스스로 회복할 것이며, DELETE 직후 삭제 비율은 무작위 키 인덱스 쪽이 더 높게 나올 것이고, COALESCE만으로도 범위 스캔 비용은 리빌드와 비슷하게 줄어들 것이라는 예상입니다. 이 중 하나는 빗나갔습니다.
택배 스캔 로그 300,000건과 성격이 다른 인덱스 두 개
재현은 Oracle Database 21c Express Edition(21.3.0.0.0)의 XEPDB1에서, 전용 사용자 PSL_LAB과 DBeaver로 진행했습니다. 버전과 접속 정보는 V$VERSION과 SYS_CONTEXT를 한 쿼리로 묶어 확인했고, 블록 크기는 8192, USERS 테이블스페이스는 SEGMENT_SPACE_MANAGEMENT = AUTO였습니다. PARCEL_SCAN_LOG는 블로그 테스트용으로 만든 가상 테이블입니다.
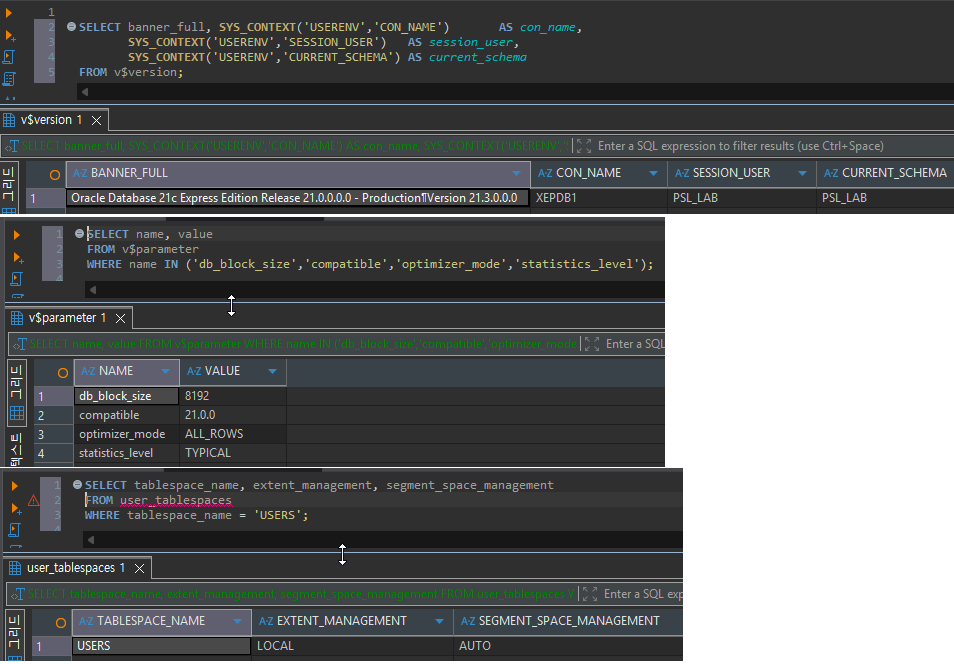
데이터는 300,000건으로 잡았습니다. 리프 블록이 수백 개 생겨 Buffer Gets 차이가 읽히면서도, XE에서 ANALYZE와 REBUILD가 1초 안쪽에 끝나는 규모입니다. 운영에서 인덱스가 자라는 방식에 가깝게 하려고 APPEND 없이 일반 INSERT로 넣었고, 송장 번호는 DBMS_RANDOM.SEED(26) 이후 1~10억 사이 균등 분포로 만들었습니다. 10건마다 1건이 HOLD여서 적재 직후 분포는 DONE 270,000건, HOLD 30,000건이었고, scan_id 180,000 이하 구간에는 DONE 162,000건과 HOLD 18,000건이 있었습니다.
CREATE TABLE parcel_scan_log (
  scan_id    NUMBER(10)   NOT NULL,
  scan_dt    DATE         NOT NULL,
  parcel_no  NUMBER(12)   NOT NULL,
  hub_cd     VARCHAR2(6)  NOT NULL,
  status_cd  VARCHAR2(4)  NOT NULL,
  payload    VARCHAR2(80),
  CONSTRAINT psl_pk PRIMARY KEY (scan_id)
);
CREATE INDEX ix_psl_parcel ON parcel_scan_log (parcel_no);

BEGIN DBMS_RANDOM.SEED(26); END;
/

INSERT INTO parcel_scan_log
SELECT level,
       DATE '2026-01-01' + level / 2000,
       TRUNC(DBMS_RANDOM.VALUE(1, 1000000000)),
       'HUB' || LPAD(MOD(level, 40), 2, '0'),
       CASE WHEN MOD(level, 10) = 0 THEN 'HOLD' ELSE 'DONE' END,
       RPAD('scan-event-', 60, 'x')
FROM dual
CONNECT BY level <= 300000;
COMMIT;
관찰은 다섯 시점으로 나눴습니다. S1 적재 직후, S2 DELETE와 COMMIT 직후, S3 삭제한 만큼(162,000건) 새 scan_id로 다시 넣은 뒤, S4 두 인덱스 COALESCE 후, S5 REBUILD 후입니다. S3에서 총 건수가 S1과 같은 300,000건으로 돌아오게 맞췄습니다. 시점마다 프로시저가 아래 작업을 인덱스별로 반복해 기록 테이블에 쌓았습니다.
ANALYZE INDEX psl_pk VALIDATE STRUCTURE;

SELECT name, height, lf_blks, br_blks, lf_rows, del_lf_rows, pct_used
FROM index_stats;

BEGIN DBMS_STATS.GATHER_INDEX_STATS(USER, 'PSL_PK'); END;
/
INDEX_STATS는 세션마다 마지막 ANALYZE 결과 한 건만 보여 주므로, 처음부터 끝까지 같은 SQL 편집기 세션에서 실행했습니다. 읽기 비용은 아래 두 쿼리를 시점마다 3회씩 돌리면서 V$MYSTAT의 session logical reads 증가분을 저장하고 중앙값으로 비교했습니다. 태그 리터럴은 시점마다 바꿔서 V$SQL에서 커서를 따로 찾을 수 있게 했습니다.
-- Q1: 삭제가 몰린 구간을 PK로 범위 스캔
SELECT /*+ GATHER_PLAN_STATISTICS INDEX(p psl_pk) */ 'TC26_Q1_S3' tag, COUNT(*)
FROM parcel_scan_log p
WHERE p.scan_id BETWEEN 1 AND 180000;

-- Q2: 송장 번호 인덱스 전체를 FAST FULL SCAN
SELECT /*+ GATHER_PLAN_STATISTICS INDEX_FFS(p ix_psl_parcel) */ 'TC26_Q2_S3' tag, COUNT(p.parcel_no)
FROM parcel_scan_log p;
측정 프로시저를 만들다 한 번 막혔습니다. V$MYSTAT을 읽는 함수를 프로시저 안쪽에 두고 DBeaver에서 Ctrl+Enter로 실행하자 PLS-00201: 'V_TAG' 식별자가 정의되어야 합니다가 나왔습니다. DBeaver가 안쪽 함수의 END;를 문장 끝으로 보고, 그 뒤의 BEGIN 블록만 익명 블록으로 서버에 보낸 것입니다. 안쪽 함수를 없애고 V$MYSTAT 조회를 본문에 직접 쓰자 정상 컴파일됐습니다.
DELETE 직후 두 인덱스는 똑같이 54%를 보고했다
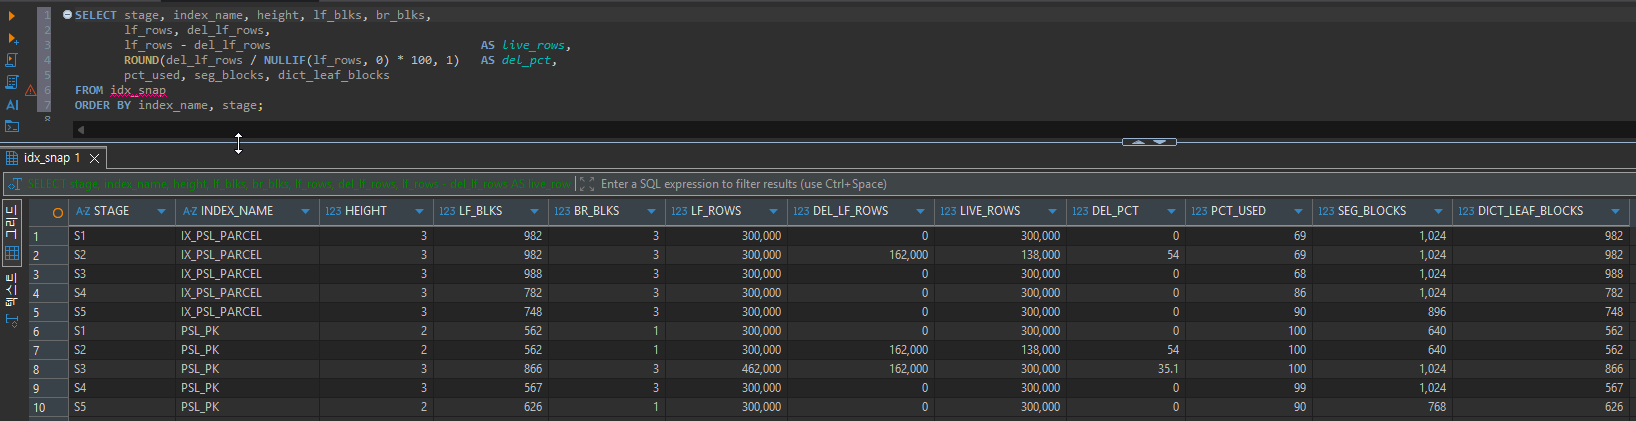
S2 행을 보면 두 인덱스 모두 LF_ROWS 300,000, DEL_LF_ROWS 162,000, 삭제 비율 54%로 같습니다. LF_BLKS는 PSL_PK 562, IX_PSL_PARCEL 982로 S1과 한 개도 다르지 않았습니다. 지운 엔트리는 블록에서 빠져나가지 않고 삭제 표시만 붙은 채 그 자리에 남아 있었습니다.
눈에 걸린 값은 PCT_USED입니다. 절반 넘게 지웠는데 PSL_PK는 100, IX_PSL_PARCEL은 69로 S1과 똑같았습니다. 삭제 표시 엔트리도 사용 중인 공간으로 계산되는 것으로 보입니다. PCT_USED만 보고 인덱스 상태를 판단하면 대량 삭제 흔적을 그대로 놓치게 됩니다.
Q1 읽기 비용도 움직이지 않았습니다. S1에서 180,000건을 세는 데 338블록을 읽었고, S2에서는 18,000건을 세면서 역시 338블록을 읽었습니다(3회 모두 같은 값). 반환 행은 10분의 1로 줄었는데 방문하는 리프 블록 수가 그대로이니, 한 행을 세는 비용은 10배가 된 셈입니다.
세 번째 예상은 여기서 빗나갔습니다. 무작위 키 인덱스의 삭제 비율이 더 높게 나오리라 봤지만, 같은 162,000건을 지웠으니 비율도 정확히 같았습니다. 그래서 같은 54%가 이후 어떻게 달라지는지를 따라갔습니다.
지운 만큼 다시 넣자 PK만 부풀었다
INSERT INTO parcel_scan_log
SELECT 300000 + level,
       DATE '2026-06-01' + level / 2000,
       TRUNC(DBMS_RANDOM.VALUE(1, 1000000000)),
       'HUB' || LPAD(MOD(level, 40), 2, '0'),
       CASE WHEN MOD(level, 10) = 0 THEN 'HOLD' ELSE 'DONE' END,
       RPAD('scan-event-', 60, 'x')
FROM dual
CONNECT BY level <= 162000;
COMMIT;
S3은 지운 만큼 새 데이터가 들어오는 평소 운영 상황을 흉내 낸 단계입니다. 새 scan_id는 300,001부터 시작하고 송장 번호는 다시 무작위입니다. 총 건수가 S1과 같아진 시점에서 두 인덱스의 결과는 정반대였습니다.
IX_PSL_PARCEL은 DEL_LF_ROWS가 162,000에서 0이 됐고, LF_BLKS는 982에서 988로 6개 늘었을 뿐입니다. 무작위 키가 기존 리프 블록 곳곳으로 들어가면서 그 블록의 삭제 표시 엔트리가 정리되고 빈 공간이 다시 쓰인 것으로 보입니다. 리빌드 없이 스스로 회복했다고 봐도 되는 숫자입니다.
PSL_PK는 LF_ROWS가 462,000으로 찍혔습니다. 살아 있는 키 300,000에 삭제 표시 162,000이 고스란히 붙어 있는 값입니다. 새 키는 오른쪽 끝에만 쌓이니 왼쪽 블록은 아무도 건드리지 않았고, 그 사이 LF_BLKS는 562에서 866으로, HEIGHT는 2에서 3으로, 세그먼트 블록은 640에서 1,024로 늘었습니다. 행 수는 S1과 같은데 리프 블록은 1.5배 넘게 많아졌습니다. 삭제 비율은 오히려 35.1%로 내려가 보였는데, 분모인 LF_ROWS에 새 키가 더해졌기 때문입니다. 상태가 나빠지는 동안 비율은 좋아진 것처럼 보인 셈입니다.
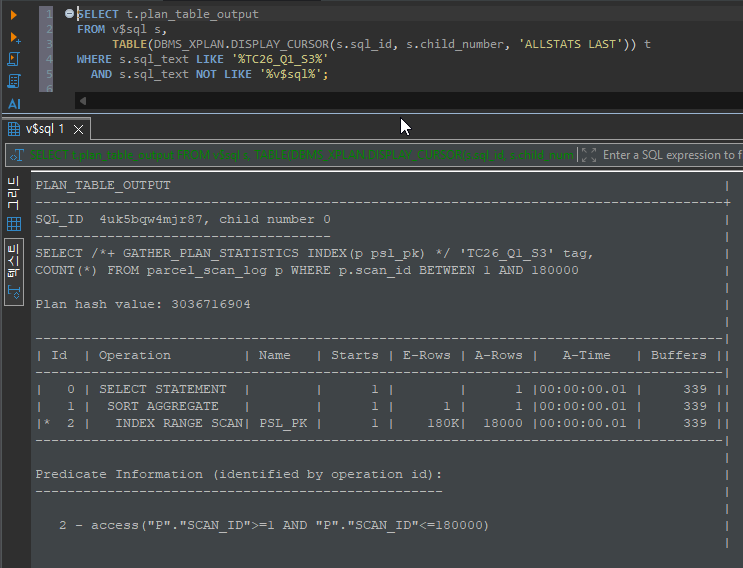
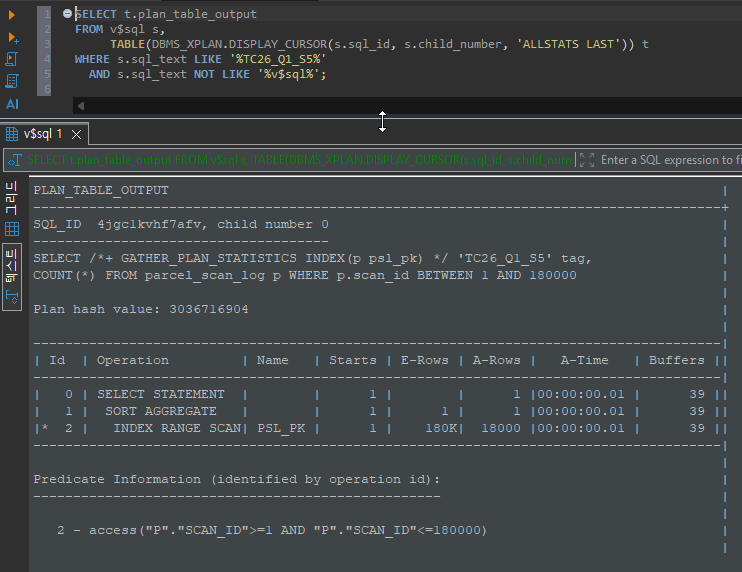
S3의 실행 통계에서도 18,000건(A-Rows)에 339버퍼가 들었습니다. E-Rows가 180K로 찍힌 것은 테이블 통계를 S1에서만 수집했기 때문입니다. 이번에는 힌트로 INDEX RANGE SCAN을 고정해 두어 실행계획이 흔들리지 않았지만, 대량 DELETE 뒤에 남은 옛 통계가 카디널리티 추정을 10배 어긋나게 만든다는 점은 따로 챙겨 볼 부분입니다.
COALESCE와 REBUILD는 줄인 대상이 서로 달랐다
ALTER INDEX psl_pk COALESCE;
ALTER INDEX ix_psl_parcel COALESCE;
-- S4 기록 후
ALTER INDEX psl_pk REBUILD;
ALTER INDEX ix_psl_parcel REBUILD;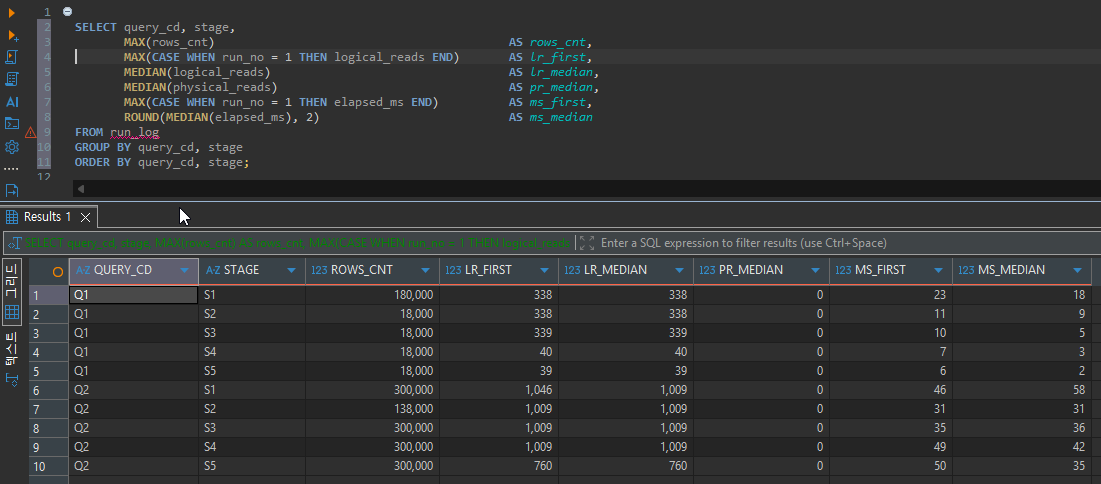
| 항목 | S3 재적재 후 | S4 COALESCE | S5 REBUILD |
|---|---|---|---|
| PSL_PK LF_BLKS / HEIGHT | 866 / 3 | 567 / 3 | 626 / 2 |
| PSL_PK 세그먼트 블록 | 1,024 | 1,024 | 768 |
| Q1 logical reads 중앙값 | 339 | 40 | 39 |
| IX_PSL_PARCEL LF_BLKS | 988 | 782 | 748 |
| IX_PSL_PARCEL 세그먼트 블록 | 1,024 | 1,024 | 896 |
| Q2 logical reads 중앙값 | 1,009 | 1,009 | 760 |
| DDL 소요 시간 (PK / PARCEL) | – | 0.031s / 0.034s | 0.336s / 0.535s |
Q1만 보면 COALESCE로 충분했습니다. 339에서 40으로 떨어졌고, REBUILD 후 39와는 1블록 차이입니다. 그 1블록은 COALESCE 후에도 HEIGHT 3과 브랜치 블록 3개가 그대로이고 REBUILD 후에야 HEIGHT 2로 돌아온 차이와 맞아떨어지는 것으로 보입니다.
Q2는 사정이 달랐습니다. COALESCE가 IX_PSL_PARCEL의 LF_BLKS를 988에서 782로 줄였는데도 INDEX FAST FULL SCAN의 읽기는 1,009 그대로였고, 세그먼트 블록도 1,024에서 움직이지 않았습니다. 범위 스캔은 연결된 리프 블록만 따라가지만 FAST FULL SCAN은 세그먼트를 통째로 읽기 때문에, 병합으로 비워진 블록이 세그먼트에 남아 있는 한 비용이 그대로였던 것으로 해석했습니다. REBUILD로 세그먼트가 896블록이 된 뒤에야 760으로 내려갔습니다.
다만 IX_PSL_PARCEL이 줄어든 몫은 DELETE 탓이 아닙니다. 이 인덱스는 S1부터 PCT_USED 69였습니다. 무작위 키가 들어오며 블록이 나뉠 때 생기는 여유 공간이고, COALESCE와 REBUILD는 그 여유를 짜낸 것입니다. 이 공간은 앞으로 들어올 무작위 키가 다시 차지할 자리여서, 줄어든 크기가 오래 유지되리라 기대하기는 어렵습니다.
가장 의외였던 숫자는 REBUILD한 PK의 크기입니다. LF_BLKS 626으로 COALESCE(567)보다 많았고, 처음 자연스럽게 쌓였던 S1(562)보다도 많았습니다. PCT_USED도 100에서 90으로 내려왔습니다. 리빌드가 인덱스 기본 PCTFREE 10을 다시 적용해 블록마다 10%씩 비워 둔 결과로 보입니다. 순번 PK의 왼쪽 블록에는 새 키가 들어오지 않으니, 이 10%는 다시 쓰일 일이 거의 없는 자리입니다.
경과 시간은 판단 근거에서 뺐습니다. 모든 측정에서 physical reads가 0이라 전부 버퍼 캐시에서 읽혔고, Q1 중앙값이 2~18ms 수준이라 차이를 해석하기엔 너무 작습니다. COALESCE 0.03초와 REBUILD 0.3~0.5초의 차이도 300,000건 규모에서 나온 값이어서 운영 테이블 크기로 늘려 잡을 수는 없습니다. 비교는 Buffer Gets 기준으로만 했고, 같은 이유로 Buffer Cache Hit Ratio 대신 Buffer Gets를 기준으로 삼은 이전 글에서도 같은 지표를 썼습니다.
온라인 리빌드가 없는 SE2에서 리빌드를 거는 이유
운영 중인 19c SE2에서는 온라인 인덱스 리빌드를 쓸 수 없습니다. Oracle에서 Oracle로 DMS 복제를 받는 타깃 DB의 데이터파일을 축소해야 했을 때도 이 제약에 걸렸습니다. 그래서 DMS 복제를 잠깐 내리고 인덱스를 리빌드했고, 리빌드가 끝난 뒤 데이터파일을 리사이즈해 줄인 다음 복제를 다시 시작했습니다. 그때 리빌드를 건 목적은 쿼리 속도가 아니라 공간을 돌려받는 데 있었습니다.
이번 결과에 그 작업을 대 보면 순서가 맞아떨어집니다. COALESCE는 리프 블록을 합쳐도 세그먼트 블록(1,024)을 하나도 돌려주지 않았습니다. 데이터파일을 줄이려면 세그먼트 자체가 작아져야 하니, 그 상황에서는 서비스를 멈추더라도 REBUILD가 필요했던 셈입니다. 반대로 특정 구간 조회가 무거운 것이 문제라면, 이번 PK처럼 COALESCE만으로 Buffer Gets가 리빌드 수준까지 내려왔습니다. COALESCE가 운영 DML과 동시에 돌 때 어떤 영향을 주는지는 이번에 확인하지 않았습니다.
리빌드를 고를 때 볼 값은 이렇게 좁혀졌습니다.
- DEL_LF_ROWS 비율은 한 시점의 값으로 결정하지 않습니다. S2의 54%는 두 인덱스에서 같았지만 한쪽은 저절로 0이 됐고, 다른 쪽은 비율이 35.1%로 떨어지는 동안 오히려 커졌습니다. 신규 데이터가 들어온 뒤에도 삭제 엔트리가 남는지를 다시 봐야 합니다.
- 살아 있는 행 수 대비 리프 블록 수의 추이를 봅니다. 이번에 DBMS_STATS가 채운
LEAF_BLOCKS는 모든 시점에서 INDEX_STATS의 LF_BLKS와 같았습니다. 오프라인 VALIDATE STRUCTURE는 검사 동안 테이블 DML을 막는 방식이어서(이번에는 확인하지 않음), 운영에서는 DBA_INDEXES의 LEAF_BLOCKS와 NUM_ROWS 변화를 먼저 보는 편이 부담이 적습니다. - 키가 들어오는 방향을 봅니다. 날짜나 순번처럼 한쪽으로만 증가하는 키에서 오래된 구간을 일부만 지우는 퍼지라면, 빈자리는 기다려도 채워지지 않습니다.
- 목적을 나눕니다. 범위 조회 비용이 문제면 COALESCE부터, 세그먼트나 데이터파일 공간을 돌려받아야 하면 REBUILD를 검토합니다.
이 판단이 그대로 통하지 않는 조건도 있습니다. 이번에는 HOLD 10%를 남겨 PK 왼쪽 블록이 완전히 비지 않게 만들었습니다. 오래된 구간을 남김없이 지우는 퍼지라면 블록이 통째로 비어 재사용될 수 있어 S3의 증가 폭이 달라질 수 있습니다. 여러 세션이 동시에 INSERT하는 환경, 한쪽으로 치우친 분포의 무작위 키, 버퍼 캐시에 다 올라가지 않는 크기의 인덱스도 이번 범위 밖입니다.
대량 퍼지 뒤 COALESCE와 REBUILD 중 먼저 꺼낼 것
무작위 키 인덱스는 같은 양을 다시 넣자 스스로 회복했고, 순번 PK는 162,000개의 삭제 엔트리를 끝까지 안고 있었습니다. 그 PK도 COALESCE 한 번으로 40블록까지 내려왔고, REBUILD는 세그먼트를 768블록으로 줄이는 대신 리프 블록을 처음보다 늘려 놓았습니다. 그래서 데이터파일 공간을 돌려받아야 하는 작업이 아니라면, 대량 퍼지 뒤에는 COALESCE를 먼저 검토합니다.

댓글 0
첫 댓글을 남겨보세요.