히트율 100%인데 2.45초 걸린 SQL, 답은 실행당 Buffer Gets에 있었다

같은 결과를 내는 SQL 세 개, 아홉 번의 실행
같은 결과(12,000건, 금액 합계 5,967,240)를 내는 SQL 세 개를 각각 세 번씩, 모두 아홉 번 실행했습니다. 가장 느린 실행은 2.45초가 걸렸고 세션 히트율은 100%였습니다. 히트율이 가장 낮았던 실행은 97.974%였는데, 0.03초 만에 끝났습니다.
그동안 인스턴스 전체 히트율은 99.038%에서 99.391%로 오히려 올랐습니다. 히트율이 높다는 사실이 SQL의 속도에 대해 무엇을 말해 주는지, 같은 21c XE 세션 안에서 logical reads와 나란히 놓고 확인했습니다.
| 실행 전 예상 | 결과 |
|---|---|
| 인스턴스 히트율은 측정 내내 99% 이상이다 | 맞음 (99.038% → 99.391%) |
| Nested Loop로 같은 테이블을 반복해 읽는 SQL은 히트율 100%로도 가장 느리다 | 맞음 (159,914블록, 245cs) |
| 그 SQL은 디스크가 아니라 CPU 때문에 느리다 | 맞음 (elapsed의 약 96%가 CPU) |
| CTAS 직후 첫 실행은 디스크를 읽어 히트율이 떨어진다 | 틀림 (첫 실행도 physical reads 0) |
| 비효율적인 SQL을 돌리면 인스턴스 히트율은 오히려 오른다 | 맞음 (+0.353%p) |
768MB 버퍼 캐시에 통째로 들어가는 548블록짜리 결제 테이블
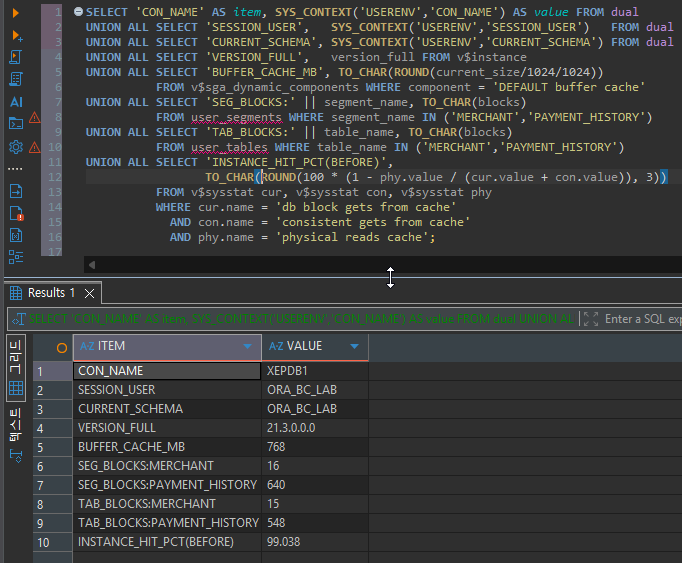
실행 환경은 Oracle Database 21c Express Edition(21.3.0.0.0)의 XEPDB1이고, 버퍼 캐시는 768MB였습니다. 이 안에 가상의 가맹점 3,000곳(MERCHANT)과 결제 120,000건(PAYMENT_HISTORY)을 만들었습니다. 지역은 R01~R10에 균등하게 나눠, R01 가맹점이 300곳이 되게 했습니다. 결제는 가맹점마다 40건이고, 가맹점 번호가 순환하며 섞여 저장됩니다.
CREATE TABLE payment_history AS
SELECT LEVEL                                  AS pay_id,
       MOD(LEVEL-1, 3000) + 1                 AS merchant_id,
       ROUND(MOD(LEVEL*37, 100000) / 100, 2)  AS amount,
       DATE '2026-01-01' + MOD(LEVEL, 270)    AS paid_at,
       CASE MOD(LEVEL,20) WHEN 0 THEN 'CANCEL' ELSE 'PAID' END AS status
FROM dual
CONNECT BY LEVEL <= 120000;
결제 테이블을 이 정도로 작게 잡은 데는 이유가 있습니다. 테이블이 크면 풀 스캔이 버퍼 캐시를 거치지 않는 direct path read로 바뀔 수 있습니다. 그러면 “모든 블록이 캐시에서 읽힌다”는 전제가 깨집니다. 실제로 아홉 번의 실행 모두 physical reads direct는 0이었습니다.
측정은 익명 PL/SQL 블록으로 했습니다. SQL을 실행하기 직전과 직후에 V$MYSTAT의 세션 통계를 읽어, 그 차이를 실행마다 로그 테이블에 남겼습니다. 세션 히트율은 1 - physical reads / session logical reads로 계산했습니다. 롤로 받은 V$ 조회 권한은 저장 프로시저 안에서는 쓸 수 없어서, 프로시저 대신 익명 블록을 썼습니다.
SELECT MAX(DECODE(n.name, 'session logical reads',    s.value)),
       MAX(DECODE(n.name, 'physical reads',           s.value)),
       MAX(DECODE(n.name, 'physical reads direct',    s.value)),
       MAX(DECODE(n.name, 'CPU used by this session', s.value))
  INTO lr, pr, pd, cpu
  FROM v$mystat s JOIN v$statname n ON n.statistic# = s.statistic#
 WHERE n.name IN ('session logical reads', 'physical reads',
                  'physical reads direct', 'CPU used by this session');
300번 반복된 풀 스캔: 159,914 = 300 × 533 + 14
TC01은 결제 테이블의 merchant_id에 인덱스가 없는 상태에서 Nested Loop를 강제한 SQL입니다. 힌트는 잘못된 플랜을 재현하려고 일부러 넣었습니다.
SELECT /*+ GATHER_PLAN_STATISTICS LEADING(m) USE_NL(p) FULL(p) */
       'TC01', COUNT(*), SUM(p.amount)
  FROM merchant m
  JOIN payment_history p ON p.merchant_id = m.merchant_id
 WHERE m.region_cd = 'R01';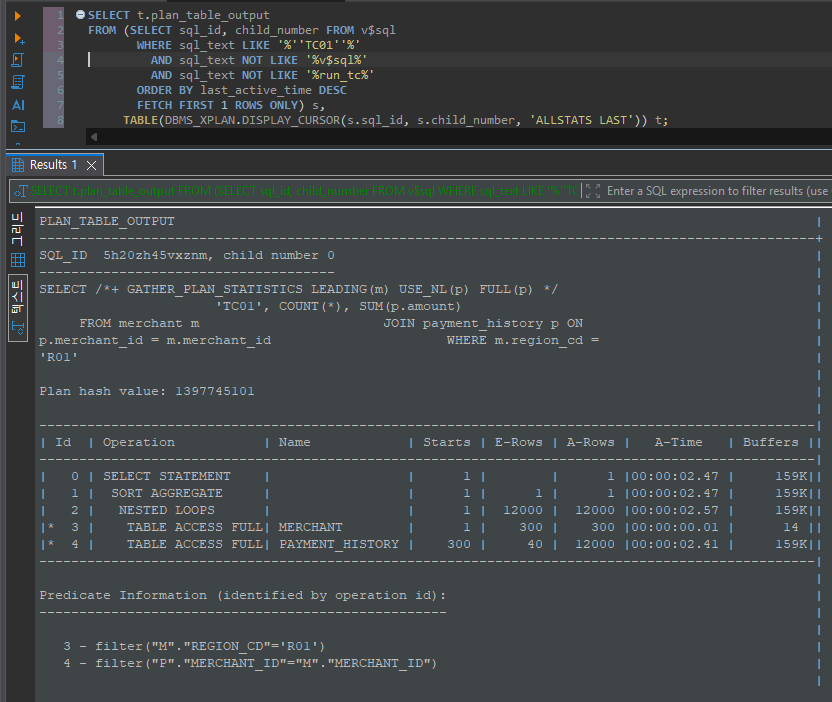
안쪽 PAYMENT_HISTORY 풀 스캔의 Starts는 300입니다. R01 가맹점 300곳마다 결제 테이블을 처음부터 끝까지 한 번씩 읽은 것입니다. 풀 스캔 한 번에 533블록이 들므로(TC02 실행계획 기준), 300번이면 159,900블록입니다. 여기에 MERCHANT 14블록을 더한 159,914가 측정값과 정확히 일치했습니다.
실행계획에는 Reads 열이 아예 나오지 않았습니다. 디스크에서 읽은 블록이 하나도 없었다는 뜻입니다. V$SQL 기준으로 실행당 2,362.8ms 가운데 2,272.5ms, 약 96%가 CPU 시간이었습니다. 이 SQL은 디스크를 기다린 것이 아니라 캐시에 있는 블록을 CPU로 훑는 데 시간을 썼습니다.
Hash Join은 같은 결과를 547블록으로 냈다
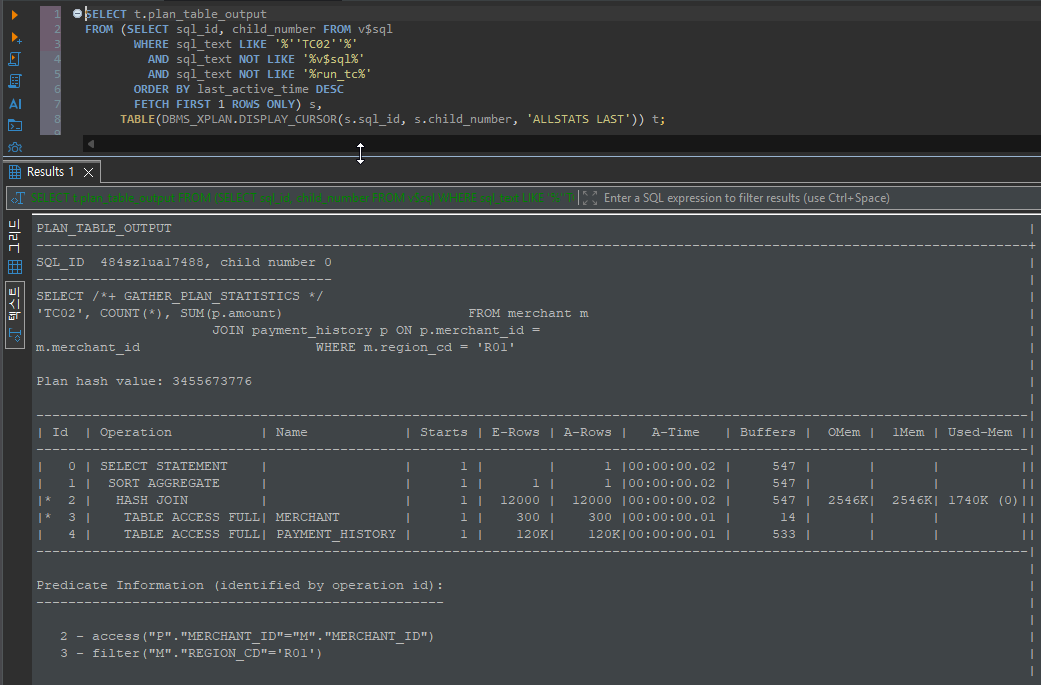
힌트를 뺀 TC02에서 옵티마이저는 Hash Join을 골랐습니다. 두 테이블을 한 번씩만 읽어 14 + 533 = 547블록이고, 해시 영역은 1,740K를 썼습니다. 세션 히트율은 TC01과 똑같이 100%였지만 logical reads는 약 292분의 1, 실행당 시간은 21.7ms로 약 109분의 1이었습니다. 히트율로는 두 SQL을 구분할 수 없습니다.
인덱스를 붙인 Nested Loop는 행 하나에 블록 하나를 읽었다
merchant_id에 인덱스를 만든 뒤, 인덱스를 쓰는 Nested Loop로 같은 조건을 실행한 것이 TC03입니다. 인덱스 통계는 BLEVEL 1, LEAF_BLOCKS 251, CLUSTERING_FACTOR 120,000이었습니다. 클러스터링 팩터가 테이블 블록 수(548)가 아니라 행 수(120,000)와 같습니다. 인덱스 순서대로 따라가면 행마다 다른 테이블 블록으로 넘어간다는 뜻입니다.
| 단계 | Starts | A-Rows | Buffers |
|---|---|---|---|
| TABLE ACCESS FULL MERCHANT | 1 | 300 | 14 |
| INDEX RANGE SCAN PAY_MERCHANT_IX | 300 | 12,000 | 326 |
| TABLE ACCESS BY INDEX ROWID PAYMENT_HISTORY | 12,000 | 12,000 | 12,000 |
| 합계 | 12,340 |
테이블 단계의 Buffers가 A-Rows와 똑같이 12,000입니다. 클러스터링 팩터가 예고한 대로 행 하나마다 블록 하나를 읽었습니다. 그래도 테이블 전체를 300번 읽는 TC01보다는 13분의 1 수준이었고, 중앙값 5cs로 끝났습니다.
아홉 번 중 히트율이 100%가 아니었던 실행은 빠른 쪽에 있었다
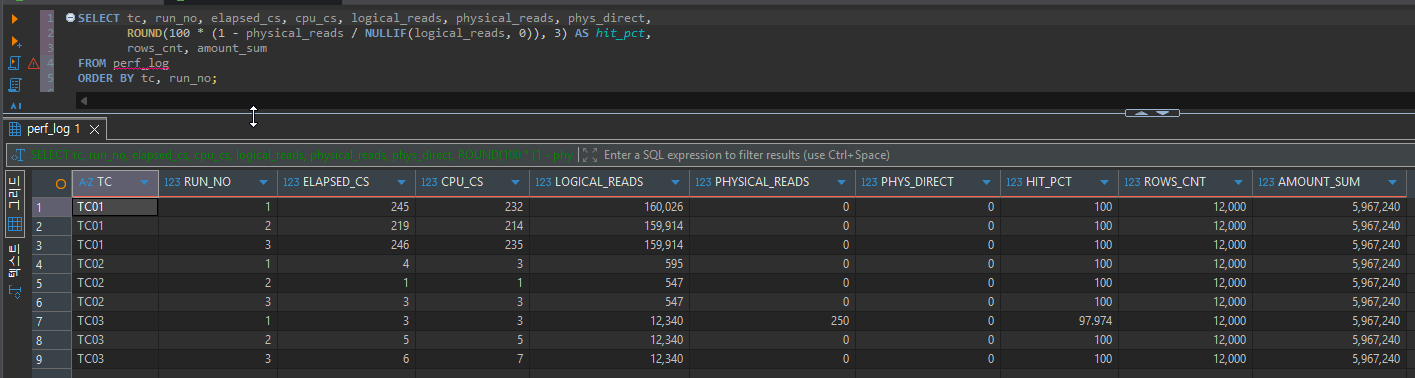
| TC | elapsed 중앙값 | CPU 중앙값 | logical reads | physical reads | 세션 히트율 |
|---|---|---|---|---|---|
| TC01 Nested Loop + 풀 스캔 | 245cs | 232cs | 159,914 | 0 | 100% |
| TC02 Hash Join | 3cs | 3cs | 547 | 0 | 100% |
| TC03 Nested Loop + 인덱스 | 5cs | 5cs | 12,340 | 1회차 250, 이후 0 | 1회차 97.974%, 이후 100% |
TC03 1회차에 디스크에서 읽은 250블록은 인덱스 리프 블록 수 251과 거의 같습니다. 방금 만든 인덱스 블록이 아직 캐시에 없어서 한 번 디스크를 읽은 것으로 보입니다. 이 실행은 히트율이 가장 낮았지만 3cs 만에 끝났습니다.
반대로 CTAS 직후에 실행한 TC01 1회차는 디스크를 읽을 것으로 예상했지만, physical reads가 0이었습니다. 통계를 수집하면서 테이블 블록이 이미 캐시에 올라간 것으로 보이며, 이 부분은 따로 확인하지 않은 추정입니다. 결과적으로 가장 느린 SQL은 세 번 내내 히트율 100%를 유지했습니다.
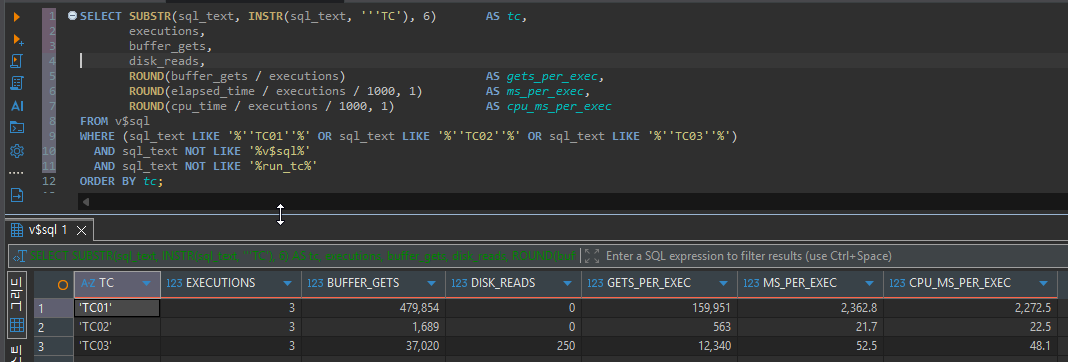
V$SQL의 실행당 평균도 같은 순서였습니다. TC01은 159,951블록에 2,362.8ms, TC03은 12,340블록에 52.5ms, TC02는 563블록에 21.7ms입니다. Disk Reads는 TC03에만 250이 있었고, TC01과 TC02는 0이었습니다. 실행 시간의 순서를 설명하는 것은 Disk Reads나 히트율이 아니라 Buffer Gets였습니다.
나쁜 SQL을 돌리고 나니 인스턴스 히트율이 올랐다
99.038%였던 인스턴스 히트율은 세 SQL을 모두 돌린 뒤 99.391%가 됐습니다. 그 시점의 누적 값은 db block gets 71,621, consistent gets 1,291,719, physical reads 8,306이었습니다. 이번 세션의 세 SQL이 V$SQL 기준으로 읽은 블록은 518,563건으로, 인스턴스 누적 logical reads의 약 38%입니다. 이 누적값에는 인스턴스 시작 이후 다른 활동도 섞여 있어서 정확한 비율은 아닙니다.
그래도 방향은 분명합니다. 디스크를 거의 읽지 않으면서 캐시 블록만 대량으로 읽는 SQL은 히트율 공식의 분모만 키웁니다. 그래서 비효율적인 SQL이 많이 돌수록 히트율이 좋아 보일 수 있습니다.
버퍼 캐시보다 큰 테이블과 동시 세션에서 달라질 수 있는 점
- 결제 테이블이 548블록이라 매 풀 스캔이 버퍼 캐시 안에서 끝났습니다. 캐시보다 큰 테이블이나 direct path read로 읽히는 테이블이라면 physical reads가 함께 늘어, 시간 구성도 CPU 위주가 아니게 됩니다.
- 세션 하나로만 측정했습니다. 같은 블록을 여러 세션이 반복해서 읽으면 latch나 버퍼 경합이 더해질 수 있는데, 이번 테스트에서는 그런 동시 부하를 재현하지 않았습니다.
- 세 SQL 모두 GATHER_PLAN_STATISTICS 힌트를 넣었기 때문에, 실행 통계 수집 부하가 시간에 조금씩 더해졌습니다. 비교 조건은 같지만 절대 시간은 힌트 없이 실행할 때보다 길 수 있습니다.
- 21c XE의 CPU 제한 아래에서 잰 시간입니다. 같은 logical reads라도 CPU가 다른 운영 서버에서는 절대 시간이 다르게 나옵니다. 그래도 세 SQL 사이의 순서는 logical reads를 따라갈 가능성이 큽니다.
느린 SQL을 볼 때 Buffer Gets부터 보는 이유
실무에서 느린 SQL을 볼 때 저는 Buffer Gets부터 봅니다. 캐시를 거쳐 읽은 블록은 Disk Reads로 읽혔더라도 Buffer Gets에 함께 잡히기 때문입니다. 그래서 최종 판단은 Buffer Gets가 많은지 적은지에 달려 있다고 보고, 튜닝도 Buffer Gets를 줄이는 데 집중해 왔습니다. direct path read로 읽은 블록은 이 규칙의 예외지만, 이번 아홉 번의 실행에서는 그런 읽기가 한 번도 없었습니다.
이번 결과는 그 기준과 그대로 맞았습니다. 세 SQL을 시간 중앙값 순으로 세우면 Buffer Gets 순서와 정확히 같았습니다. 히트율로 세우면 가장 느린 TC01과 가장 빠른 TC02가 똑같이 100%였고, 유일하게 히트율이 떨어진 실행은 빠른 쪽에 속했습니다.
이 기준에서 히트율은 인스턴스가 디스크를 얼마나 덜 읽는지 보는 참고값일 뿐입니다. 특정 SQL이 느리다는 신고가 오면 V$SQL에서 실행당 Buffer Gets와 CPU 시간을 먼저 보고, 실행계획에서 Starts가 비정상적으로 큰 단계를 찾습니다. TC01처럼 Starts 300짜리 풀 스캔이 보이면, 캐시를 늘리는 것이 아니라 조인 방식이나 접근 경로를 바꾸는 것이 해결책입니다.

댓글 0
첫 댓글을 남겨보세요.