21c에서 DEFAULT 컬럼 추가는 NOT NULL이 아니어도 2cs였다: 100만 건 redo 측정

DEFAULT 컬럼을 넣는 두 가지 방법
같은 100만 건 테이블에 'N' 값을 가진 컬럼을 넣는 두 가지 방법입니다.
-- 방법 1: 기본값을 붙여 추가
ALTER TABLE settlement_history ADD (nn_flag1 VARCHAR2(1) DEFAULT 'N' NOT NULL);

-- 방법 2: 빈 컬럼을 추가한 뒤 값을 채움
ALTER TABLE settlement_history ADD (upd_flag VARCHAR2(1));
UPDATE settlement_history SET upd_flag = 'N';
COMMIT;
방법 1은 2cs, redo 15,616바이트로 끝났습니다. 방법 2는 24.87초가 걸렸고 redo가 552,560,120바이트(약 527MB) 생겼습니다. redo로 따지면 약 3만 5천 배 차이입니다.
원래 확인하려던 것은 “DEFAULT 컬럼을 추가할 때 NOT NULL이 있어야 빠른가”였습니다. 11g 시절 설명대로라면 NULL 허용 DEFAULT 컬럼은 방법 2처럼 모든 행을 고쳐야 합니다. 21c XE에서 재 보니 그 전제부터 맞지 않았습니다.
1,000 × 1,000으로 만든 100만 건 정산 이력, 36MB에서 출발
테이블은 1,000건짜리 집합 두 개를 곱해서 만든 가상의 정산 이력입니다. CONNECT BY LEVEL <= 1000000을 한 번에 돌리면 메모리를 많이 쓸 수 있어서 이렇게 나눴습니다. 100만 건은 전체 UPDATE를 했을 때 초 단위 시간과 수백 MB redo가 분명히 드러나는 규모입니다.
CREATE TABLE settlement_history AS
SELECT ROWNUM                                   AS settle_id,
       MOD(ROWNUM-1, 5000) + 1                  AS merchant_no,
       DATE '2025-01-01' + MOD(ROWNUM, 600)     AS settle_dt,
       ROUND(MOD(ROWNUM*13, 500000) / 100, 2)   AS amount,
       CASE MOD(ROWNUM,10) WHEN 0 THEN 'HOLD' ELSE 'DONE' END AS status
FROM (SELECT LEVEL FROM dual CONNECT BY LEVEL <= 1000) a,
     (SELECT LEVEL FROM dual CONNECT BY LEVEL <= 1000) b;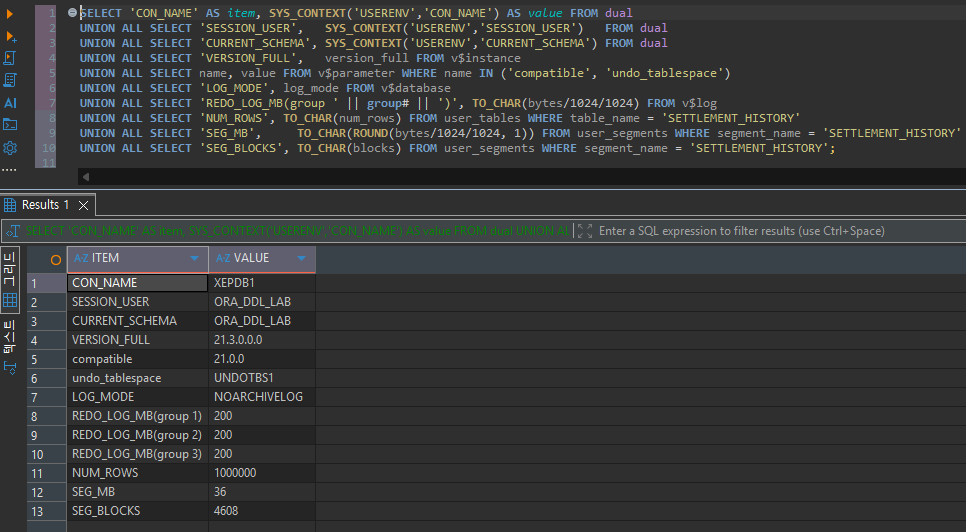
환경은 Oracle Database 21c Express Edition(21.3.0.0.0)의 XEPDB1입니다. 기본값 최적화와 관련된 compatible은 21.0.0이었습니다. 데이터베이스는 NOARCHIVELOG 모드이고, 온라인 redo 로그는 200MB짜리 3개, undo 테이블스페이스는 UNDOTBS1입니다.
문장마다 실행 직전과 직후에 V$MYSTAT의 다섯 가지 값을 읽어 그 차이를 로그 테이블에 남겼습니다. 다섯 값은 redo size, undo change vector size, db block changes, redo entries와 소요 시간입니다. 세그먼트 블록 수와 로그 스위치 횟수도 함께 기록했습니다.
순서는 NOT NULL DEFAULT 3회, NULL 허용 DEFAULT 3회, SYSDATE 기본값 1회를 먼저 하고, 모든 행을 고치는 UPDATE 방식을 마지막에 했습니다. 행을 다시 쓰는 작업이 앞선 측정에 영향을 주지 않게 하기 위해서입니다.
NOT NULL을 붙여도, 빼도 2cs였다
| 추가 방식 | 소요 시간 | redo (바이트) | db block changes | 세그먼트 블록 |
|---|---|---|---|---|
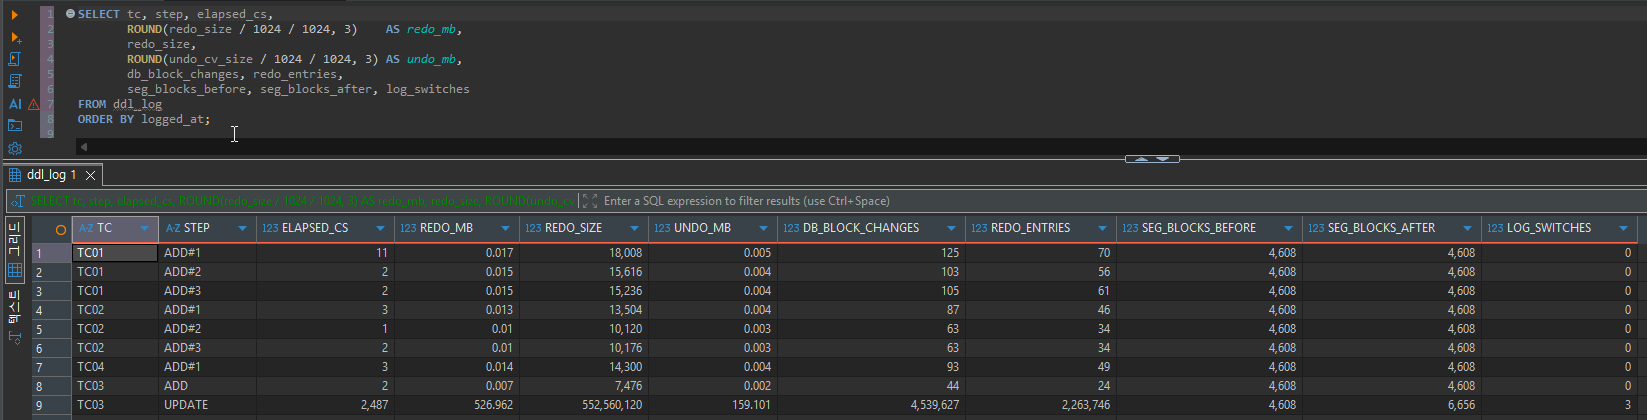
DEFAULT 'N' NOT NULL 1~3회 | 11 / 2 / 2cs | 18,008 / 15,616 / 15,236 | 125 / 103 / 105 | 4,608 그대로 |
DEFAULT 'N' (NULL 허용) 1~3회 | 3 / 1 / 2cs | 13,504 / 10,120 / 10,176 | 87 / 63 / 63 | 4,608 그대로 |
DEFAULT SYSDATE NOT NULL | 3cs | 14,300 | 93 | 4,608 그대로 |
| DEFAULT 없이 추가 (UPDATE 전) | 2cs | 7,476 | 44 | 4,608 그대로 |
세 번씩의 중앙값은 둘 다 2cs였습니다. 100만 건을 고쳤다면 나올 수 없는 숫자이고, 세그먼트 블록도 한 블록도 늘지 않았습니다. 두 방식 모두 행은 건드리지 않고 딕셔너리만 바꾼 것으로 판단했습니다.
redo는 오히려 NULL 허용 쪽이 적었습니다(중앙값 10,176바이트 대 15,616바이트). NOT NULL 제약을 기록하는 딕셔너리 변경이 조금 더 들어간 것으로 보이지만, 내부 내역까지 확인하지는 않았습니다. 첫 번째 추가만 11cs로 길었던 것도 딕셔너리를 처음 읽는 비용으로 짐작할 뿐, 확인한 것은 아닙니다.
SYSDATE 기본값도 추가한 순간의 값 하나로 고정됐다
상수가 아닌 DEFAULT SYSDATE NOT NULL도 3cs, redo 14,300바이트로 끝났습니다. 행마다 다른 시각이 들어가야 한다면 100만 건을 써야 하므로, 결과가 무거울 수도 있다고 예상했던 부분입니다. 실제로는 아래에서 보듯 100만 건 모두 같은 시각 하나로 조회됐습니다.
행에 쓰지 않은 기본값은 어디서 나오나
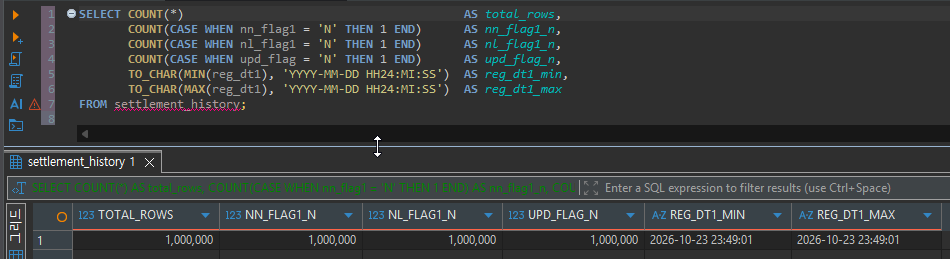
NN_FLAG1, NL_FLAG1, UPD_FLAG 모두 1,000,000건이 'N'이었습니다. UPDATE로 실제 값을 쓴 컬럼과, 딕셔너리에만 기본값이 있는 컬럼의 조회 결과가 같습니다. REG_DT1은 최솟값과 최댓값이 모두 2026-10-23 23:49:01이었습니다. SYSDATE는 컬럼을 추가한 순간 한 번만 평가된 것입니다.
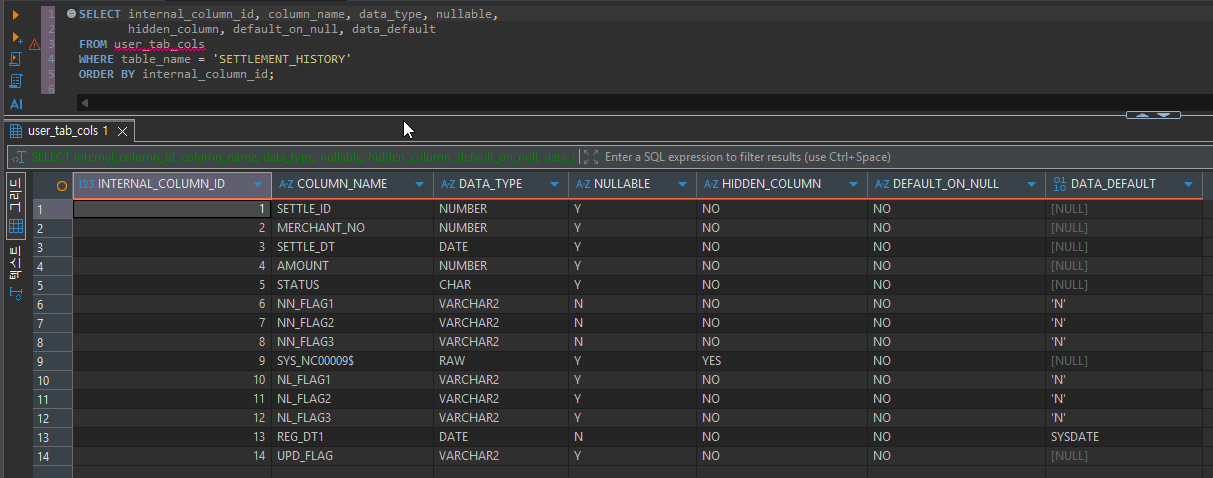
USER_TAB_COLS에는 두 방식의 차이가 보였습니다. NOT NULL DEFAULT 컬럼 세 개(NN_FLAG1~3) 뒤, 첫 NULL 허용 DEFAULT 컬럼 바로 앞에 SYS_NC00009$라는 RAW 타입 숨은 컬럼이 생겼습니다. NULL 허용 컬럼이 세 개인데 숨은 컬럼은 하나뿐입니다. NULL 허용 DEFAULT 컬럼들이 이 숨은 컬럼을 함께 쓰는 구조로 보입니다.
NULL 허용 컬럼에는 나중에 누군가 NULL을 직접 넣을 수 있습니다. 그래서 “기본값이 적용된 행인지, 일부러 NULL을 넣은 행인지”를 구분할 표시가 필요하고, 이 숨은 컬럼이 그 역할을 하는 것으로 추정합니다. NOT NULL 컬럼은 NULL이 들어올 수 없으니 그런 표시가 필요 없습니다.
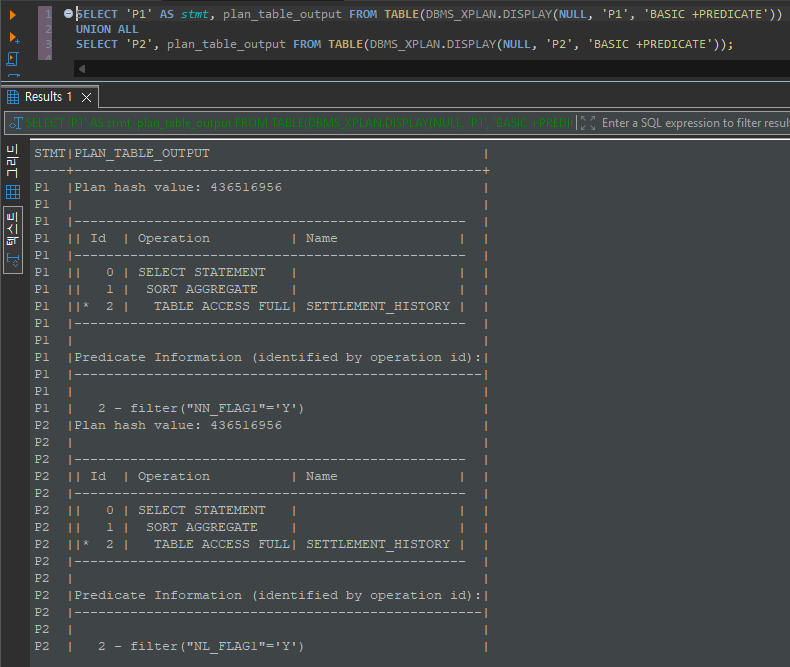
조건절은 예상과 달랐습니다. 저장되지 않은 값을 비교하려면 조건이 내부적으로 바뀔 것이라고 보고, NOT NULL 쪽은 NVL 형태를, NULL 허용 쪽은 숨은 컬럼을 참조하는 형태를 예상했습니다. 그런데 EXPLAIN PLAN의 Predicate Information에는 filter("NN_FLAG1"='Y'), filter("NL_FLAG1"='Y')로 원래 조건이 그대로 나왔습니다. 적어도 21c의 EXPLAIN PLAN 출력에서는 변환이 드러나지 않았습니다.
UPDATE 한 문장이 만든 527MB redo와 세 번의 로그 스위치
마지막 방식은 컬럼 추가 자체(2cs, redo 7,476바이트)가 네 방식 중 가장 가벼웠습니다. 비용은 전부 그 뒤 UPDATE에서 나왔습니다.
| 항목 | UPDATE 100만 건 + COMMIT | 행 하나당 |
|---|---|---|
| 소요 시간 | 2,487cs (24.87초) | |
| redo size | 552,560,120바이트 (약 527MB) | 약 552바이트 |
| undo change vector | 약 159.1MB | 약 167바이트 |
| db block changes | 4,539,627 | 약 4.5회 |
| redo entries | 2,263,746 | 약 2.3개 |
| 로그 스위치 | 3회 | |
| 세그먼트 | 4,608 → 6,656블록 (36MB → 52MB) |
200MB짜리 redo 로그 세 개를 쓰는 환경에서 527MB가 생겼으니, 로그 스위치 세 번은 숫자 그대로입니다. 이 DB는 NOARCHIVELOG라 로그가 그냥 덮어써졌습니다. ARCHIVELOG로 운영하는 DB라면 이 정도 크기의 아카이브 로그가 그대로 쌓일 수 있습니다.
세그먼트는 2,048블록, 약 44% 커졌습니다. 1바이트짜리 'N'을 행마다 써 넣으면서 행 길이가 늘었고, 기존 블록에 다 들어가지 못한 만큼 새 블록을 쓴 것입니다. 행 이주(row migration)가 얼마나 생겼는지는 따로 세지 않았습니다.
SE2 운영 DB에서 컬럼 추가 작업 시간을 잡을 때
제가 맡은 19c SE2 운영 DB에서는 컬럼 추가 같은 DDL을 서비스 사용량이 가장 적은 시간대에 합니다. SE2는 온라인 DDL에 제약이 있어서, 서비스 영향이 가장 작은 시간을 고르는 것이 기준이었습니다.
이번 결과로 보면 그 시간대에 실제로 무엇이 무거운지가 분명해집니다. 21c에서는 DEFAULT를 붙여 추가하는 한, NOT NULL이든 아니든 SYSDATE든 수 cs와 수십 KB redo로 끝났습니다. 무거운 것은 DEFAULT 없이 컬럼을 만든 뒤 UPDATE로 값을 채우는 방식 하나였고, redo 527MB와 세그먼트 44% 증가를 만들었습니다. “NOT NULL이어야 빠르다”는 판단보다 “값을 모든 행에 실제로 쓰게 되는가”를 먼저 봐야 합니다.
다만 이 결과를 운영 DB에 옮길 때는 세 가지를 따로 확인해야 합니다. 첫째, 이번 측정은 세션 하나로만 했습니다. 딕셔너리만 바꾸는 DDL도 테이블에 대한 배타적 락이 필요하므로, 그 테이블에 오래 열린 트랜잭션이 있으면 DDL이 기다리거나 실패할 수 있습니다. 이 부분은 이번에 재현하지 않았습니다. 둘째, 운영 DB가 19c라면 같은 동작인지 그 버전에서 다시 확인해야 합니다. 셋째, 추가한 뒤 딕셔너리만 바뀌었는지는 아래 두 쿼리로 바로 확인할 수 있습니다. 세그먼트 블록이 그대로이고 DATA_DEFAULT가 채워져 있으면 행은 다시 쓰이지 않은 것입니다.
SELECT column_name, nullable, hidden_column, data_default
FROM user_tab_cols
WHERE table_name = 'SETTLEMENT_HISTORY'
ORDER BY internal_column_id;

SELECT blocks, ROUND(bytes/1024/1024, 1) AS seg_mb
FROM user_segments
WHERE segment_name = 'SETTLEMENT_HISTORY';
댓글 0
첫 댓글을 남겨보세요.