작업 큐에서 FOR UPDATE SKIP LOCKED와 ROWNUM을 함께 쓰면 왜 0건이 나올까
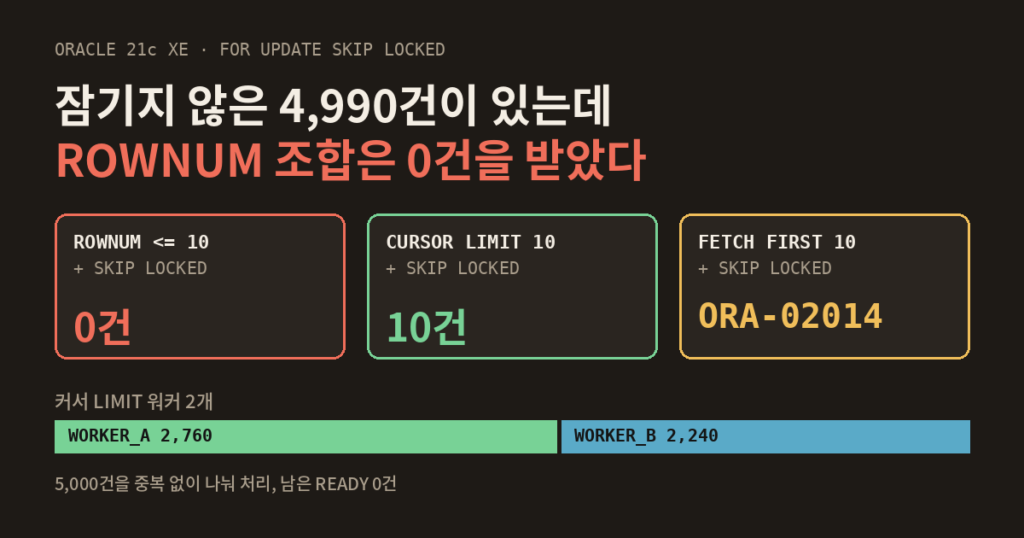
COMMIT되지 않은 10건 앞에서 세션 B가 고를 수 있는 세 가지 방법
세션 A가 메시지 큐의 10건을 FOR UPDATE로 잡고 COMMIT하지 않은 상태입니다. 세션 B가 같은 10건을 요청하는 방식만 바꿔 봤습니다.
NOWAIT: 기다리지 않고 바로ORA-00054가 났습니다. 측정된 대기 시간은 0입니다.WAIT 20: 20.01초를 기다린 뒤ORA-30006으로 끝났습니다.SKIP LOCKED: 잠긴 행을 건너뛰고 나머지를 가져갑니다. 그런데 건수를ROWNUM으로 자르자, 잠기지 않은 READY 행이 4,990건 남아 있는데도 0건이 나왔습니다.
세 옵션 중 작업 큐에 무엇을 써야 하는지, SKIP LOCKED는 어떻게 써야 세션마다 겹치지 않는 일감을 받는지 21c XE의 두 세션으로 확인했습니다.
NOWAIT와 WAIT 20의 결과는 예상대로였습니다. 반대로 확신이 없던 항목이 둘 있었습니다. FETCH FIRST와 SKIP LOCKED를 함께 쓰면 오류가 날지, 그리고 워커 두 개가 일감을 반반으로 나눌지였습니다. ROWNUM 조합이 0건을 받을 것이라는 예상은 첫 시도에서 빗나갔다가, 잠글 행을 다시 정한 뒤에야 맞았습니다.
MESSAGE_QUEUE 5,000건과 두 개의 DBeaver 세션
MESSAGE_QUEUE는 이번 테스트를 위해 만든 가상의 메시지 발송 큐입니다. 실행 환경은 Oracle Database 21c Express Edition(21.3.0.0.0)의 XEPDB1이고, 전용 계정 ORA_MQ_LAB에는 CREATE SESSION, CREATE TABLE, CREATE PROCEDURE, USERS 쿼터, 그리고 V$SESSION 조회용 SELECT_CATALOG_ROLE만 주었습니다.
큐에는 5,000건을 모두 READY 상태로 넣었습니다. PK는 msg_id이고, status에는 인덱스가 없습니다. 5,000건으로 정한 이유는 처리 시간 때문입니다. 워커가 10건씩 처리하고 배치마다 0.05초를 쉬면 전체 처리에 20초 가까이 걸립니다. 그래서 두 세션을 손으로 차례로 시작해도 함께 도는 시간이 충분히 겹칩니다.
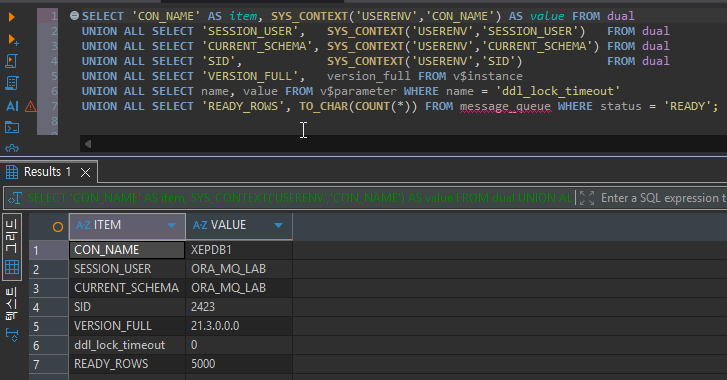
DBeaver에서 SQL 편집기 두 개를 열고, 각 편집기의 SID를 먼저 확인했습니다. A는 2423, B는 1093으로 서로 다른 세션입니다. 두 편집기 모두 수동 커밋 모드로 두었습니다. 자동 커밋이면 A가 잡은 락이 바로 풀려 확인 자체가 성립하지 않습니다.
A가 잡은 락은 아래 한 문장입니다.
SELECT msg_id, status FROM message_queue
WHERE msg_id BETWEEN 1 AND 10
FOR UPDATE;
B 쪽 시도는 모두 PL/SQL 블록으로 감쌌습니다. 오류가 나도 오류 코드, 메시지, 대기 시간(1/100초), 받은 건수가 LOCK_TRY_LOG 테이블에 남게 하기 위해서입니다.
DECLARE
  t0     NUMBER := DBMS_UTILITY.GET_TIME;
  v_ids  SYS.ODCINUMBERLIST;
  v_code NUMBER;
  v_msg  VARCHAR2(400);
BEGIN
  SELECT msg_id BULK COLLECT INTO v_ids
  FROM message_queue
  WHERE msg_id BETWEEN 1 AND 10
  FOR UPDATE NOWAIT;          -- TC32는 FOR UPDATE WAIT 20
  log_try('TC31', 0, 'OK', DBMS_UTILITY.GET_TIME - t0, v_ids.COUNT, NULL, NULL);
EXCEPTION WHEN OTHERS THEN
  v_code := SQLCODE; v_msg := SQLERRM;
  log_try('TC31', v_code, v_msg, DBMS_UTILITY.GET_TIME - t0, NULL, NULL, NULL);
END;
NOWAIT와 WAIT n은 기다리는 시간의 상한만 다르다
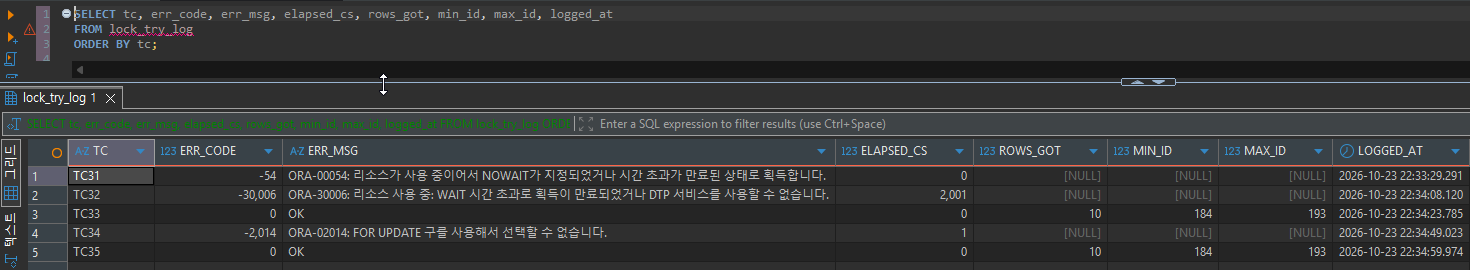
TC31(NOWAIT)의 ELAPSED_CS는 0이고, 받은 오류는 ORA-00054였습니다. 락을 얻지 못하자 기다리지 않고 바로 돌아온 것입니다.
TC32(WAIT 20)는 2,001cs, 즉 20.01초 뒤에 ORA-30006으로 끝났습니다. 두 옵션 모두 락을 얻지 못하면 오류로 돌아온다는 점은 같고, 다른 것은 기다리는 시간의 상한뿐입니다.
B가 20초를 기다리는 동안 A에서 V$SESSION을 조회했습니다. A는 락을 잡고 있을 뿐 막혀 있지 않으므로 조회할 수 있습니다.
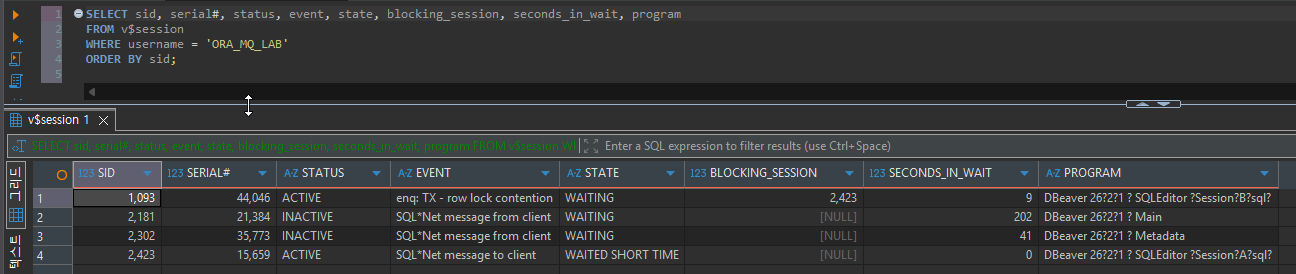
B(1093)는 enq: TX - row lock contention 이벤트로 WAITING 상태였습니다. BLOCKING_SESSION은 2423, SECONDS_IN_WAIT는 9였습니다. 조회 결과에는 DBeaver가 따로 연 Main 세션과 Metadata 세션(2181, 2302)도 같은 계정으로 함께 보였습니다. 운영에서 username만으로 세션을 걸러 보면 이런 도구 세션이 섞입니다. 그래서 EVENT와 BLOCKING_SESSION을 같이 봐야 실제 대기 관계가 드러납니다.
같은 이벤트 이름을 운영 DB의 알림으로 받은 적이 있습니다. 원인은 개발자가 쿼리를 실행한 뒤 빠뜨린 COMMIT 하나였고, 배치 프로그램이 enq: TX - row lock contention 상태로 수십 분 이상 지연됐습니다. DB에 접속해 트랜잭션이 진행 중인 세션을 쿼리로 찾았고, 개발자에게 확인한 뒤 그 세션을 KILL했습니다. 개발자도 그 세션이 COMMIT을 빠뜨린 작업이었다고 확인해 주었습니다.
그때 배치는 수십 분을 기다렸습니다. TC32처럼 대기 상한을 두면 세션은 정해진 시간 뒤 오류로 돌아옵니다. 대신 그 오류를 받은 프로그램이 재시도할지, 건너뛸지, 알림을 낼지가 미리 정해져 있어야 합니다. 상한이 있어도 원인인 미커밋 세션은 남아 있기 때문입니다.
ROWNUM으로 10건을 자르면 SKIP LOCKED가 0건을 돌려준다
워커가 처리할 10건을 잠그며 가져가는 SQL을 ROWNUM으로 쓰면 다음과 같습니다.
SELECT msg_id BULK COLLECT INTO v_ids
FROM message_queue
WHERE status = 'READY'
  AND ROWNUM <= 10
FOR UPDATE SKIP LOCKED;
첫 시도(TC33)에서는 이 쿼리가 정상적으로 10건(msg_id 184~193)을 받았습니다. 예상과 다른 결과였는데, 원인은 잠글 행을 고른 방식에 있었습니다. A가 잠근 행은 msg_id 1~10이었지만, 풀 스캔이 처음 읽는 행은 msg_id 184부터였습니다.
블록 번호를 조회해 보니 msg_id 184는 8475번 블록, msg_id 1은 8479번 블록에 있었습니다. msg_id 순서로 넣은 데이터라도 저장된 블록 순서는 그와 다를 수 있습니다. 그래서 A가 잡은 1~10은 ROWNUM이 고르는 첫 10건에 들어가지 않았습니다.
이번에는 A가 B와 같은 ROWNUM 쿼리로, 스캔 순서상 맨 앞의 10건(184~193)을 잠그게 한 뒤 다시 실행했습니다.
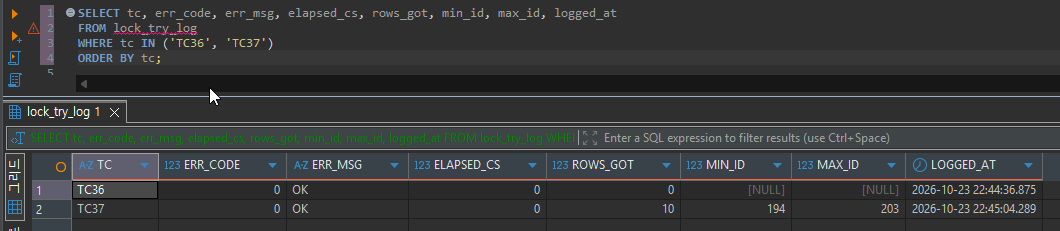
| TC | 방식 | 오류 | 받은 건수 | msg_id |
|---|---|---|---|---|
| TC36 | ROWNUM <= 10 + SKIP LOCKED | 없음 | 0 | 없음 |
| TC37 | 커서 + LIMIT 10 + SKIP LOCKED | 없음 | 10 | 194~203 |
TC36은 오류 없이 0건으로 끝났습니다. 잠기지 않은 READY 행이 4,990건 남아 있었는데도 그랬습니다. 실행계획으로 확인하지는 않았지만, 결과는 ROWNUM이 먼저 10건을 고르고 그 10건에 대해서만 잠금을 확인했을 때와 정확히 같습니다. 고른 10건이 모두 잠겨 있었으니 전부 건너뛰고 남는 것이 없습니다.
오류가 나지 않는다는 점이 더 위험합니다. 워커 입장에서는 “처리할 일이 없다”와 구분되지 않으므로, 일감이 쌓여 있는데도 쉬거나 종료할 수 있습니다.
커서 방식(TC37)은 같은 상황에서 바로 다음 10건을 받았습니다. 건수 제한이 SQL이 아니라 FETCH 단계에 있으므로, 잠긴 행을 건너뛴 뒤 10건이 찰 때까지 계속 읽습니다.
CURSOR c IS
  SELECT msg_id FROM message_queue
  WHERE status = 'READY'
  FOR UPDATE SKIP LOCKED;
...
OPEN c;
FETCH c BULK COLLECT INTO v_ids LIMIT 10;
CLOSE c;
FETCH FIRST로 바꾸면 이번에는 ORA-02014
ROWNUM 대신 FETCH FIRST 10 ROWS ONLY FOR UPDATE SKIP LOCKED를 쓴 TC34는 1cs 만에 ORA-02014로 끝났습니다. FETCH FIRST는 내부적으로 분석 함수를 쓰는 뷰 형태로 처리되는 것으로 알려져 있고, ORA-02014는 FOR UPDATE를 쓸 수 없는 뷰에서 나는 오류입니다. 21c에서는 이 조합 자체가 쓸 수 없는 방식이었습니다.
커서 LIMIT 워커 두 개가 5,000건을 2,760건과 2,240건으로 나눴다
커서 방식을 워커 프로시저로 만들어 A와 B에서 거의 동시에 실행했습니다. 핵심 루프는 다음과 같습니다.
LOOP
  OPEN c;
  FETCH c BULK COLLECT INTO v_ids LIMIT p_batch;
  CLOSE c;
  EXIT WHEN v_ids.COUNT = 0;
  v_batches := v_batches + 1;
  FORALL i IN 1 .. v_ids.COUNT
    UPDATE message_queue
       SET status = 'DONE', worker = p_worker, done_at = SYSTIMESTAMP
     WHERE msg_id = v_ids(i);
  FORALL i IN 1 .. v_ids.COUNT
    INSERT INTO msg_process_log (msg_id, worker, batch_no)
    VALUES (v_ids(i), p_worker, v_batches);
  COMMIT;
  DBMS_SESSION.SLEEP(0.05);
END LOOP;
배치마다 커서를 새로 여는 데는 이유가 있습니다. COMMIT 이후에는 FOR UPDATE 커서에서 계속 FETCH할 수 없기 때문입니다. 이 동작은 이번에 따로 확인하지 않았고, 처음부터 배치마다 다시 여는 구조로 만들었습니다.
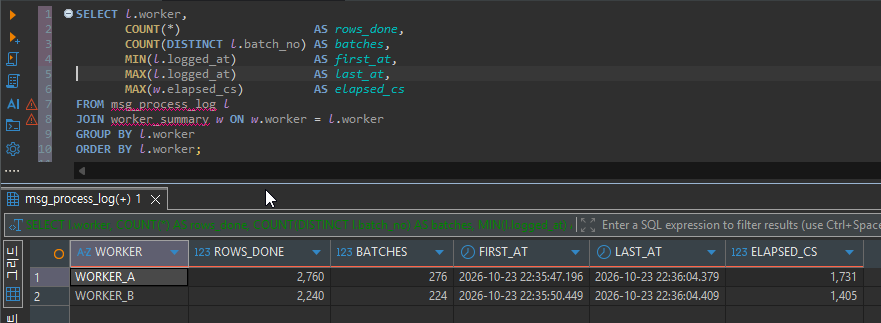
초기화한 뒤 한 번 더 실행했고, 두 번의 결과는 다음과 같습니다.
| 회차 | WORKER_A | WORKER_B | B 첫 처리 지연 | 마지막 처리 시각 차이 |
|---|---|---|---|---|
| 1차 | 2,760건 / 276배치 / 17.31초 | 2,240건 / 224배치 / 14.05초 | 약 3.25초 | 0.03초 |
| 2차 | 2,950건 / 295배치 / 18.42초 | 2,050건 / 205배치 / 12.80초 | 약 5.64초 | 0.02초 이내 |
B가 늦게 시작한 만큼 A가 더 많이 처리했습니다. 반면 두 워커는 매번 거의 같은 순간에 끝났습니다. 함께 도는 동안에는 남은 일감을 나눠 가져갔다는 뜻입니다. SKIP LOCKED 워커의 세션별 처리 건수는 미리 정해지는 몫이 아닙니다. 각 워커가 언제 시작했고 얼마나 빨리 도는지에 따라 정해집니다.
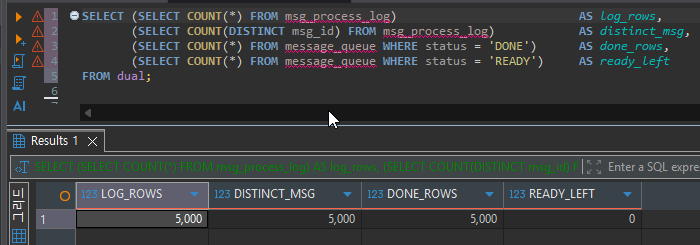
처리 로그 5,000건과 DISTINCT msg_id 5,000건이 같으므로, 두 워커가 같은 메시지를 처리한 경우는 없었습니다. DONE은 5,000건, 남은 READY는 0건으로 누락도 없었습니다.
처리 순서·status 인덱스·워커 장애에서 더 볼 부분
- 처리 순서: 워커 커서에 ORDER BY를 넣지 않았습니다. 그래서 처리 순서는 msg_id 순이 아니라 스캔 순서를 따릅니다. 앞에서 본 것처럼 그 순서는 msg_id와 다를 수 있습니다. 먼저 들어온 메시지를 먼저 처리해야 하는 큐라면 정렬 조건을 넣고 다시 검증해야 합니다.
- 인덱스: status에 인덱스가 없으므로, 매 배치가 DONE 행까지 포함해 테이블을 다시 읽었을 것으로 봅니다. 실행계획은 확인하지 않았습니다. 처리 완료 행이 수백만 건 쌓인 큐에서는 같은 방식이 점점 느려질 수 있습니다.
- 장애 상황: 워커가 처리 중에 죽는 경우는 재현하지 않았습니다. COMMIT 전이라면 롤백되어 READY로 돌아가지만, 외부 발송까지 끝난 뒤 죽는 경우는 DB만으로 막을 수 없습니다.
- 규모: 세션 2개, 배치 10건, 21c XE의 CPU와 메모리 제한 아래에서 얻은 결과입니다. 워커 수가 늘거나 처리 시간이 길어지면 세션별 건수 분포도 달라집니다.
대기 옵션을 고르는 기준과 FOR UPDATE 검토
세 옵션은 쓰임새가 다릅니다. 이번 결과를 상황별로 나누면 다음과 같습니다.
| 상황 | 선택 | 이번에 본 근거 |
|---|---|---|
| 여러 워커가 같은 큐를 나눠 처리 | SKIP LOCKED + 커서 FETCH ... LIMIT | ROWNUM 조합은 오류 없이 0건, FETCH FIRST 조합은 ORA-02014. 커서 방식은 5,000건을 중복 없이 처리 |
| 특정 행을 꼭 처리해야 하고 잠깐 기다릴 수 있음 | WAIT n | 20초 지정에 20.01초 뒤 ORA-30006. 오류를 받은 뒤의 처리는 프로그램이 정해 둬야 함 |
| 화면 수정 버튼처럼 즉시 응답이 필요함 | NOWAIT | 0cs 만에 ORA-00054. 다른 사용자가 편집 중이라는 안내로 바꿔 보여 주는 용도 |
어느 옵션도 락을 잡고 있는 쪽을 해결해 주지는 않습니다. 대기가 길어지면 V$SESSION의 EVENT와 BLOCKING_SESSION으로 원인 세션부터 찾아야 하고, COMMIT 누락처럼 사람의 실수가 원인이면 대기 옵션으로는 끝나지 않습니다.
SELECT … FOR UPDATE를 검토할 때 먼저 보는 것
운영에서 SQL을 검토하다 SELECT ... FOR UPDATE를 보면, WHERE 조건으로 잠금 대상이 충분히 좁혀지는지와 COMMIT·ROLLBACK 위치를 먼저 확인합니다. 특히 잠금을 잡은 상태에서 외부 호출이나 긴 처리가 이어지는지, 예외가 났을 때 트랜잭션이 정리되는지, 다른 업무와 잠금 순서가 충돌하지 않는지를 중점적으로 봅니다.
이번 워커를 그 기준에 비춰 보면, 잠금 대상은 SKIP LOCKED와 LIMIT 10으로 배치마다 10건으로 좁혀졌고, COMMIT은 UPDATE와 처리 로그 INSERT 바로 뒤에 있습니다. SLEEP도 COMMIT 다음이라 잠금을 쥔 채 쉬지 않습니다. 반면 실제 발송 큐라면 FETCH와 COMMIT 사이에 외부 발송이 들어가 잠금을 쥔 시간이 길어지고, 처리 중 장애가 났을 때의 정리는 이번에 재현하지 않았습니다. 운영 코드에서는 이 두 곳이 먼저 걸릴 부분입니다.
작업 큐라면 하나를 더 보는 편이 안전합니다. 같은 SKIP LOCKED라도 건수를 ROWNUM으로 자르면, 잠기지 않은 4,990건을 두고도 오류 없이 0건을 받을 수 있기 때문입니다.

댓글 0
첫 댓글을 남겨보세요.