컬럼 그룹 통계를 만들자 없는 조합의 예상 행 수가 60에서 1,200으로 커졌다

지역과 도시를 함께 거는 집계 쿼리의 예상 행 수
지역 코드와 도시 코드를 함께 거는 단순한 집계 쿼리입니다.
SELECT /*+ GATHER_PLAN_STATISTICS */ 'TC01' AS tc, COUNT(*) AS cnt
FROM delivery_history
WHERE region_cd = 'R03'
  AND city_cd   = 'C025';
통계는 전체 건수로 수집한 직후였고, 단일 컬럼의 NDV도 실제와 같았습니다. 그런데 DISPLAY_CURSOR로 본 TABLE ACCESS FULL 단계의 E-Rows는 60, A-Rows는 1,200이었습니다. 도시 C025는 R03 지역에만 속합니다. 도시 조건을 만족하는 행은 지역 조건도 자동으로 만족하는데, 옵티마이저는 이 관계를 모릅니다.
이 차이를 21c XE에서 재현하고, 컬럼 그룹 통계(확장 통계)를 만든 전후로 E-Rows가 어떻게 바뀌는지 확인했습니다.
도시 200개가 지역 20개에 묶인 가상 배송 이력 240,000건
데이터는 배송 이력을 가정한 가상 데이터입니다. Oracle Database 21c Express Edition(21.3.0.0.0)의 XEPDB1에 전용 계정 ORA_CG_LAB을 만들고 DBeaver에서 실행했습니다. 이 계정에 준 권한은 네 가지뿐입니다. CREATE SESSION, CREATE TABLE, USERS 테이블스페이스 쿼터, 그리고 DISPLAY_CURSOR와 V$SQL 조회를 위한 SELECT_CATALOG_ROLE입니다.
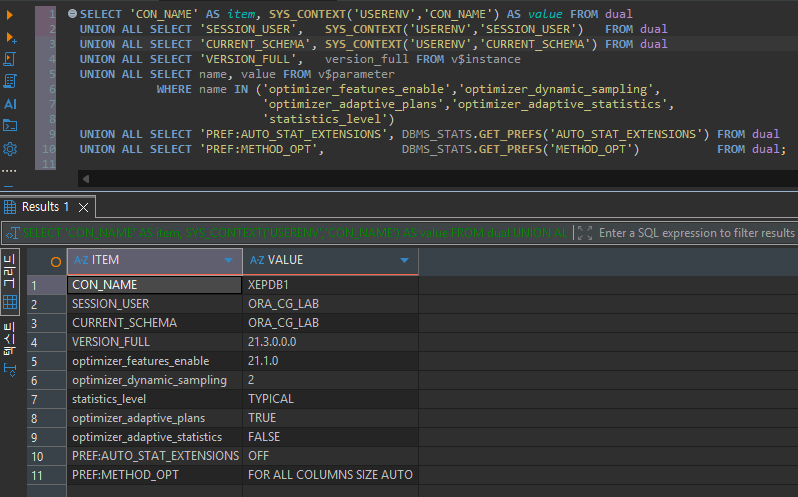
캡처의 값 중 이번 확인에 직접 걸리는 것은 세 가지입니다.
optimizer_adaptive_statistics가 FALSE입니다.- 확장 통계를 자동으로 만드는
AUTO_STAT_EXTENSIONS가 OFF입니다. 컬럼 그룹이 저절로 생기지 않는 환경이라는 뜻입니다. - METHOD_OPT 기본값이
FOR ALL COLUMNS SIZE AUTO입니다. 이 값은 아래 통계 수집에서 일부러 바꿨습니다.
데이터는 난수 없이 만들었습니다. 도시 코드 C001~C200에 1,200건씩 균등하게 돌아가고, 도시 10개마다 지역 코드 하나가 붙습니다. 240,000건을 고른 이유는 도시 하나당 정확히 1,200건이 되기 때문입니다. 그러면 독립 가정 추정치(60)와 실제값의 차이가 정확히 20배로 떨어집니다.
CREATE TABLE delivery_history AS
SELECT LEVEL AS delivery_id,
       CAST('R' || LPAD(CEIL((MOD(LEVEL-1,200)+1)/10), 2, '0') AS VARCHAR2(3)) AS region_cd,
       CAST('C' || LPAD(MOD(LEVEL-1,200)+1, 3, '0') AS VARCHAR2(4))            AS city_cd,
       DATE '2026-01-01' + MOD(LEVEL, 270)                                    AS delivery_dt,
       CASE WHEN MOD(LEVEL,10) < 8 THEN 'DONE'
            WHEN MOD(LEVEL,10) = 8 THEN 'DELAY'
            ELSE 'RETURN' END                                                  AS status_cd,
       MOD(LEVEL*7, 300) / 10                                                  AS weight_kg
FROM dual
CONNECT BY LEVEL <= 240000;
인덱스는 일부러 만들지 않았습니다. 두 컬럼에 복합 인덱스가 있으면 옵티마이저가 인덱스의 DISTINCT_KEYS를 추정에 참고할 수 있어서, 컬럼 그룹의 효과와 섞입니다.
조회를 COUNT(*)로 한 데도 따로 이유가 있습니다. DBeaver는 결과를 200행씩 가져오기 때문에 1,200행을 그대로 받으면 A-Rows가 덜 나올 수 있습니다.
BEGIN
  DBMS_STATS.GATHER_TABLE_STATS(
    ownname       => 'ORA_CG_LAB',
    tabname       => 'DELIVERY_HISTORY',
    method_opt    => 'FOR ALL COLUMNS SIZE 1',
    no_invalidate => FALSE);
END;
METHOD_OPT를 SIZE 1로 고정해 히스토그램이 생기지 않게 했습니다. 기본값인 SIZE AUTO로 두면 테스트 쿼리가 남긴 컬럼 사용 기록 때문에 재수집 때 히스토그램이 생길 수 있습니다. 그러면 바뀌는 조건이 컬럼 그룹 하나가 아니라 두 개가 됩니다.
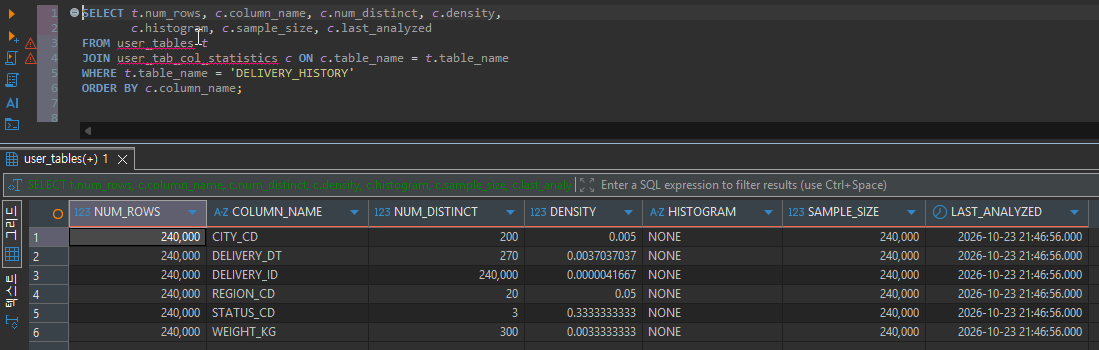
NUM_ROWS와 SAMPLE_SIZE가 모두 240,000이므로 전체 건수 기준 통계입니다. 두 컬럼의 통계는 다음과 같고, HISTOGRAM은 모두 NONE입니다.
- REGION_CD: NDV 20, DENSITY 0.05
- CITY_CD: NDV 200, DENSITY 0.005
COUNT(DISTINCT)로 직접 센 지역-도시 조합 수도 200개였습니다. 단일 컬럼 통계에는 틀린 값이 하나도 없습니다.
옵티마이저는 0.05와 0.005를 그대로 곱했다
TC01의 E-Rows 60은 두 컬럼의 DENSITY를 곱한 값과 정확히 같습니다.
240,000 × 0.05 × 0.005 = 60
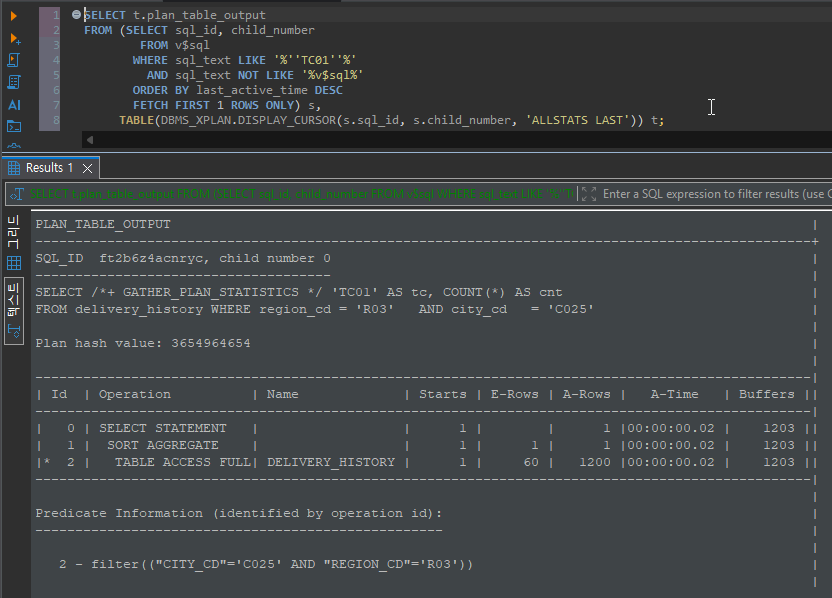
Predicate Information에는 두 조건이 하나의 filter로 묶여 있습니다. 하지만 추정은 각 컬럼의 선택도를 서로 독립으로 보고 곱한 값입니다. 실제로는 C025를 만족하는 1,200행이 전부 R03이므로, 지역 조건은 행을 하나도 걸러내지 못합니다.
존재하지 않는 조합도 넣어 봤습니다. C155는 R16 소속인데, 이를 R03과 함께 조회한 것이 TC02입니다. E-Rows는 똑같이 60, A-Rows는 0이었습니다. 독립 가정에서는 R03+C025와 R03+C155가 구분되지 않습니다.
같은 SQL을 두 번 실행하자 child 커서가 하나 더 생겼다
추정이 20배 틀린 커서가 재실행 때 어떻게 되는지도 확인했습니다. 주석 없이 SELECT 문만 선택해, 같은 텍스트로 두 번 실행한 TC11의 V$SQL 결과입니다.
| SQL_ID | CHILD_NUMBER | EXECUTIONS | PLAN_HASH_VALUE | IS_REOPTIMIZABLE |
|---|---|---|---|---|
| 2g465qndu0r2j | 0 | 1 | 3654964654 | Y |
| 2g465qndu0r2j | 1 | 1 | 3654964654 | N |
첫 실행 커서(child 0)는 IS_REOPTIMIZABLE이 Y로 표시됐습니다. 두 번째 실행은 그 커서를 재사용하지 않고, 같은 SQL_ID 아래 child 1로 새로 파싱됐습니다. 실행계획 해시는 그대로였습니다.
optimizer_adaptive_statistics가 FALSE인데도 재최적화가 일어났습니다. 이 파라미터가 단일 테이블 추정에 대한 통계 피드백까지 막지는 않는 것으로 보입니다. 다만 이것은 결과에서 내린 추정입니다.
child 1의 E-Rows는 확보하지 못했습니다. 경위는 이렇습니다.
- 컬럼 그룹을 만든 뒤
NO_INVALIDATE => FALSE로 통계를 재수집했습니다. - 그 뒤 이 SQL_ID를 조회하자 V$SQL은 0건, DISPLAY_CURSOR는
cannot be found를 돌려줬습니다. 재수집이 기존 커서를 무효화한 결과로 보입니다. - 컬럼 그룹을 지우고 다시 실행한 TC12도 첫 실행에서 E-Rows 60, IS_REOPTIMIZABLE Y로, TC11의 child 0과 같은 상태였습니다.
이 과정에서 DBeaver의 실행 범위가 SQL_ID를 바꾼다는 점도 드러났습니다. 스크립트 위쪽 주석과 함께 실행한 TC01은 a4f1hrwzsw80s, SELECT만 실행한 TC01은 ft2b6z4acnryc로 SQL_ID가 달랐습니다. 같은 커서의 재실행을 관찰하려면 실행 범위를 매번 똑같이 맞춰야 합니다.
CREATE_EXTENDED_STATS 한 번이면 존재하는 조합은 정확히 맞았다
SELECT DBMS_STATS.CREATE_EXTENDED_STATS('ORA_CG_LAB', 'DELIVERY_HISTORY',
                                        '(REGION_CD, CITY_CD)') AS ext_name
FROM dual;
반환된 이름은 SYS_STU01V4XUX07SX7R21Z10LSSXO입니다. 두 컬럼을 묶은 숨은 가상 컬럼이 생기고, 앞과 같은 방식으로 재수집하면 이 가상 컬럼에도 통계가 쌓입니다.
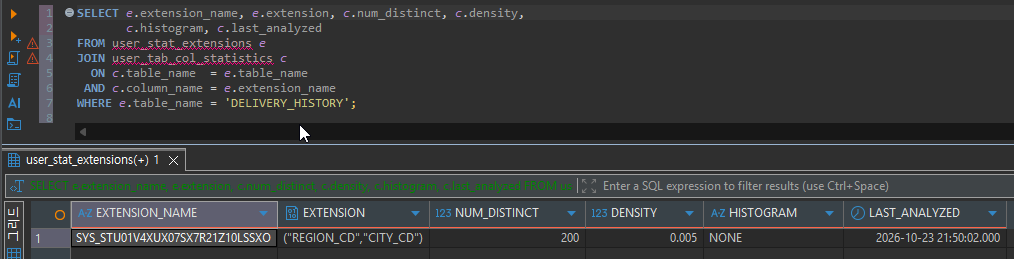
컬럼 그룹의 NUM_DISTINCT는 200, DENSITY는 0.005, HISTOGRAM은 NONE입니다. 같은 조건을 TC03 태그로 다시 실행했습니다.
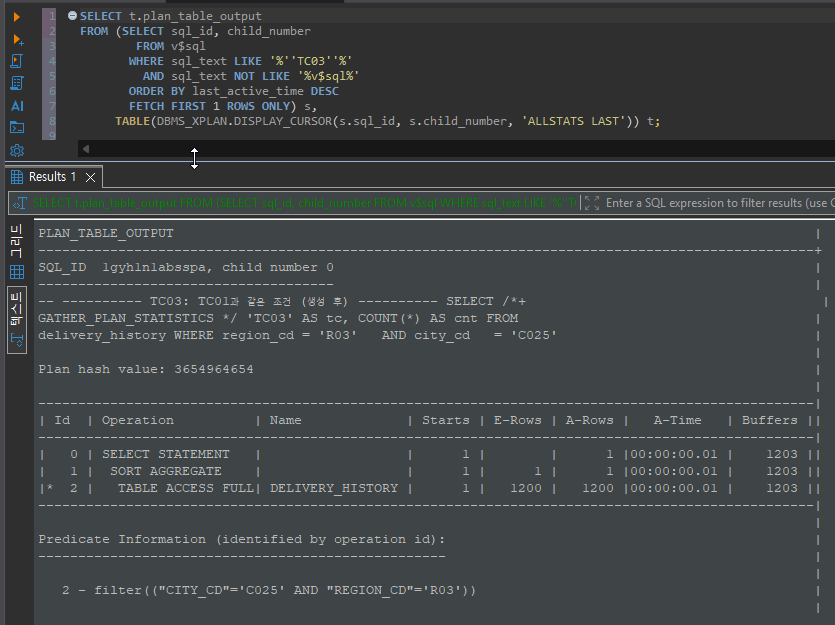
E-Rows 1,200, A-Rows 1,200입니다. 계산식은 240,000 × 0.005 = 1,200입니다. 두 컬럼의 선택도를 따로 곱하지 않고, 조합 하나의 선택도를 그대로 썼습니다.
없는 조합의 예상 행 수는 60에서 1,200으로 커졌다
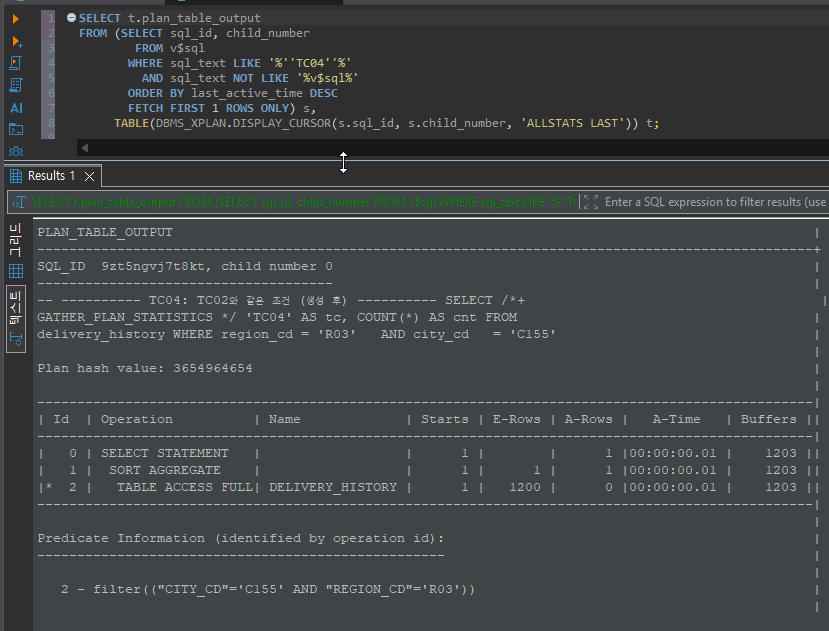
TC02와 같은 R03+C155 조건입니다. 실제 결과는 여전히 0행인데 E-Rows는 1,200이 됐습니다. 생성 전에도 60 대 0으로 과대 추정이었는데, 생성 후에는 같은 방향으로 20배 더 커졌습니다.
| 조건 | 컬럼 그룹 | E-Rows | A-Rows |
|---|---|---|---|
TC01 R03+C025 (존재) | 없음 | 60 | 1,200 |
TC02 R03+C155 (없음) | 없음 | 60 | 0 |
TC03 R03+C025 (존재) | 있음 | 1,200 | 1,200 |
TC04 R03+C155 (없음) | 있음 | 1,200 | 0 |
컬럼 그룹 통계가 아는 것은 조합의 개수(200)입니다. 어떤 조합이 실제로 있는지는 모릅니다. 히스토그램이 없으면 들어온 조합이 존재한다고 보고 조합당 평균 행 수를 돌려줍니다.
화면 검색처럼 사용자가 지역과 도시를 따로 고르는 조건이라면, 없는 조합이 실제로 들어올 수 있습니다. 그런 쿼리는 컬럼 그룹을 만든 뒤 추정이 오히려 나빠집니다.
IN 목록에서도 컬럼 그룹은 쓰였다
도시 조건을 IN 목록으로 바꾸면 컬럼 그룹이 빠지고 독립 가정으로 돌아갈 것이라고 예상했습니다. 컬럼 그룹을 지운 상태(TC15)와 다시 만든 상태(TC25)에서 같은 조건을 비교했습니다.
SELECT /*+ GATHER_PLAN_STATISTICS */ 'TC25' AS tc, COUNT(*) AS cnt FROM delivery_history
WHERE region_cd = 'R03'
AND city_cd IN ('C025', 'C026');| 조건 | 컬럼 그룹 | E-Rows | A-Rows |
|---|---|---|---|
| TC15 | 없음 | 120 | 2,400 |
| TC25 | 있음 | 2,400 | 2,400 |
두 값은 각각 다음 계산과 맞아떨어집니다.
- 생성 전 120:
240,000 × 0.05 × (0.005 × 2) - 생성 후 2,400: 조합 선택도 0.005를 IN 목록의 값 두 개만큼 더한 값
Predicate에는 INTERNAL_FUNCTION("CITY_CD")로만 표시되지만, 추정에는 컬럼 그룹이 반영됐습니다. 21c에서 확인한 결과이며, 다른 버전에서도 같은지는 이번 결과로 말할 수 없습니다.
E-Rows는 20배씩 움직였지만 실행 방식은 한 번도 바뀌지 않았다
모든 조건에서 Plan hash value는 3654964654, Buffers는 1203이었습니다. 인덱스 없는 단일 테이블이라 옵티마이저가 고를 수 있는 접근 경로가 FULL SCAN 하나뿐이었기 때문입니다.
그렇다고 컬럼 그룹이 성능과 무관하다고 볼 수는 없습니다. 이 테이블이 조인의 선행 집합이 되면, 60과 1,200의 차이는 Nested Loop와 Hash Join 사이의 선택이나 조인 순서를 가를 수 있는 크기입니다.
다음 조건에서는 결과가 달라질 수 있습니다.
- 데이터가 완전 균등 분포였습니다. 특정 도시에 데이터가 몰려 있으면 평균값인 1,200 추정은 그 도시에서 다시 틀립니다. 이 경우 컬럼 그룹 히스토그램이 관여하는데, 이번에는 SIZE 1로 막았습니다.
- 두 컬럼에 복합 인덱스가 있으면 인덱스 통계가 추정에 쓰일 수 있습니다.
- 240,000건, 단일 세션, XE의 메모리와 CPU 제한 아래에서 얻은 결과입니다. 운영 부하나 바인드 변수가 섞인 상황은 재현하지 않았습니다.
여러 컬럼 조건으로 플랜이 틀어졌을 때
운영 DB에서 여러 컬럼 조건 때문에 플랜이 틀어졌을 때, 통계를 손대지 않고 해당 쿼리에만 힌트를 넣어 플랜을 고정한 적이 있습니다. 통계를 바꾸면 다른 쿼리까지 영향을 받을 수 있어서, 더 큰 장애 위험을 줄이는 쪽을 택한 판단이었습니다.
이번 결과는 그 판단의 근거를 숫자로 보여 줍니다. 컬럼 그룹은 문제 쿼리 하나가 아니라 두 컬럼을 함께 조건으로 쓰는 모든 쿼리의 추정을 바꿉니다. 컬럼 그룹 하나로 TC03은 1,200 대 1,200으로 맞았습니다. 하지만 같은 두 컬럼을 쓰는 TC04는 0행을 1,200행으로 보게 됐습니다. 재수집 직후에는 기존 커서도 V$SQL에서 사라졌습니다. 컬럼 그룹을 추가하려면 재수집이 필요하고, 그 순간 이 테이블을 참조하는 다른 SQL도 다음 실행 때 새로 파싱된다고 봐야 합니다.
그래도 컬럼 그룹을 추가하려 한다면 다음 순서로 판단하는 편이 안전합니다.
- 문제 쿼리의 조건 값이 코드 테이블에서 정해져 항상 존재하는 조합인지 확인합니다. 사용자가 값을 따로 골라 없는 조합이 들어올 수 있는 쿼리가 많다면, 컬럼 그룹이 그 쿼리들의 추정을 나쁘게 만듭니다.
- 같은 두 컬럼을 조건으로 쓰는 다른 SQL을 V$SQL이나
DBMS_STATS.REPORT_COL_USAGE로 찾아 영향 범위를 봅니다. - 운영에서 통계를 손댈 때는 늘 변경 전 통계를 먼저 백업해 둡니다. 컬럼 그룹을 추가할 때도
DBMS_STATS.EXPORT_TABLE_STATS로 백업해 되돌릴 경로를 만들어 두는 편이 안전합니다. - 영향 범위를 확인하기 어렵거나 문제 쿼리가 하나뿐이면, 테이블 단위 변경보다 힌트 같은 쿼리 단위 조치를 먼저 검토합니다.

댓글 0
첫 댓글을 남겨보세요.