통계 없는 30만 건 테이블에서 Dynamic Sampling이 놓친 300건

새 테이블의 첫 SELECT, E-Rows는 어디서 나오나
테이블을 만들고 데이터를 막 넣은 직후에는 통계가 없습니다. 그래도 첫 SELECT가 들어오면 옵티마이저는 몇 건이 나올지 숫자를 정해야 하고, 그 숫자가 실행계획의 E-Rows로 찍힙니다. 통계 대신 무엇을 근거로 삼는지, 그 근거가 언제 틀리는지를 21c XE에서 확인했습니다.
비교한 상태는 통계 없음, 샘플링 레벨 2와 AUTO, CTAS 복사본, 통계 수집 후입니다. 그중 오차가 가장 컸던 곳은 뜻밖에도 통계를 갖고 있던 CTAS 테이블이었습니다.
택배 스캔 이력 30만 건에 희귀값 두 개를 다르게 심었습니다
PARCEL_SCAN_LOG는 택배 스캔 이력을 흉내 내 만든 가상 테이블입니다. 30만 건을 넣으니 세그먼트가 4,736블록이 됐습니다. 문서상 level 2의 표본은 64블록이라, 전체의 1.4% 정도만 읽는 셈입니다. 인덱스는 일부러 만들지 않았습니다. 인덱스를 만드는 순간 인덱스 통계가 생겨, 통계가 전혀 없는 상태가 깨지기 때문입니다.
INSERT INTO parcel_scan_log (scan_id, parcel_no, hub_cd, scan_status, scanned_at, memo)
SELECT LEVEL,
       'PCL' || LPAD(LEVEL, 10, '0'),
       'HUB' || LPAD(MOD(LEVEL, 20) + 1, 2, '0'),
       CASE
         WHEN LEVEL BETWEEN 150001 AND 150300 THEN 'DAMAGED'
         WHEN MOD(LEVEL, 1000) = 0            THEN 'LOST'
         WHEN MOD(LEVEL, 100)  = 2            THEN 'RETURNED'
         WHEN MOD(LEVEL, 10)   = 1            THEN 'IN_TRANSIT'
         ELSE 'DELIVERED'
       END,
       DATE '2026-09-01' + MOD(LEVEL, 60) + MOD(LEVEL, 1440) / 1440,
       RPAD('scan memo ' || LEVEL, 60, '.')
  FROM dual
CONNECT BY LEVEL <= 300000;

COMMIT;

BEGIN
  DBMS_STATS.LOCK_TABLE_STATS(USER, 'PARCEL_SCAN_LOG');
END;
hub_cd는 20개 값이 5%씩 고르게 들어갑니다. 핵심은 scan_status의 희귀값 두 개입니다. LOST와 DAMAGED는 둘 다 정확히 300건이지만 놓인 방식이 다릅니다. 모든 측정이 끝난 뒤 값별로 차지한 블록 수를 세어 보니 차이가 분명했습니다.
| scan_status | 건수 | 걸쳐 있는 블록 수 | 배치 |
|---|---|---|---|
| DELIVERED | 266,433 | 4,541 | 전체 |
| IN_TRANSIT | 29,970 | 4,540 | 전체 |
| RETURNED | 2,997 | 2,997 | 전체에 흩어짐 |
| LOST | 300 | 300 | 1,000건마다 1건씩 흩어짐 |
| DAMAGED | 300 | 5 | 150,001~150,300번째에 몰림 |
적재는 APPEND 없는 일반 INSERT로 했습니다. 적재 시점에 통계가 생기지 않는 경로입니다. 이어서 테이블 통계를 잠갔습니다. 평일 밤 22시부터 도는 자동 통계 수집이 테스트 도중 끼어들지 못하게 하려는 것입니다. 통계를 잠가도 통계가 없다는 상태는 그대로 유지됩니다.
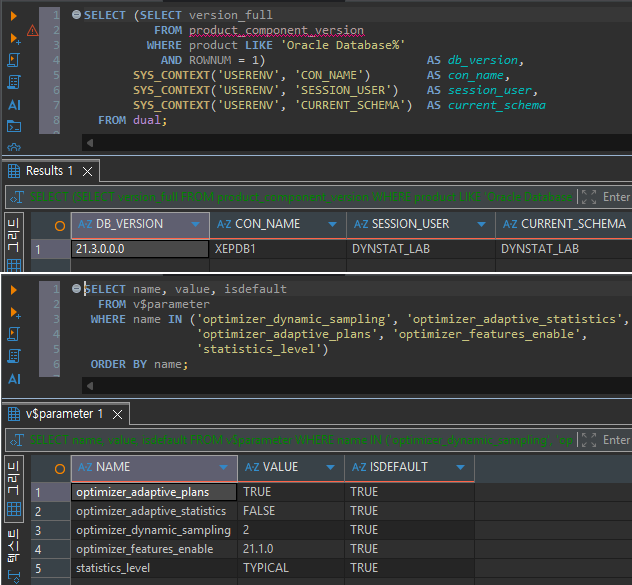
상태별 조건은 아래와 같고, 각 상태에서 같은 조건 네 개를 한 번씩 실행했습니다.
| 상태 | 내용 |
|---|---|
| S0 | 통계 없음, DYNAMIC_SAMPLING(0) 힌트로 샘플링 끔 |
| S1 | 통계 없음, 기본값 level 2 |
| S2 | 통계 없음, 세션에서 optimizer_dynamic_sampling = 11(AUTO) |
| S3 | 같은 데이터를 CTAS로 복사한 PARCEL_SCAN_LOG_CTAS |
| S4 | 원본에 DBMS_STATS로 통계 수집, scan_status에만 히스토그램 |
조건은 hub_cd = 'HUB07'(Q1), scan_status = 'DELIVERED'(Q2), 'LOST'(Q3), 'DAMAGED'(Q4)입니다. SQL마다 'TC12_S1_Q4' 같은 태그 리터럴과 GATHER_PLAN_STATISTICS 힌트를 넣었습니다. 그런 다음 V$SQL_PLAN_STATISTICS_ALL에서 E-Rows와 A-Rows를, V$SQL_PLAN의 OTHER_XML에서 샘플링 레벨을 한 번에 뽑았습니다.
모든 SQL은 한 번씩만 실행했습니다. E-Rows는 파싱할 때 정해지고, 같은 SQL을 다시 돌리면 statistics feedback으로 플랜이 바뀔 수 있기 때문입니다.
20개의 추정치를 한 화면에 놓고 보니
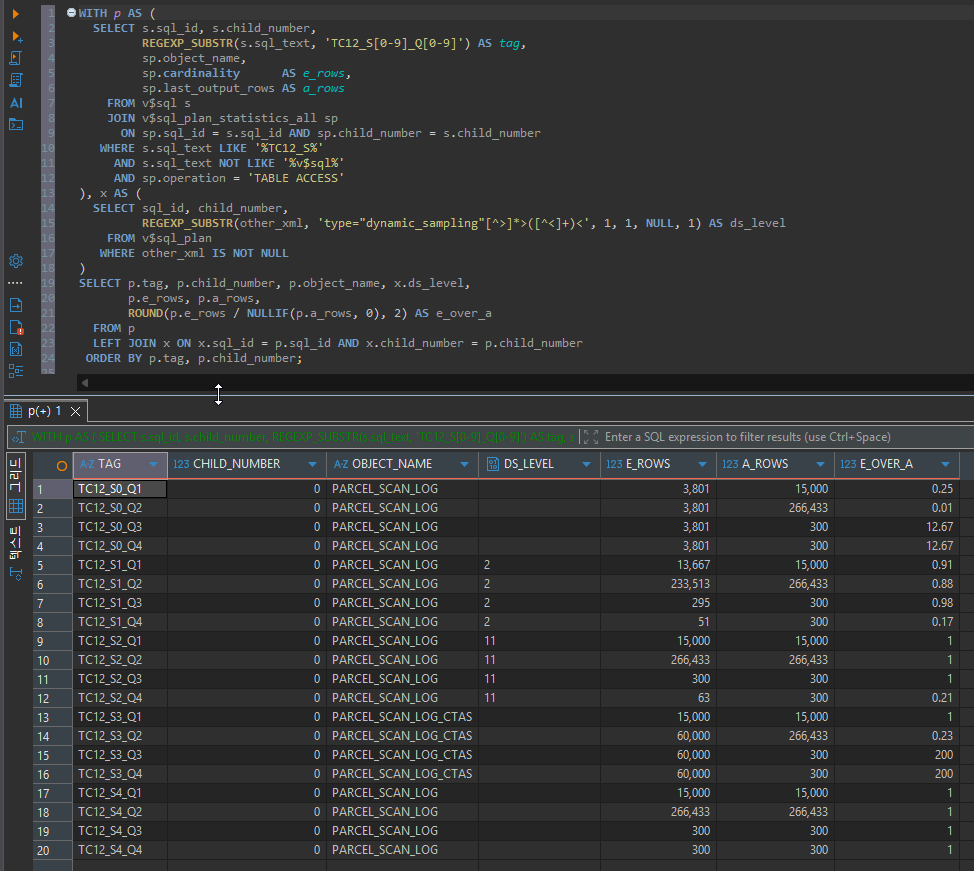
| 상태 | Q1 HUB07 (실제 15,000) | Q2 DELIVERED (266,433) | Q3 LOST (300) | Q4 DAMAGED (300) |
|---|---|---|---|---|
| S0 샘플링 끔 | 3,801 | 3,801 | 3,801 | 3,801 |
| S1 level 2 | 13,667 | 233,513 | 295 | 51 |
| S2 AUTO | 15,000 | 266,433 | 300 | 63 |
| S3 CTAS | 15,000 | 60,000 | 60,000 | 60,000 |
| S4 통계 수집 | 15,000 | 266,433 | 300 | 300 |
샘플링을 끄자 조건을 아예 보지 않았습니다
S0은 네 조건이 모두 3,801로 같았습니다. 균등한 HUB07이든, 89%를 차지하는 DELIVERED든, 300건짜리 희귀값이든 같은 숫자였습니다. 실제 대비 비율로는 DELIVERED가 0.01, 희귀값 두 개가 12.67입니다. 통계도 표본도 없으면 조건에 들어간 값을 전혀 반영하지 못한다는 뜻입니다. Note도 비어 있었습니다. 3,801은 블록 수와 기본 선택도로 계산된 값으로 짐작하지만, 계산식은 따로 따져 보지 않았습니다.
level 2는 표본 안에서 조건을 직접 세고 있었습니다
S1 쿼리 네 개를 실행한 뒤 V$SQL에서 OPT_DYN_SAMP 주석이 붙은 SQL을 찾았습니다. 옵티마이저가 파싱 중에 몰래 실행한 표본 조회입니다. 아래는 scan_status 조건용으로 만들어진 것입니다.
SELECT /* OPT_DYN_SAMP */
       /*+ ALL_ROWS IGNORE_WHERE_CLAUSE RESULT_CACHE(SNAPSHOT=3600)
           opt_param('parallel_execution_enabled', 'false')
           NO_PARALLEL(SAMPLESUB) NO_PARALLEL_INDEX(SAMPLESUB) NO_SQL_TUNE */
       NVL(SUM(C1),:"SYS_B_0"), NVL(SUM(C2),:"SYS_B_1")
  FROM (SELECT /*+ IGNORE_WHERE_CLAUSE NO_PARALLEL("PARCEL_SCAN_LOG")
                   FULL("PARCEL_SCAN_LOG") NO_PARALLEL_INDEX("PARCEL_SCAN_LOG") */
               :"SYS_B_2" AS C1,
               CASE WHEN "PARCEL_SCAN_LOG"."SCAN_STATUS"=:"SYS_B_3"
                    THEN :"SYS_B_4" ELSE :"SYS_B_5" END AS C2
          FROM "DYNSTAT_LAB"."PARCEL_SCAN_LOG"
               SAMPLE BLOCK (:"SYS_B_6" , :"SYS_B_7") SEED (:"SYS_B_8") "PARCEL_SCAN_LOG") SAMPLESUB
C1은 표본에 들어온 전체 행 수입니다. C2는 그중 조건에 맞는 행 수로, CASE WHEN으로 셉니다. 표본 전체 행 수와 조건에 맞는 행 수의 비율을 테이블 전체로 늘려 E-Rows를 만드는 구조입니다. hub_cd용 SQL은 1번, scan_status용 SQL은 3번 실행되어, S1 쿼리 네 개와 정확히 하나씩 대응합니다. 표본 크기는 바인드 변수로 가려져 SQL 텍스트에서는 보이지 않았습니다.

목록에는 OPT_DYN_SAMP가 하나 더 있습니다(20:30:51). 이 SQL은 조건을 세는 CASE 없이 행 수만 셉니다. 실행 시각이 CTAS 직전이라, CTAS가 통계 없는 원본을 읽을 때 생긴 표본 조회로 보입니다.
300건과 300건, 흩어진 쪽만 맞혔습니다
같은 300건인데 LOST는 맞히고 DAMAGED는 크게 틀린 것이 예상과 가장 달랐던 부분입니다. LOST는 300개 블록에 한 건씩 흩어져 있어 64블록 표본에도 몇 건이 잡혔고, 295로 실제와 거의 같았습니다. DAMAGED는 5개 블록에 모여 있었고, E-Rows는 51이었습니다.
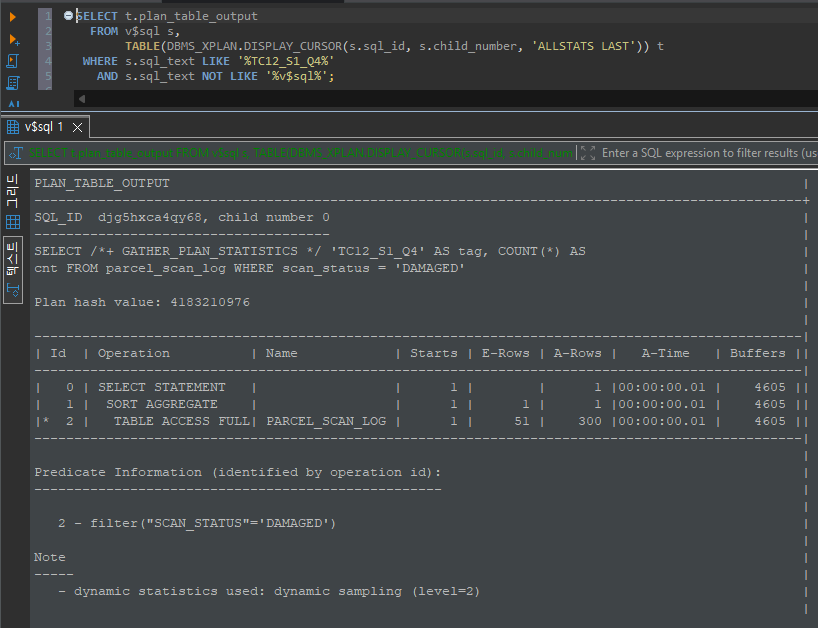
4,736블록 중 64블록을 뽑을 때 DAMAGED가 있는 5개 블록 중 하나라도 들어갈 확률은 대략 7% 안팎입니다. 표본이 DAMAGED를 한 건도 보지 못했을 가능성이 높습니다. 그런데도 E-Rows가 0이 아니라 51이 된 것은, 표본에서 못 찾았을 때 쓰는 최솟값 성격의 숫자로 보입니다. 51이 정확히 어떤 식으로 나온 값인지는 남은 질문입니다.
DAMAGED가 5개 블록에 모인 것은 행 번호 순서대로 일반 INSERT를 했기 때문입니다. 실제 테이블에서는 갱신과 삭제가 반복되면서 같은 값이 퍼지기도 하고, 특정 기간 데이터가 한곳에 모이기도 합니다. 표본 위치는 SEED와 비율로 정해지므로, 데이터 배치가 조금만 달라져도 51은 전혀 다른 값이 될 수 있습니다.
균등한 HUB07(0.91)과 DELIVERED(0.88)도 실제보다 10% 안팎 적게 나왔지만, 같은 자릿수 안이었습니다. 샘플링 레벨은 네 쿼리 모두 2로 같았고, 크게 빗나간 것은 DAMAGED 하나였습니다.
운영에서 이관 직후 쿼리가 느리면, 실행계획과 함께 LAST_ANALYZED와 NUM_ROWS부터 확인합니다. 다만 Note에 dynamic statistics가 표시됐다는 것만으로 통계 누락이 원인이라고 단정하지는 않습니다. 실행 통계를 확보해 E-Rows와 A-Rows가 크게 벌어지는 구간이 있는지를 봅니다. 이번에도 같은 레벨로 샘플링한 네 쿼리 중 문제는 하나였고, 그 하나를 가려낸 것은 E-Rows와 A-Rows의 차이였습니다.
AUTO는 표본을 네 배까지 키웠지만 DAMAGED는 63이었습니다
세션에서 샘플링 레벨을 AUTO(11)로 올리자 표본 조회가 DS_SVC 주석으로 바뀌었고, 실행계획 Note도 level=AUTO로 바뀌었습니다. 쿼리 네 개를 파싱하는 동안 표본 조회는 14번 실행됐습니다. 조건별로 나눠 보면 동작 방식이 드러납니다.
| 조건 | 표본 조회 | SAMPLE 없는 전체 카운트 | E-Rows |
|---|---|---|---|
| HUB07 | 8.59% 2회 | 1회 | 15,000 |
| DELIVERED | 8.59% 2회 | 1회 | 266,433 |
| LOST | 8.59% 2회 | 1회 | 300 |
| DAMAGED | 8.59% 2회, 17.19%, 34.38%, 31.11% | 없음 | 63 |
AUTO의 첫 표본 8.59%는 약 407블록으로, level 2의 64블록보다 6배 이상 큽니다. Q1~Q3에는 SAMPLE 절 없이 테이블 전체를 직접 센 조회가 하나씩 함께 남아 있었습니다. 세 조건의 E-Rows가 실제 건수와 한 건도 다르지 않은 것도 이 전체 카운트 결과로 보입니다.
SELECT /* DS_SVC */ /*+ dynamic_sampling(0) no_sql_tune no_monitoring
                        optimizer_features_enable(default) no_parallel  */
       NVL(SUM(C1),0)
  FROM (SELECT /*+ qb_name("innerQuery") NO_INDEX_FFS( "PARCEL_SCAN_LOG")  */ 1 AS C1
          FROM "PARCEL_SCAN_LOG" "PARCEL_SCAN_LOG"
         WHERE ("PARCEL_SCAN_LOG"."SCAN_STATUS"='LOST')) innerQuery
DAMAGED는 SEED 번호 순서로 보면 8.59%, 8.59%, 17.19%, 34.38%, 31.11%로 표본 비율을 바꿔 가며 다섯 번 조회했습니다. 가장 큰 표본은 약 1,628블록으로 첫 표본의 네 배입니다. 그래도 전체 카운트 기록은 남지 않았습니다. 다른 세 조건은 전체를 셌는데 DAMAGED만 표본에서 멈춘 기준은 이번 네 조건만으로는 드러나지 않았습니다.
통계 수집 전에 급히 실행해야 하는 SQL이 있다면, 운영에서는 DYNAMIC_SAMPLING 힌트로 추정 건수와 실행계획이 나아지는지 비교해 볼 수 있습니다. 이때도 전체 파라미터를 바꾸기보다는 해당 SQL에서 효과와 하드 파싱 부담을 확인하는 쪽으로 접근합니다. 이번 AUTO 결과가 그 이유를 보여 줍니다. 단순한 COUNT 쿼리 네 개를 파싱하는 데 표본 조회가 14번 붙었고, 그렇게 하고도 몰려 있는 300건은 맞히지 못했습니다.
CTAS로 만든 새 테이블에는 이미 통계가 있었습니다
CTAS 테이블에는 적재 시점 통계가 생길 수 있다는 정도는 알고 있었습니다. 그래도 막 만든 테이블에 행 수와 수집 시각까지 다 채워져 있는 것을 직접 보니 의외였습니다. CTAS 복사본은 만든 직후부터 NUM_ROWS 300,000, LAST_ANALYZED 20:30:52로 통계를 갖고 있었습니다. 세그먼트 블록은 원본과 같은 4,736인데, 통계상 BLOCKS는 4,628로 기록됐습니다.
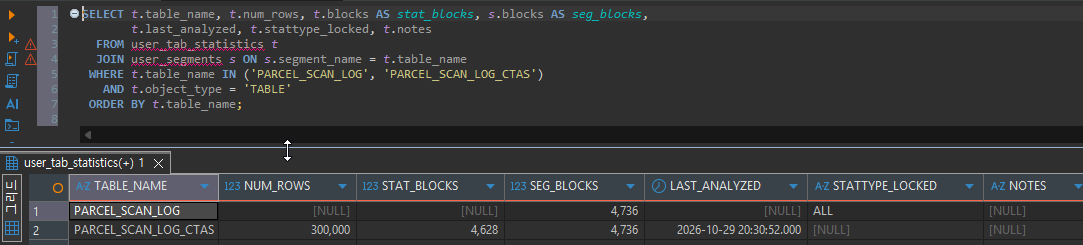
컬럼 통계의 NOTES에는 STATS_ON_LOAD가 찍혀 있었습니다. 적재하면서 함께 수집된 통계라는 표시입니다. 여기에는 NDV는 있지만 히스토그램은 없었습니다.

통계가 있으니 샘플링은 일어나지 않았고, 실행계획의 Note도 비어 있었습니다. 옵티마이저는 히스토그램 없이 NDV만 보고 값마다 같은 비율이라고 가정했습니다. 그래서 scan_status 세 조건이 모두 300,000 ÷ 5 = 60,000으로 추정됐습니다. DELIVERED는 실제의 0.23배로 적게, LOST와 DAMAGED는 200배로 많게 잡혔습니다. hub_cd는 실제 분포가 고르기 때문에 NDV가 20이라는 정보만으로 15,000을 정확히 맞혔습니다.
200배는 다섯 상태를 통틀어 가장 큰 오차입니다. 희귀값만 놓고 보면, 통계가 없을 때보다 통계가 있을 때 더 크게 틀렸습니다. 게다가 Note가 비어 있어 실행계획만 봐서는 이상하다는 단서가 보이지 않습니다.
그래서 운영에서는 CTAS 후 통계가 있다고 해서 바로 충분하다고 판단하지 않습니다. 행 수 같은 기본 통계와 히스토그램은 별개입니다. 특정 상태값에 데이터가 몰린 테이블이라면, 해당 조건의 예상 건수가 실제와 맞는지까지 확인합니다.
scan_status 히스토그램을 넣은 S4와 새 테이블에서 먼저 볼 세 곳
원본에는 scan_status에만 히스토그램을 지정해 통계를 수집했습니다. 잠금이 걸려 있어 force => TRUE를 붙였습니다.
BEGIN
  DBMS_STATS.GATHER_TABLE_STATS(
    ownname    => USER,
    tabname    => 'PARCEL_SCAN_LOG',
    method_opt => 'FOR ALL COLUMNS SIZE 1 FOR COLUMNS SIZE 254 SCAN_STATUS',
    force      => TRUE);
END;
FREQUENCY 히스토그램이 버킷 5개로 생겼습니다. S4에서는 DAMAGED 300건을 포함해 네 조건이 모두 실제와 같았습니다. AUTO가 표본을 네 배로 늘려도 못 맞힌 숫자를 통계 한 번이 맞힌 셈입니다. 통계가 있어도 컬럼 간 상관관계 때문에 E-Rows가 틀어지는 경우는 컬럼 그룹 통계와 E-Rows 글에서 따로 다뤘습니다.
AUTO가 어떤 조건에서 전체 카운트까지 가는지, 인덱스가 있거나 파티션된 테이블에서는 표본 조회가 어떻게 바뀌는지는 이번에 확인하지 않았습니다.
통계가 아예 없는 새 테이블이라면 먼저 통계를 넣고 판단합니다. 기존 테이블의 통계를 바꿔 여러 SQL에 영향을 주는 상황과는 다릅니다. 그래도 새 테이블을 이미 쓰고 있는 SQL이 있다면 수집 후 함께 확인하고, 그 뒤에도 문제가 남는 SQL에 한해 힌트를 검토합니다. 새 테이블을 넘겨받았을 때 이번 결과를 근거로 먼저 열어 볼 곳은 세 군데입니다.
USER_TAB_STATISTICS의 LAST_ANALYZED와 NUM_ROWS, 컬럼 통계의 NOTES: 비어 있으면 샘플링으로 버티는 상태이고,STATS_ON_LOAD라면 히스토그램 없는 적재 시점 통계입니다.- 실행계획 Note:
level=2는 64블록 표본,level=AUTO는 커지는 표본이나 전체 카운트입니다. Note가 없으면 통계가 있거나 샘플링이 꺼진 상태일 뿐, 추정이 정확하다는 보증은 아닙니다. - 값이 한쪽으로 몰린 컬럼의 조건: 그 조건 하나만 따로 실행해 E-Rows와 A-Rows를 맞대 봅니다.

댓글 0
첫 댓글을 남겨보세요.