실수로 DELETE한 6,599건, Flashback Query로 되살리다 만난 ORA-00001과 ORA-01555
만료 쿠폰 정리 DELETE에서 빠진 조건 하나
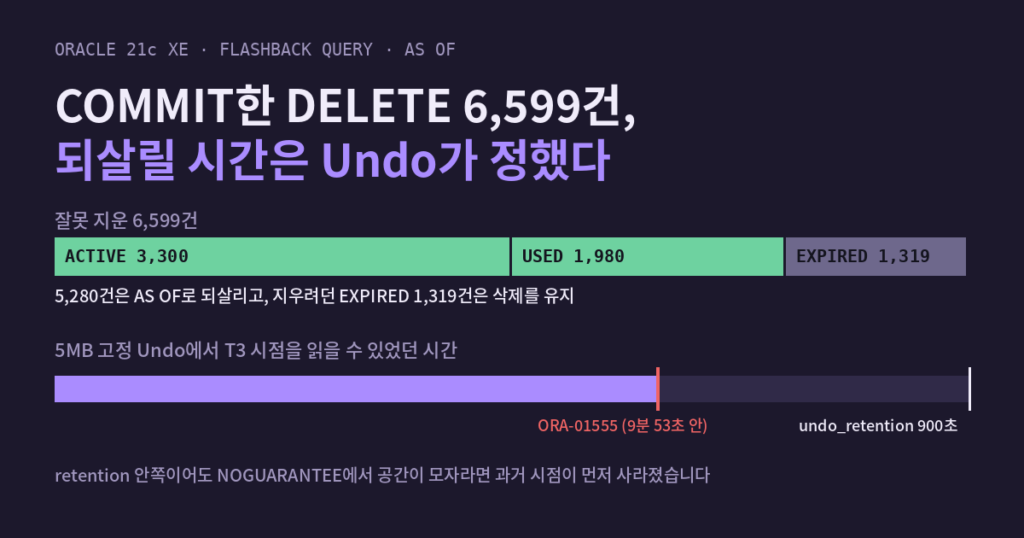
만료 쿠폰을 정리하려던 DELETE에서 status = 'EXPIRED' 조건 하나가 빠졌습니다. 21c XE에서 같은 상황을 만들어 실행하자 지워야 할 1,319건 대신 6,599건이 사라졌고, COMMIT까지 끝난 상태였습니다.
-- 의도한 문장
DELETE FROM coupon_issue
 WHERE status = 'EXPIRED' AND expire_at < DATE '2026-04-01';

-- 실제로 실행한 문장
DELETE FROM coupon_issue
 WHERE expire_at < DATE '2026-04-01';
운영에서도 삭제된 행을 복구해 달라는 요청을 받은 적이 있습니다. 다행히 undo_retention이 3시간으로 설정되어 있었고 요청도 그 시간 안에 들어왔기 때문에, Flashback Query의 AS OF TIMESTAMP로 지워진 데이터를 되살렸습니다.
그 경험을 테스트 환경에서 세 갈래로 다시 따져 봤습니다. 시각으로 지정한 시점이 실제 SCN과 얼마나 맞는지, 삭제 뒤에도 업무가 계속 들어온 테이블에서 지운 행만 골라 되살릴 수 있는지, 그리고 retention 값 안쪽이라는 사실만으로 복구가 보장되는지입니다.
쿠폰 발급 이력 30,000건과 FBQ_LAB 계정
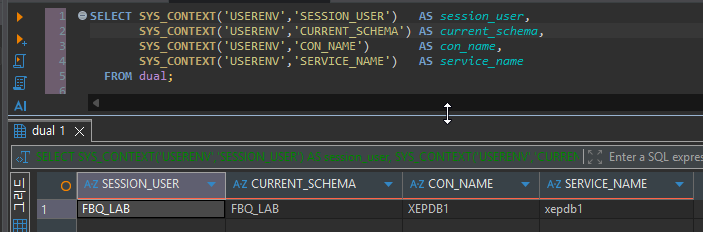
Oracle Database 21c Express Edition(21.3.0.0.0)의 XEPDB1에 테스트 전용 계정 FBQ_LAB을 만들고 DBeaver로 접속했습니다. SYSTEM 계정은 계정 생성, 권한 부여, Undo 설정 조회에만 썼습니다.
FBQ_LAB에는 CREATE SESSION, CREATE TABLE, USERS 쿼터만 주고, 조회 권한은 V_$DATABASE, V_$TRANSACTION, V_$SESSION 세 개로 제한했습니다. COMMIT 전 트랜잭션을 관찰해야 해서 DBeaver는 수동 커밋 모드로 바꿨습니다.
테이블은 쿠폰 발급 이력을 가정한 가상 데이터입니다. 30,000건이면 잘못 지워지는 행이 수천 건 규모가 되어 Undo 변화가 숫자로 드러납니다.
분포는 난수 대신 MOD로 고정했습니다. 그래서 ACTIVE 15,000건, EXPIRED 6,000건, USED 9,000건이 누가 실행해도 똑같이 나옵니다.
CREATE TABLE coupon_issue (
  issue_id    NUMBER(10)   CONSTRAINT pk_coupon_issue PRIMARY KEY,
  member_id   NUMBER(10)   NOT NULL,
  coupon_type VARCHAR2(10) NOT NULL,
  status      VARCHAR2(10) NOT NULL,
  amount      NUMBER(8)    NOT NULL,
  issued_at   DATE         NOT NULL,
  expire_at   DATE         NOT NULL,
  used_at     DATE
);

INSERT INTO coupon_issue
SELECT level,
       MOD(level, 5000) + 1,
       CASE MOD(level, 3) WHEN 0 THEN 'WELCOME' WHEN 1 THEN 'BIRTHDAY' ELSE 'EVENT' END,
       CASE WHEN MOD(level, 10) IN (0, 1)    THEN 'EXPIRED'
            WHEN MOD(level, 10) IN (2, 3, 4) THEN 'USED'
            ELSE 'ACTIVE' END,
       (MOD(level, 5) + 1) * 1000,
       DATE '2026-01-01' + MOD(level, 273),
       DATE '2026-01-01' + MOD(level, 273) + 30,
       CASE WHEN MOD(level, 10) IN (2, 3, 4) THEN DATE '2026-01-01' + MOD(level, 273) + 5 END
  FROM dual CONNECT BY level <= 30000;
COMMIT;

CREATE TABLE fbq_mark (
  label VARCHAR2(30) PRIMARY KEY,
  scn   NUMBER,
  ts    VARCHAR2(30)
);

-- 기준점마다 같은 형식으로 기록 (T0, T1, T2, T3)
INSERT INTO fbq_mark
SELECT 'T0_BEFORE_DELETE', current_scn, TO_CHAR(SYSTIMESTAMP, 'YYYY-MM-DD HH24:MI:SS.FF3')
  FROM v$database;
COMMIT;
시점 비교의 기준은 별도 테이블 FBQ_MARK에 남겼습니다. DELETE 직전(T0), 삭제 COMMIT 직후(T1), 업무 변경 직후(T2)마다 V$DATABASE.CURRENT_SCN과 시각을 함께 기록했습니다.
COMMIT 전 트랜잭션이 붙잡고 있던 6,754개의 Undo 레코드
잘못된 DELETE는 0.027초 만에 6,599건을 지웠습니다. 실행 시간만 봐서는 이상 징후를 알아챌 단서가 없습니다.
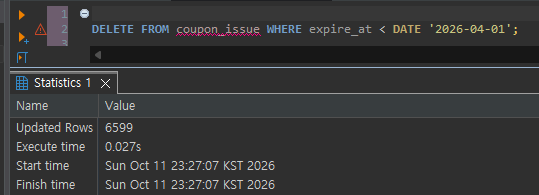
COMMIT하기 전에 같은 세션에서 V$TRANSACTION을 조회했습니다.
SELECT s.sid, t.used_urec, t.used_ublk, t.start_time, t.status
  FROM v$transaction t
  JOIN v$session s ON s.taddr = t.addr
 WHERE s.sid = SYS_CONTEXT('USERENV','SID');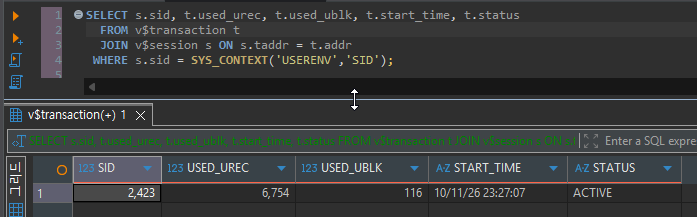
USED_UREC는 6,754개, USED_UBLK는 116개였습니다. 블록 크기가 8,192바이트이므로, 이 트랜잭션은 약 928KB의 Undo를 쓰고 있었습니다. 나중에 Flashback Query가 읽어 오는 것이 바로 이 Undo입니다.
Undo 레코드는 삭제 행 수보다 155개 많았습니다. 이 155개가 PK 인덱스 변경분인지 다른 기록인지는 이번에 나눠 보지 않았습니다.
COMMIT 후 T1을 기록하고, 사고를 모른 채 업무가 계속되는 상황을 만들었습니다. 신규 쿠폰을 300건 발급했고, 남아 있던 ACTIVE 쿠폰 중 일부를 사용 처리했습니다. 사용 처리는 234건에 적용됐고, 이어서 T2를 기록했습니다.
INSERT INTO coupon_issue
SELECT 30000 + level, MOD(level, 5000) + 1, 'EVENT', 'ACTIVE', 3000,
       TRUNC(SYSDATE), TRUNC(SYSDATE) + 30, NULL
  FROM dual CONNECT BY level <= 300;

UPDATE coupon_issue
   SET status = 'USED', used_at = SYSDATE
 WHERE status = 'ACTIVE' AND issue_id <= 30000 AND MOD(issue_id, 100) = 7;
COMMIT;
세 시점을 한 화면에 놓으면 삭제분과 업무 변경이 갈라집니다
WITH b AS (SELECT status, COUNT(*) cnt FROM coupon_issue AS OF SCN 11342882 GROUP BY status),
     a AS (SELECT status, COUNT(*) cnt FROM coupon_issue AS OF SCN 11343610 GROUP BY status),
     n AS (SELECT status, COUNT(*) cnt FROM coupon_issue GROUP BY status)
SELECT b.status, b.cnt AS scn0_before, a.cnt AS scn1_after_delete, n.cnt AS now_cnt
  FROM b
  LEFT JOIN a ON a.status = b.status
  LEFT JOIN n ON n.status = b.status
 ORDER BY b.status;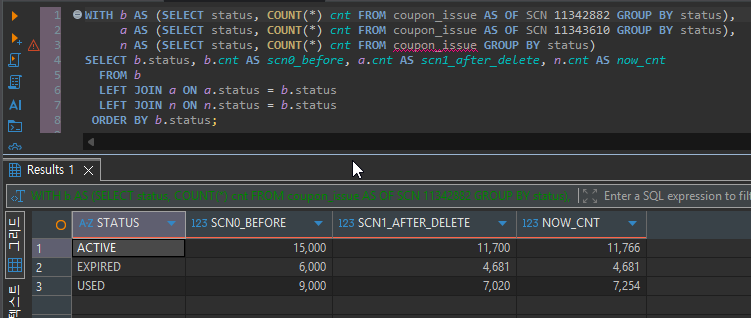
SCN0 기준으로는 삭제 전 30,000건이 그대로 보였습니다. SCN1과의 차이는 ACTIVE 3,300건, EXPIRED 1,319건, USED 1,980건입니다. 합계 6,599건으로 DELETE 건수와 정확히 맞습니다.
현재 건수에는 삭제 이후의 업무 변경이 더해졌습니다. ACTIVE는 11,700건에 신규 300건이 늘고 사용 처리 234건이 빠져 11,766건이 됐습니다. USED는 7,020건에 234건이 더해져 7,254건입니다. EXPIRED 4,681건은 삭제 직후와 현재가 같습니다.
COMMIT이 끝난 데이터라도 SCN만 정확하면 삭제 직전 상태를 그대로 읽을 수 있었습니다.
시각으로 지정해도 건수가 같았던 이유
운영 복구에서 쓴 AS OF TIMESTAMP는 지정한 시각을 SCN으로 바꿔 과거 시점을 읽습니다. 그래서 기록해 둔 시각을 TIMESTAMP_TO_SCN으로 바꿔 봤더니, 실제로 기록한 SCN과 조금씩 어긋났습니다.
| 기준점 | 기록한 SCN | 기록 시각 | TIMESTAMP_TO_SCN | 차이 |
|---|---|---|---|---|
| T0 삭제 직전 | 11,342,882 | 23:27:02.893 | 11,342,868 | -14 |
| T1 COMMIT 직후 | 11,343,610 | 23:28:59.050 | 11,343,611 | +1 |
| T2 업무 변경 직후 | 11,343,666 | 23:30:31.285 | 11,343,662 | -4 |
그런데 건수는 모두 같았습니다. SCN0과 T0는 30,000건이었고, SCN1과 T1, T1에 5초를 더한 시각은 모두 23,401건이었습니다.
이유는 시점 사이에 변경이 없었기 때문입니다. T0를 기록하고 DELETE가 시작된 23:27:07까지 약 4초 동안 테이블 변경이 없었고, T1 직후에도 업무 변경이 시작되기 전이었습니다. 매핑 오차 안에 COUPON_ISSUE 변경이 끼지 않았으니 결과가 같을 수밖에 없습니다.
반대로 삭제 직후 다른 변경이 몰려 있는 테이블이라면, 시각 지정이 엉뚱한 쪽에 떨어질 수 있다고 추정합니다. 이번에 확인한 사실은 아닙니다. 그래서 시각으로 시점을 잡았다면, 바꾼 SCN 앞뒤를 AS OF로 조회해 건수가 바뀌는 지점을 직접 확인하는 편이 안전합니다.
AS OF 결과를 통째로 넣으면 한 건도 들어가지 않습니다
가장 단순한 복구는 삭제 전 시점 전체를 다시 INSERT하는 것입니다.
INSERT INTO coupon_issue SELECT * FROM coupon_issue AS OF SCN 11342882;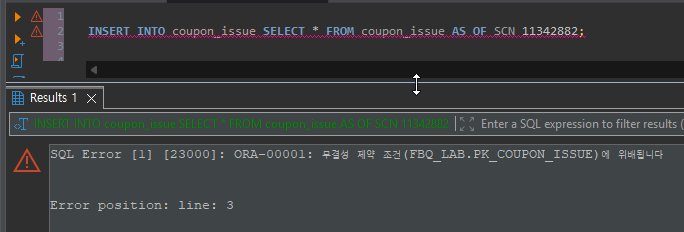
결과는 ORA-00001 무결성 제약 조건 위반이었습니다. SCN0 시점 30,000건 안에는 지워지지 않은 23,401건도 들어 있습니다. 이 행들의 ISSUE_ID가 현재 테이블의 PK와 겹친 것입니다. 문장 단위로 롤백되어 한 건도 들어가지 않았습니다. PK가 없는 테이블이었다면 오류 없이 중복 행이 쌓였을 것입니다.
그래서 지워진 행만 골라 복구용 테이블에 먼저 떠 두었습니다. 기준은 SCN0 시점에는 있었지만 지금은 없는 ISSUE_ID입니다.
CREATE TABLE coupon_issue_rcv AS
SELECT b.*
  FROM coupon_issue AS OF SCN 11342882 b
 WHERE NOT EXISTS (SELECT 1 FROM coupon_issue c WHERE c.issue_id = b.issue_id);

SELECT status, COUNT(*) AS cnt, MIN(expire_at) AS min_exp, MAX(expire_at) AS max_exp
FROM coupon_issue_rcv GROUP BY status ORDER BY status;| STATUS | 건수 | 만료일 범위 |
|---|---|---|
| ACTIVE | 3,300 | 2026-01-31 ~ 2026-03-31 |
| EXPIRED | 1,319 | 2026-01-31 ~ 2026-03-31 |
| USED | 1,980 | 2026-01-31 ~ 2026-03-31 |
세 상태의 합은 6,599건으로 DELETE 건수와 같습니다. 이 중 EXPIRED 1,319건은 원래 지우려던 행입니다. 전부 되살리면 사고 전으로 돌아가지만, 정리 작업까지 함께 취소됩니다. 그래서 의도한 삭제는 유지하고, 잘못 지운 ACTIVE와 USED만 넣었습니다. 들어간 행은 5,280건이었습니다.
INSERT INTO coupon_issue SELECT * FROM coupon_issue_rcv WHERE status <> 'EXPIRED';
COMMIT;
복구 결과는 여섯 가지 기준으로 확인했습니다.
SELECT 'A' AS chk, COUNT(*) AS cnt
  FROM coupon_issue AS OF SCN 11342882 b
 WHERE NOT (b.status = 'EXPIRED' AND b.expire_at < DATE '2026-04-01')
   AND NOT EXISTS (SELECT 1 FROM coupon_issue c WHERE c.issue_id = b.issue_id)
UNION ALL
SELECT 'B', COUNT(*) FROM coupon_issue
 WHERE status = 'EXPIRED' AND expire_at < DATE '2026-04-01'
UNION ALL
SELECT 'C', COUNT(*) FROM coupon_issue WHERE issue_id > 30000
UNION ALL
SELECT 'D', COUNT(*)
  FROM coupon_issue c
  JOIN coupon_issue AS OF SCN 11343610 a ON a.issue_id = c.issue_id
 WHERE a.status = 'ACTIVE' AND c.status = 'USED'
UNION ALL
SELECT 'E', COUNT(*) FROM coupon_issue
UNION ALL
SELECT 'F', COUNT(*) FROM coupon_issue_rcv
WHERE status = 'ACTIVE' AND MOD(issue_id, 100) = 7;| 항목 | 확인 내용 | 건수 |
|---|---|---|
| A | 살아 있어야 하는데 없는 행 | 0 |
| B | 의도한 삭제 대상 중 되살아난 행 | 0 |
| C | 삭제 후 신규 발급 보존 | 300 |
| D | 삭제 후 사용 처리 보존 | 234 |
| E | 현재 전체 건수 | 28,981 |
| F | 삭제 공백 동안 사용 처리를 못 받은 복구 행 | 66 |
A와 B가 0이므로, 살아 있어야 할 행은 모두 돌아왔고 지우려던 행은 되살아나지 않았습니다. 삭제 이후의 신규 발급 300건과 사용 처리 234건도 그대로 남았습니다. 현재 28,981건은 30,000건에서 의도한 삭제 1,319건을 빼고 신규 300건을 더한 값과 같습니다.
되살아난 66건은 사용 처리를 받지 못한 상태로 돌아왔습니다
F 항목이 이번 결과에서 가장 불편한 숫자입니다. MOD(issue_id, 100) = 7인 ACTIVE 쿠폰은 원래 300건이었습니다. 그런데 사용 처리가 실행될 때 그중 66건은 이미 삭제된 상태였고, 그래서 234건만 처리됐습니다. 복구된 66건은 삭제 직전의 ACTIVE 그대로 돌아왔습니다.
데이터베이스 관점에서는 정확한 복구입니다. 하지만 업무 관점에서 이 66건은 사고가 없었다면 USED였을 행입니다. Flashback Query가 되살리는 것은 삭제 직전의 행이고, 삭제된 동안 적용됐어야 할 변경까지 만들어 주지는 않습니다. 삭제부터 복구까지의 공백이 길수록 이런 행은 늘어날 수 있습니다. 그러니 복구 전에 그 기간에 실패한 업무 처리가 있는지 업무 담당자와 함께 확인해야 합니다.
undo_retention 900초 안인데 10분을 버티지 못한 과거 시점
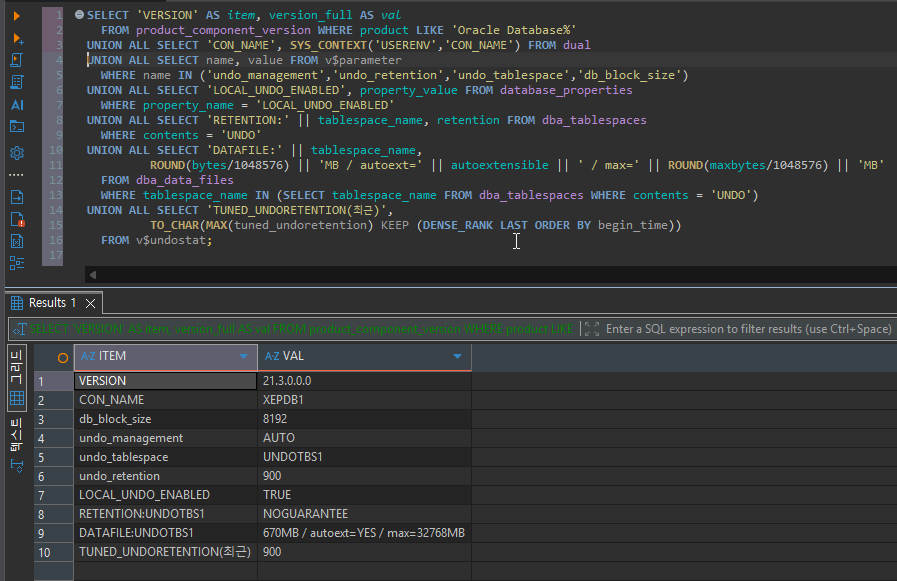
테스트 PDB의 undo_retention은 900초였고, UNDOTBS1은 RETENTION NOGUARANTEE였습니다. 데이터파일은 670MB에 자동 확장이 켜져 있어 최대 32,768MB까지 늘어날 수 있었습니다. NOGUARANTEE는 Undo 공간이 모자랄 때, retention 시간이 지나지 않은 Undo도 다른 트랜잭션이 가져다 쓸 수 있다는 뜻입니다.
시간 한계의 첫 번째 경계는 테이블 자체였습니다. 하루 전 시각으로 조회하자 ORA-01466이 나며 테이블 정의가 변경되어 데이터를 읽을 수 없다는 메시지가 나왔습니다. 테이블이 생기기 전 시점은 Undo가 남아 있는지와 상관없이 읽을 수 없습니다.
두 번째 경계는 Undo 공간입니다. 670MB 자동 확장 환경에서는 덮어쓰기를 재현하기 어려워, XEPDB1에 5MB 고정 크기 Undo 테이블스페이스를 만들고 메모리 범위로만 전환했습니다.
-- SYSTEM / XEPDB1 : 5MB 고정 Undo로 전환
CREATE UNDO TABLESPACE undo_fbq
  DATAFILE '<UNDOTBS1과 같은 폴더>\UNDO_FBQ01.DBF' SIZE 5M AUTOEXTEND OFF;
ALTER SYSTEM SET undo_tablespace = undo_fbq SCOPE = MEMORY;

-- FBQ_LAB : 덮어쓰기용 테이블, 기준점 T3, 두 번째 삭제
CREATE TABLE churn_pad (id NUMBER PRIMARY KEY, pad VARCHAR2(1000));
INSERT INTO churn_pad SELECT level, RPAD('x', 1000, 'x') FROM dual CONNECT BY level <= 5000;
COMMIT;

INSERT INTO fbq_mark
SELECT 'T3_BEFORE_DELETE2', current_scn, TO_CHAR(SYSTIMESTAMP, 'YYYY-MM-DD HH24:MI:SS.FF3')
  FROM v$database;
COMMIT;

DELETE FROM coupon_issue WHERE coupon_type = 'BIRTHDAY' AND status = 'USED';
COMMIT;

-- FBQ_LAB : 500건씩 200번 갱신하며 Undo 덮어쓰기
BEGIN
  FOR i IN 1 .. 200 LOOP
    UPDATE churn_pad SET pad = RPAD(TO_CHAR(i), 1000, 'y') WHERE MOD(id, 10) = MOD(i, 10);
    COMMIT;
  END LOOP;
END;
/

-- 원복 (SYSTEM / XEPDB1)
-- ALTER SYSTEM SET undo_tablespace = UNDOTBS1 SCOPE = MEMORY;
-- DROP TABLESPACE undo_fbq INCLUDING CONTENTS AND DATAFILES;
T3(SCN 11,344,963)는 23:45:03에 기록했습니다. 이어서 BIRTHDAY 쿠폰 중 USED 상태인 행을 지우고 COMMIT했습니다. 그다음 덮어쓰기 블록으로 Undo를 계속 밀어냈습니다.
SCN을 잘못 넣은 첫 조회는 성공했습니다
처음 조회할 때 T3가 아니라 T2의 SCN(11,343,666)을 넣었습니다. 23:47:13의 결과는 T2 시점 건수와 같은 23,701건이었고, 오류는 없었습니다.
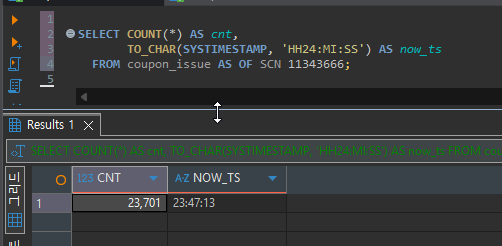
T2 이후에는 BIRTHDAY·USED 삭제가 있었습니다. 그 Undo가 이미 덮였다면 T2 시점 조회도 실패해야 맞습니다. 이 조회가 덮어쓰기 블록보다 먼저 실행됐을 가능성이 있지만, 두 작업의 실행 순서를 시각으로 남기지 않아 확인하지 못했습니다. 시점을 다루는 확인 작업에서는 조회마다 실행 시각을 함께 남겨야 결과를 해석할 수 있습니다.
T3 기준 조회는 ORA-01555로 끝났습니다
T3의 SCN으로 다시 조회하자 ORA-01555가 발생했습니다. 같은 쿼리를 한 번 더 실행해도 결과는 같았습니다. 재실행 직후 시각이 23:54:56이므로, 두 번의 오류 모두 T3 기록 후 9분 53초 안에 일어났습니다. undo_retention 900초보다 짧은 시간입니다.
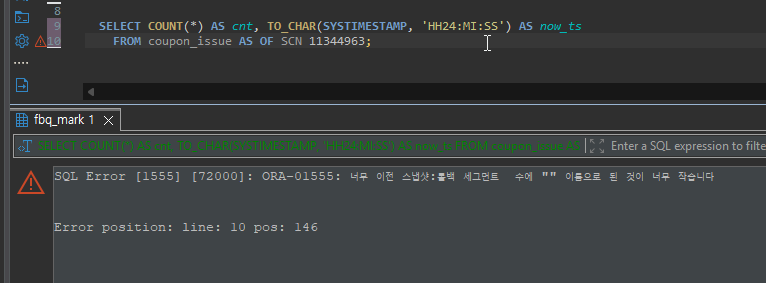
같은 시간대의 V$UNDOSTAT입니다.
| 구간 | UNDOBLKS | UNXPSTEALCNT | UNXPBLKREUCNT | SSOLDERRCNT |
|---|---|---|---|---|
| 23:27:51 ~ 23:37:51 | 24 | 0 | 0 | 0 |
| 23:37:51 ~ 23:47:51 | 16,179 | 7,025 | 13,381 | 0 |
| 23:47:51 ~ 23:55:03 | 25 | 0 | 0 | 2 |
23:37:51부터 10분 동안 Undo 블록 16,179개, 약 126MB가 만들어졌습니다. 5MB 공간의 약 25배입니다. 같은 구간에 retention이 지나지 않은 Undo를 가져다 쓴 횟수(UNXPSTEALCNT)가 7,025회, 재사용된 만료 전 블록(UNXPBLKREUCNT)이 13,381개였습니다. 다음 구간의 SSOLDERRCNT 2는 ORA-01555 두 번과 일치합니다.
덮어쓰기 구간이 진행 중일 때 조회한 TUNED_UNDORETENTION은 16초까지 내려가 있었습니다. 구간이 닫힌 뒤에는 900으로 표시됐는데, 이 차이의 원인은 확인하지 않았습니다.
운영에서 retention 3시간 안에 들어온 요청을 AS OF TIMESTAMP로 복구했을 때는 성공했습니다. 다만 이 결과를 보면, retention 값은 Oracle이 Undo를 남겨 두려는 목표 시간일 뿐입니다. NOGUARANTEE 상태에서 공간이 모자라면 그 안쪽 시점도 사라집니다.
5MB 고정 Undo는 일부러 극단적으로 만든 조건입니다. 670MB 자동 확장 기본 설정이었다면 같은 덮어쓰기에서도 실패하지 않았을 가능성이 높지만, 그 조건은 이번에 측정하지 않았습니다.
삭제 복구 요청을 받았을 때 먼저 할 일
이번 결과를 운영 절차로 옮기면, 삭제 시점이 retention 안인지 확인하는 것은 출발점에 불과합니다. 더 급한 일은 Undo가 덮이기 전에 데이터를 테이블로 옮겨 두는 것입니다.
- 운영 복구에서처럼 삭제 시점을 시각으로 잡았다면
TIMESTAMP_TO_SCN으로 바꾼 SCN 앞뒤를 AS OF로 조회해, 건수가 바뀌는 지점을 직접 확인합니다. - 확인한 SCN으로 지워진 행만
CREATE TABLE ... AS SELECT로 먼저 떠 둡니다. 이 테이블은 이후 Undo가 덮여도 사라지지 않습니다. - 복구 대상은 PK 기준
NOT EXISTS로 고르고, 원래 지우려던 행을 제외할지는 업무 담당자와 정합니다. - 삭제부터 복구까지, 그 행들에 적용되지 못한 업무 변경이 있는지 확인합니다.
- Undo가 버틸 여유는
DBA_TABLESPACES.RETENTION, Undo 데이터파일의 자동 확장 여부, V$UNDOSTAT의 UNXPSTEALCNT와 SSOLDERRCNT로 판단합니다.
이 방법이 통하지 않는 경우도 있습니다. TRUNCATE는 행 단위 Undo를 남기지 않아 Flashback Query로 되돌릴 수 없습니다. 삭제 뒤 테이블 구조를 바꾸는 DDL이 실행되면 ORA-01466으로 막힐 수 있습니다. 두 경우 모두 이번에 직접 검증하지는 않았습니다.
대량 삭제 직후 배치가 몰리는 시간대라면, retention이 남아 있어도 Undo가 먼저 밀려날 수 있습니다. 이번 숫자는 단일 세션, 30,000건, 21c XE에서 나온 결과입니다. 동시 세션과 Undo 사용량이 큰 운영 환경이라면 V$UNDOSTAT 추이부터 확인하는 것이 순서입니다.

댓글 0
첫 댓글을 남겨보세요.