AWR 없이 V$SQL로 Top SQL 찾기: 기준마다 1위가 달랐고 리터럴 SQL은 기록에서 사라졌습니다
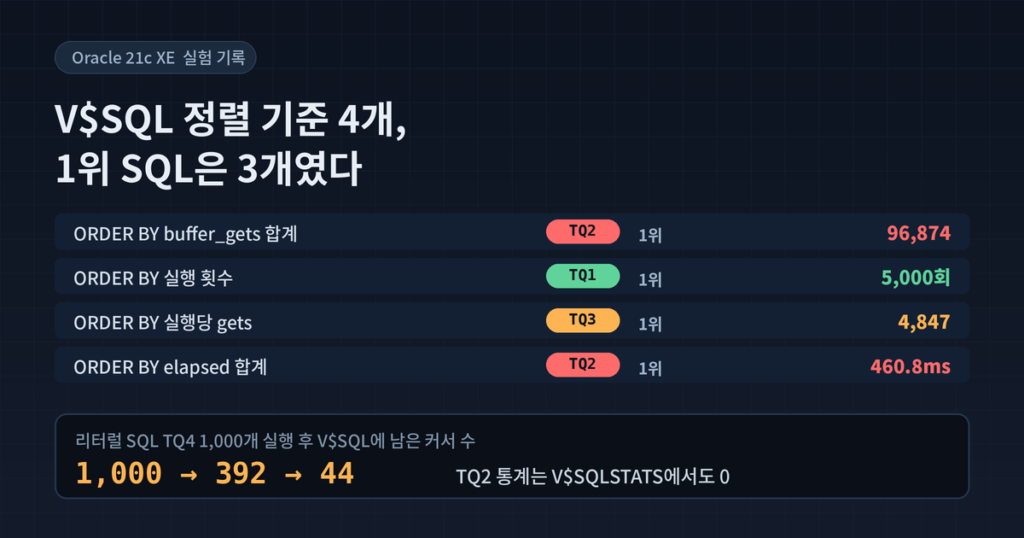
정렬 기준 네 개가 고른 1위 SQL은 세 개였습니다
같은 V$SQL 집계 결과를 정렬 기준만 바꿔 네 번 줄 세웠습니다. buffer_gets 합계로 정렬하면 TQ2, 실행 횟수로 정렬하면 TQ1, 실행당 gets로 정렬하면 TQ3가 맨 위에 섰습니다. elapsed_time 합계로 다시 정렬하자 TQ2가 1위로 돌아왔습니다. 워크로드는 하나였는데 기준마다 Top SQL이 달랐습니다.
더 눈여겨본 것은 순위표 맨 아래에 있던 SQL입니다. 고객번호만 바꿔 1,000번 실행한 리터럴 SQL(TQ4)은 커서마다 실행 1회, gets 34 안팎이라 개별 순위로는 눈에 띄지 않았습니다. 같은 모양끼리 묶자 elapsed 합계가 TQ2보다 컸습니다. 그리고 진단 쿼리를 몇 번 실행하는 사이 V$SQL에 남은 TQ4 커서는 약 1,000개에서 44개로 줄었습니다.
AWR이 없는 Oracle 21c XE에서 V$SQL과 V$SQLSTATS만으로 Top SQL을 고를 때 무엇을 함께 봐야 하고, 그 숫자를 언제까지 믿을 수 있는지 직접 확인했습니다. 데이터는 블로그 테스트용 가상 시나리오인 배송 이력입니다.
실험 구성: 배송 이력 30만 건과 성격이 다른 SQL 네 개
테스트는 PDB(XEPDB1)에 만든 전용 사용자 TOPSQL_LAB으로 진행했고 클라이언트는 DBeaver입니다. V$SQL과 V$SQLSTATS를 테스트 사용자로 조회하기 위해 SYSTEM 계정에서 SELECT ANY DICTIONARY 권한을 한 번 부여했습니다. 리터럴만 다른 SQL이 각각 별도 커서가 되는지가 실험의 전제라서 CURSOR_SHARING 값도 환경 확인에 넣었습니다.
SELECT
    (SELECT banner_full FROM v$version WHERE ROWNUM = 1)                AS db_version,
    SYS_CONTEXT('USERENV', 'CON_NAME')                                   AS con_name,
    SYS_CONTEXT('USERENV', 'SESSION_USER')                               AS session_user,
    SYS_CONTEXT('USERENV', 'CURRENT_SCHEMA')                             AS current_schema,
    (SELECT value FROM v$parameter WHERE name = 'cursor_sharing')        AS cursor_sharing,
    (SELECT value FROM v$parameter WHERE name = 'statistics_level')      AS statistics_level,
    (SELECT ROUND(bytes / 1024 / 1024) FROM v$sgainfo
      WHERE name = 'Shared Pool Size')                                   AS shared_pool_mb
FROM dual;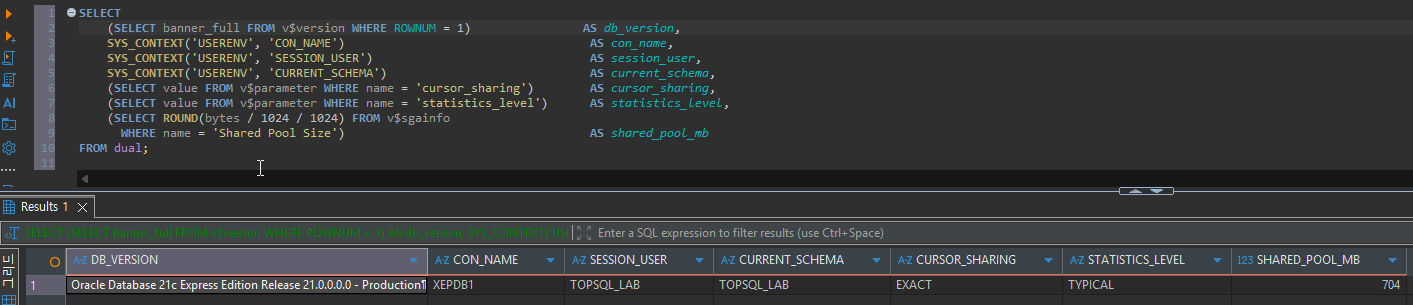
데이터 분포와 워크로드
DELIVERY_HISTORY 테이블에 300,000건을 APPEND로 적재하고 바로 COMMIT한 뒤 통계를 수집했습니다. 전체를 읽는 SQL과 단건 조회 SQL의 실행당 gets 차이가 1,000배 넘게 벌어지면서도 XE에서 부담 없이 돌릴 수 있는 규모라 이 건수를 골랐습니다. customer_id는 1부터 10,000까지 고객마다 30건씩 균등하게, courier_cd는 C01부터 C20까지 20종으로 나눴습니다. status_cd는 DELAY 2%, RETURN 2%, DONE 96%입니다. 인덱스는 기본 키(delivery_id)와 customer_id 인덱스 두 개만 만들었습니다.
| 태그 | SQL 성격 | 설계 의도 | 실행 횟수 |
|---|---|---|---|
| TQ1 | 기본 키 단건 조회 | 아주 싸지만 자주 불리는 SQL | 5,000 |
| TQ2 | 인덱스 없는 courier_cd, status_cd 조건의 COUNT | 한 번에 많이 읽는 SQL | 20 |
| TQ3 | 고객별 fee 합계에 RANK를 매긴 상위 100명 | 읽는 양은 TQ2와 비슷하고 집계와 정렬이 추가된 SQL | 2 |
| TQ4 | 고객번호를 문자열로 붙인 동적 SQL | 바인드 변수 없이 리터럴만 다른 SQL | 1,000 |
SELECT 목록 맨 앞의 'TQ1' 같은 태그 리터럴은 V$SQL에서 실험 SQL만 골라내기 위해 넣었습니다. DBeaver는 SQL 위의 주석 줄을 함께 서버로 보낼 수 있어 SQL_TEXT가 SELECT로 시작하지 않는 경우가 있으므로, 조회할 때는 앞뒤에 %를 붙인 LIKE '%''TQ_''%' 조건을 썼습니다. 워크로드는 아래 익명 블록 하나를 한 번 실행했습니다.
DECLARE
    l_tag    VARCHAR2(10);
    l_status VARCHAR2(10);
    l_cnt    NUMBER;
    l_amt    NUMBER;
BEGIN
    FOR i IN 1 .. 5000 LOOP
        SELECT 'TQ1', status_cd INTO l_tag, l_status
          FROM delivery_history
         WHERE delivery_id = i * 37;
    END LOOP;

    FOR i IN 1 .. 20 LOOP
        SELECT 'TQ2', COUNT(*) INTO l_tag, l_cnt
          FROM delivery_history
         WHERE courier_cd = 'C' || LPAD(MOD(i, 20) + 1, 2, '0')
           AND status_cd = 'DELAY';
    END LOOP;

    FOR i IN 1 .. 2 LOOP
        SELECT 'TQ3', COUNT(*) INTO l_tag, l_cnt
          FROM (SELECT customer_id,
                       RANK() OVER (ORDER BY SUM(fee) DESC) AS rk
                  FROM delivery_history
                 GROUP BY customer_id)
         WHERE rk <= 100;
    END LOOP;

    FOR i IN 1 .. 1000 LOOP
        EXECUTE IMMEDIATE
            'SELECT ''TQ4'', COUNT(*), NVL(SUM(fee), 0) FROM delivery_history WHERE customer_id = ' || i
            INTO l_tag, l_cnt, l_amt;
    END LOOP;
END;
실행 전에 세운 가설
- 정렬 기준(buffer_gets, 실행 횟수, 실행당 gets, elapsed)에 따라 1위 SQL이 달라집니다.
- 실행당 gets가 비슷해도 실행당 시간은 크게 다를 수 있습니다.
- 리터럴 SQL은 커서가 흩어져 개별 순위에서는 아래에 있지만, FORCE_MATCHING_SIGNATURE로 묶으면 위로 올라옵니다.
- 필터 없이 V$SQL을 정렬하면 SQL을 호출한 PL/SQL 블록이 내부 SQL의 수치를 합산한 채 1위로 나옵니다.
같은 집계를 네 가지 기준으로 줄 세웠습니다
워크로드 직후 SELECT 문(command_type = 3)만 SQL_ID별로 모으고, 기준별 순위를 RANK 열 네 개로 한 결과에 나란히 붙였습니다.
WITH s AS (
    SELECT sql_id,
           MAX(SUBSTR(sql_text, 1, 45))  AS sql_head,
           SUM(executions)               AS execs,
           SUM(buffer_gets)              AS gets,
           SUM(elapsed_time)             AS ela_us,
           SUM(rows_processed)           AS rows_p
    FROM v$sql
    WHERE parsing_schema_name = 'TOPSQL_LAB'
      AND command_type = 3
      AND sql_text LIKE '%''TQ_''%'
    GROUP BY sql_id
)
SELECT sql_head,
       execs,
       gets,
       ROUND(gets / NULLIF(execs, 0), 1)          AS gets_per_exec,
       ROUND(ela_us / 1000, 1)                    AS ela_ms,
       ROUND(ela_us / NULLIF(execs, 0) / 1000, 3) AS ms_per_exec,
       RANK() OVER (ORDER BY gets DESC)                     AS r_gets,
       RANK() OVER (ORDER BY execs DESC)                    AS r_execs,
       RANK() OVER (ORDER BY gets / NULLIF(execs, 0) DESC)  AS r_gets_per_exec,
       RANK() OVER (ORDER BY ela_us DESC)                   AS r_ela
FROM s
ORDER BY gets DESC
FETCH FIRST 10 ROWS ONLY;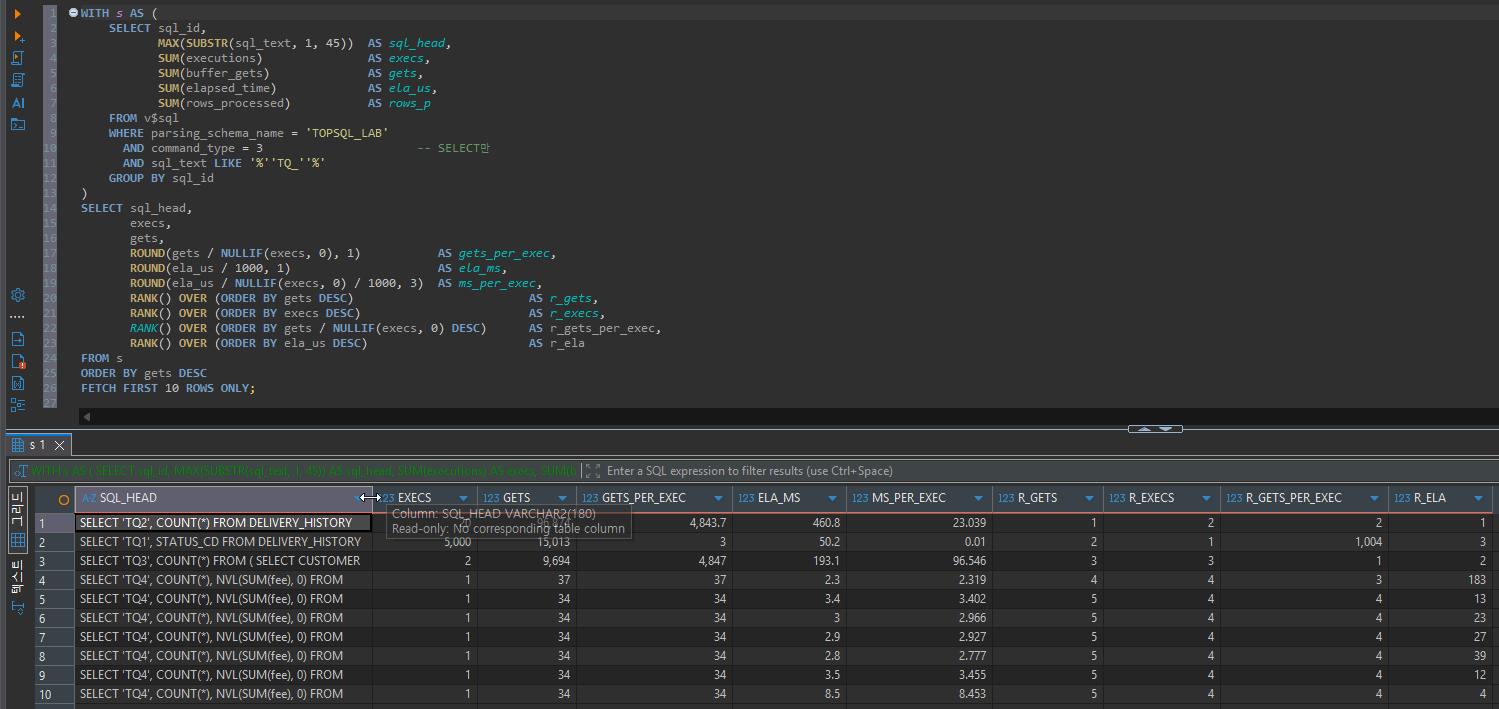
| SQL | 실행 | gets | 실행당 gets | elapsed(ms) | 실행당(ms) | 순위 gets / 실행 / 실행당 gets / elapsed |
|---|---|---|---|---|---|---|
| TQ2 | 20 | 96,874 | 4,843.7 | 460.8 | 23.039 | 1 / 2 / 2 / 1 |
| TQ1 | 5,000 | 15,013 | 3 | 50.2 | 0.01 | 2 / 1 / 1,004 / 3 |
| TQ3 | 2 | 9,694 | 4,847 | 193.1 | 96.546 | 3 / 3 / 1 / 2 |
| TQ4(커서 1개) | 1 | 34~37 | 34~37 | 2.3~8.5 | 2.3~8.5 | 4~5 / 4 / 3~4 / 4~183 |
가설 1은 확인됐습니다. 실행 횟수만 보면 TQ1이 가장 문제처럼 보이지만 실행당 gets는 3으로 네 SQL 중 가장 쌉니다. 실행당 gets만 보면 TQ3가 1위인데, 하루에 두 번 도는 리포트성 SQL이라면 전체 부하에서 차지하는 몫은 크지 않습니다. 어느 한 기준으로 정렬한 결과만 보고 튜닝 대상을 정하면 이 둘 중 하나를 잘못 고르게 됩니다.
실행당 gets는 같았는데 실행당 시간은 4.2배 차이 났습니다
TQ2와 TQ3의 실행당 gets는 4,843.7과 4,847로 사실상 같았습니다. 같은 양의 블록을 읽었다는 뜻입니다. 그런데 실행당 시간은 TQ2가 23.039ms, TQ3가 96.546ms로 약 4.2배 차이가 났습니다. 가설 2도 확인됐습니다.
TQ3는 블록을 읽은 뒤 고객 10,000명의 fee를 합산하고 RANK로 정렬하는 작업이 더 붙습니다. 그래서 늘어난 시간은 집계와 정렬에 쓴 CPU라고 보고 있지만, 이 부분은 추정입니다. 두 SQL의 cpu_time을 확인하려고 다시 조회했을 때는 이미 통계가 남아 있지 않았기 때문입니다. 이 과정은 아래에서 따로 다룹니다.
TQ1의 실행당 gets 순위 1,004위가 알려준 것
TQ1의 실행당 gets 순위 1,004위는 실행당 gets가 TQ1보다 큰 SQL이 1,003개 있었다는 뜻입니다. TQ2, TQ3와 필터에 걸린 진단 쿼리를 감안하면 이 시점에는 TQ4 커서 1,000개가 모두 V$SQL에 있었던 것으로 판단했습니다. 이 숫자가 뒤에서 커서 수 변화를 비교하는 기준점입니다.
필터를 빼면 1위는 SQL이 아니라 PL/SQL 블록이었습니다
이번에는 command_type 조건을 빼고 TQ가 들어간 커서를 elapsed 순으로 정렬했습니다.
SELECT sql_id,
       command_type,
       SUBSTR(REPLACE(sql_text, CHR(10), ' '), 1, 50) AS sql_head,
       executions,
       buffer_gets,
       ROUND(elapsed_time / 1000, 1)                  AS ela_ms
FROM v$sql
WHERE parsing_schema_name = 'TOPSQL_LAB'
  AND sql_text LIKE '%TQ%'
ORDER BY elapsed_time DESC
FETCH FIRST 8 ROWS ONLY;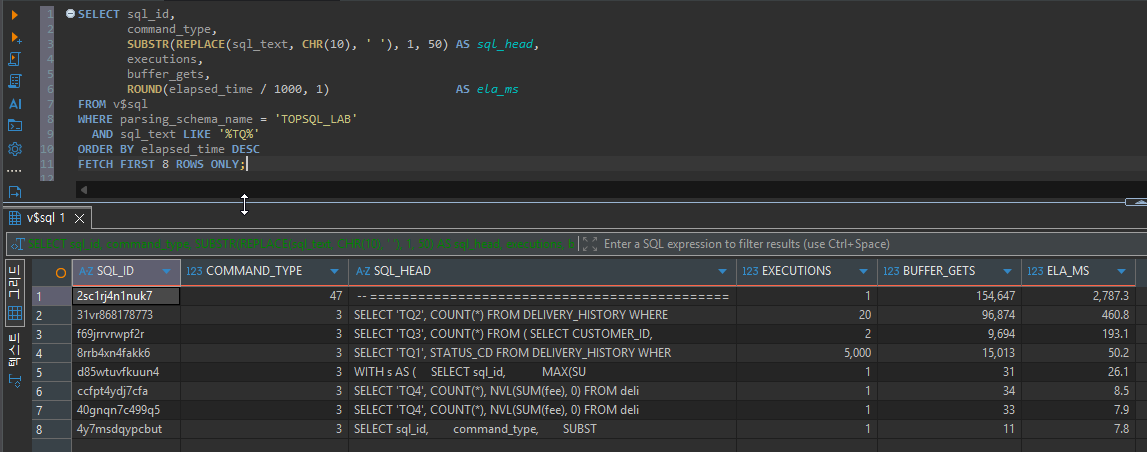
1위는 command_type 47(PL/SQL 블록)인 2sc1rj4n1nuk7이었습니다. 실행 1회에 buffer_gets 154,647, elapsed 2,787.3ms입니다. SQL_HEAD가 -- ====로 시작하는 것도 확인됐습니다. DBeaver가 블록 위의 주석 줄까지 함께 보냈기 때문입니다. SQL_TEXT가 SELECT나 BEGIN으로 시작한다고 가정한 조건이었다면 이 블록은 검색되지 않았을 것입니다.
가설 4는 확인됐습니다. 블록의 gets에서 TQ2, TQ1, TQ3의 gets를 빼면 154,647 − 96,874 − 15,013 − 9,694 = 33,066이 남습니다. TQ4 한 번의 gets가 33 안팎이므로 1,000번 실행분과 거의 맞습니다. elapsed도 같은 방식으로 빼면 약 2,083ms가 남는데, 여기에는 TQ4 실행분 외에 PL/SQL 루프 자체의 시간도 섞여 있다고 보고 있습니다(추정). 호출한 블록과 호출된 SQL이 같은 목록에 있으면 같은 부하가 두 번 계산됩니다. 그래서 순위를 볼 때는 command_type 47을 따로 떼어 봐야 합니다.
리터럴 SQL 1,000개는 묶어야 크기가 보였습니다
TQ4만 따로 모았습니다.
SELECT COUNT(DISTINCT sql_id)                 AS tq4_sql_ids,
       SUM(executions)                        AS total_execs,
       ROUND(AVG(buffer_gets), 1)             AS avg_gets_per_sql,
       MAX(buffer_gets)                       AS max_gets_per_sql,
       SUM(buffer_gets)                       AS total_gets,
       COUNT(DISTINCT force_matching_signature) AS signatures
FROM v$sql
WHERE parsing_schema_name = 'TOPSQL_LAB'
  AND command_type = 3
  AND sql_text LIKE '%''TQ4''%';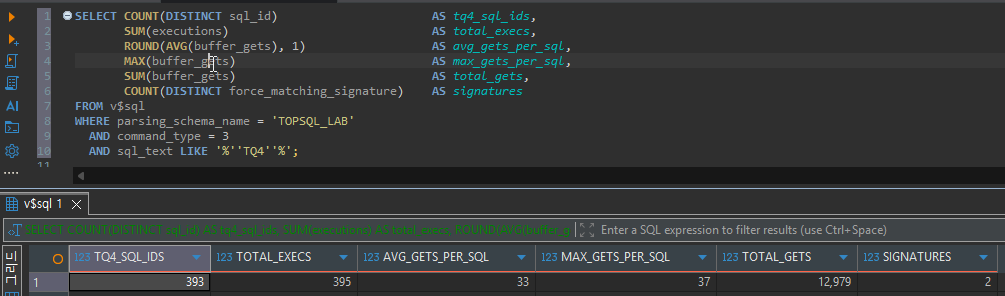
SQL_ID는 1,000개가 아니라 393개, signature는 1개가 아니라 2개였습니다. 일부는 쿼리 자체 때문이었습니다. 조건 문자열 '%''TQ4''%' 안에 'TQ4'가 들어 있어 이 집계 쿼리도 자기 조건에 걸렸습니다. 세 번 실행했으므로 실행 395회는 TQ4 392회와 진단 쿼리 3회, gets 12,979는 TQ4 12,965와 진단 쿼리 14의 합입니다. 1,000개 중 608개가 빠진 이유는 쿼리 문제가 아니었고, 그 흔적은 바로 다음 집계부터 나옵니다.
SELECT force_matching_signature,
       COUNT(DISTINCT sql_id)                       AS sql_cnt,
       SUM(executions)                              AS execs,
       SUM(buffer_gets)                             AS gets,
       ROUND(SUM(elapsed_time) / 1000, 1)           AS ela_ms,
       MAX(SUBSTR(sql_text, 1, 45))                 AS sample_sql,
       RANK() OVER (ORDER BY SUM(buffer_gets) DESC) AS r_gets
FROM v$sql
WHERE parsing_schema_name = 'TOPSQL_LAB'
  AND command_type = 3
  AND sql_text LIKE '%''TQ_''%'
GROUP BY force_matching_signature
ORDER BY gets DESC;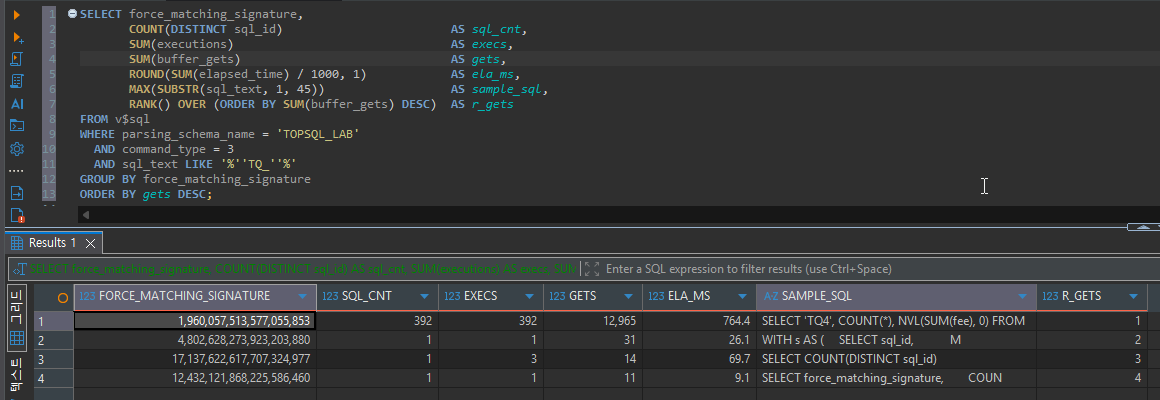
남아 있던 392개만 묶어도 elapsed 합계는 764.4ms였습니다. 개별 커서로는 순위표 맨 아래였던 SQL이 묶으면 elapsed 기준 1위였던 TQ2(460.8ms)보다 컸습니다. gets 합계 12,965는 TQ2의 96,874에 못 미쳤으므로 gets 기준 순위까지 뒤집히지는 않았습니다. 가설 3은 elapsed 기준에서 확인됐고 gets 기준에서는 맞지 않았습니다.
워크로드 실행 전후의 세션 통계도 같은 방향을 가리켰습니다.
SELECT n.name, s.value
FROM v$mystat s
JOIN v$statname n ON n.statistic# = s.statistic#
WHERE n.name IN ('execute count', 'parse count (total)', 'parse count (hard)');| 통계 | 실행 전 | 실행 후 | 증가 |
|---|---|---|---|
| execute count | 1,230 | 7,340 | +6,110 |
| parse count (total) | 569 | 1,608 | +1,039 |
| parse count (hard) | 45 | 1,051 | +1,006 |
하드 파스는 1,006회 늘어 TQ4 1,000회와 거의 같았습니다. 리터럴이 다른 SQL마다 새로 파싱됐다는 뜻입니다. 반대로 실행은 6,110회 늘었는데 전체 파싱은 1,039회만 늘었습니다. TQ1이 5,000번 실행될 때마다 파싱했다면 파싱 증가량이 5,000을 넘었어야 합니다. PL/SQL 안의 정적 SQL은 커서를 재사용했다는 것이 이 숫자로 확인됩니다.
진단 쿼리를 몇 번 돌리는 사이 Top SQL의 기록이 사라졌습니다
FORCE_MATCHING_SIGNATURE 집계에는 이상한 점이 하나 더 있었습니다. 기준별 순위 집계와 같은 필터를 썼는데 TQ1, TQ2, TQ3가 결과에 없었습니다. gets 96,874인 TQ2가 남아 있었다면 첫 줄에 나와야 합니다. TQ2의 SQL_ID로 실행계획을 조회했을 때도 결과가 나오지 않았습니다. Top SQL 목록에서 찾은 SQL의 실행계획을 보러 갔을 때 커서가 이미 없었던 것입니다.
V$SQLSTATS는 커서가 공유 풀에서 밀려난 뒤에도 실행 통계를 V$SQL보다 오래 보관하도록 만든 뷰입니다. 사라진 SQL_ID를 V$SQLSTATS에서 다시 찾았습니다.
SELECT s.sql_id,
       (SELECT COUNT(*) FROM v$sql q WHERE q.sql_id = s.sql_id) AS in_v_sql,
       s.executions,
       s.buffer_gets,
       ROUND(s.cpu_time / 1000, 1)     AS cpu_ms,
       ROUND(s.elapsed_time / 1000, 1) AS ela_ms,
       s.last_active_time
FROM v$sqlstats s
WHERE s.sql_id IN ('2sc1rj4n1nuk7', '31vr868178773', 'f69jrrvrwpf2r', '8rrb4xn4fakk6');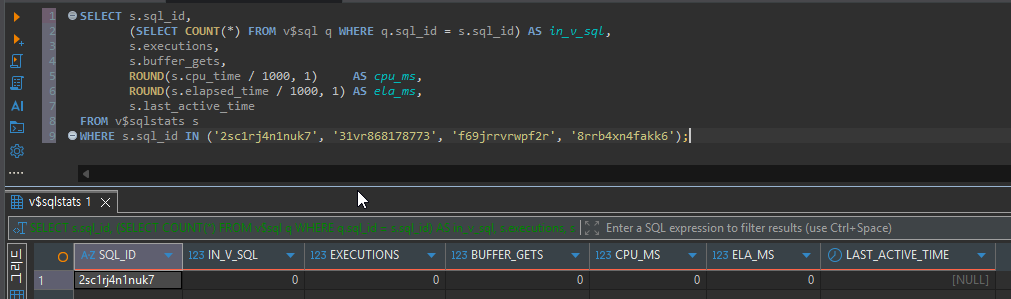
V$SQLSTATS에서도 154,647 gets를 기록했던 블록의 통계는 0이었고, LAST_ACTIVE_TIME은 비어 있었습니다. TQ1~TQ3의 SQL_ID 세 개는 결과에 나오지 않았습니다. 이번에는 SQL_ID 대신 태그로 V$SQLSTATS를 묶고, 운영 환경에서 Top SQL을 고를 때 썼던 방식처럼 전체 cpu_time을 100%로 놓은 비중을 계산했습니다.
SELECT REGEXP_SUBSTR(sql_text, 'TQ[0-9]')                   AS tag,
       COUNT(*)                                             AS sql_cnt,
       SUM(executions)                                      AS execs,
       SUM(buffer_gets)                                     AS gets,
       ROUND(SUM(cpu_time) / 1000, 1)                       AS cpu_ms,
       ROUND(SUM(elapsed_time) / 1000, 1)                   AS ela_ms,
       ROUND(100 * RATIO_TO_REPORT(SUM(cpu_time)) OVER (), 1) AS cpu_pct
FROM v$sqlstats
WHERE sql_text LIKE 'SELECT ''TQ_''%'
GROUP BY REGEXP_SUBSTR(sql_text, 'TQ[0-9]')
ORDER BY cpu_ms DESC;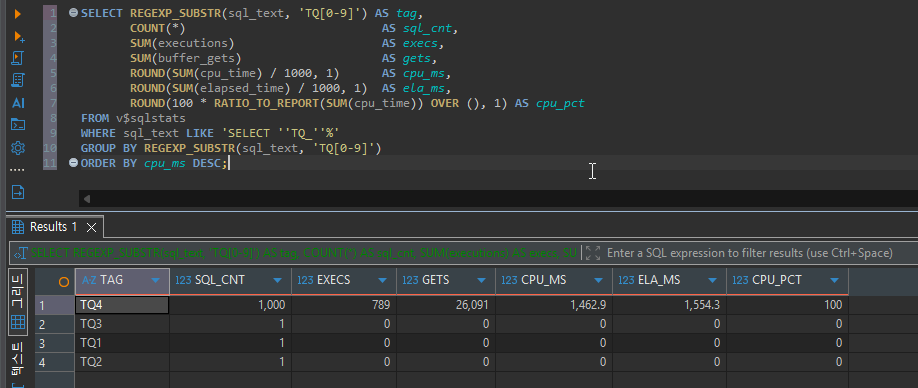
V$SQLSTATS에는 TQ4 항목이 1,000개 모두 있었지만 실행 횟수 합은 789였습니다. 1,000번 실행했으니 211개 항목은 남아 있으면서 통계만 0이 된 상태입니다. TQ1~TQ3도 항목은 하나씩 있었는데 실행 횟수, gets, CPU가 모두 0이었습니다. 마지막으로 V$SQL과 V$SQLSTATS에 남은 TQ4의 고객번호 범위를 비교했습니다.
SELECT 'V$SQL' AS src, COUNT(*) AS cnt,
       MIN(TO_NUMBER(REGEXP_SUBSTR(sql_text, 'customer_id = ([0-9]+)', 1, 1, NULL, 1))) AS min_i,
       MAX(TO_NUMBER(REGEXP_SUBSTR(sql_text, 'customer_id = ([0-9]+)', 1, 1, NULL, 1))) AS max_i,
       MAX(TO_NUMBER(REGEXP_SUBSTR(sql_text, 'customer_id = ([0-9]+)', 1, 1, NULL, 1)))
     - MIN(TO_NUMBER(REGEXP_SUBSTR(sql_text, 'customer_id = ([0-9]+)', 1, 1, NULL, 1))) + 1 AS span
FROM v$sql
WHERE parsing_schema_name = 'TOPSQL_LAB'
  AND sql_text LIKE 'SELECT ''TQ4''%'
UNION ALL
SELECT 'V$SQLSTATS', COUNT(*),
       MIN(TO_NUMBER(REGEXP_SUBSTR(sql_text, 'customer_id = ([0-9]+)', 1, 1, NULL, 1))),
       MAX(TO_NUMBER(REGEXP_SUBSTR(sql_text, 'customer_id = ([0-9]+)', 1, 1, NULL, 1))),
       MAX(TO_NUMBER(REGEXP_SUBSTR(sql_text, 'customer_id = ([0-9]+)', 1, 1, NULL, 1)))
     - MIN(TO_NUMBER(REGEXP_SUBSTR(sql_text, 'customer_id = ([0-9]+)', 1, 1, NULL, 1))) + 1
FROM v$sqlstats
WHERE sql_text LIKE 'SELECT ''TQ4''%';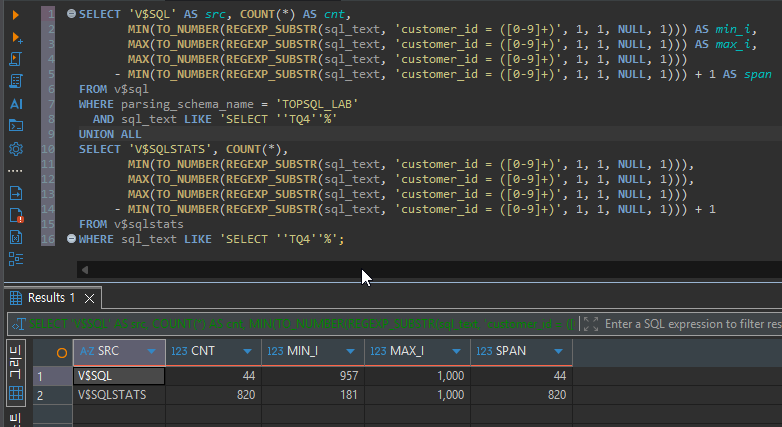
V$SQL의 TQ4 커서는 기준별 순위 집계 시점의 약 1,000개에서 TQ4 집계와 FORCE_MATCHING_SIGNATURE 집계 시점의 392개, 범위 비교 시점의 44개로 줄었습니다. 남은 44개는 고객번호 957부터 1,000까지로, 개수와 범위 폭이 같았습니다. 마지막에 실행된 커서만 빈틈 없이 남았다는 뜻이고, 먼저 실행된 커서부터 공유 풀에서 밀려났다는 것이 이 패턴으로 확인됩니다. TQ1~TQ3는 블록 안에서 TQ4보다 먼저 실행됐으므로 먼저 사라진 것도 같은 순서로 설명됩니다(추정).
V$SQLSTATS의 TQ4 항목은 태그별 집계에서 1,000개, 범위 비교에서 820개였고 남은 범위는 181부터 1,000까지 연속이었습니다. TQ4를 다시 실행하지 않았으므로 항목이 늘어날 수는 없고, 1,000개가 조회된 태그별 집계가 먼저였다는 것도 이 숫자로 알 수 있습니다. V$SQL보다 오래 보관한 것은 맞지만 이 뷰의 기록도 오래된 것부터 지워졌습니다. 태그별 집계에서 통계가 0이었던 211개와 범위 비교 시점에 사라진 180개를 보면 통계가 먼저 0이 되고 그다음 항목이 지워지는 순서로 보입니다. 다만 0이 된 항목이 어느 번호인지까지는 조회하지 않아 이 순서는 추정으로 남깁니다.
남은 숫자로 계산한 CPU 비중은 실제 부하 순위와 반대였습니다
태그별 집계의 cpu_pct는 TQ4 100%, TQ2 0%였습니다. 기준별 순위에서 gets와 elapsed 1위였던 SQL이 CPU 비중 계산에서는 0%로 나온 것입니다. RATIO_TO_REPORT는 그 순간 뷰에 남아 있는 행끼리 나눈 비율이므로, 이미 통계가 사라진 SQL은 분모에서도 빠집니다. 같은 SQL로 계산해도 언제 조회했는지가 순위를 바꿉니다.
태그별 집계는 TQ4의 성격도 보여줬습니다. 789회 실행에 elapsed 1,554.3ms, CPU 1,462.9ms로 실행당 약 1.97ms였고 elapsed의 약 94%가 CPU였습니다. TQ1(실행당 0.01ms, gets 3)과 비교하면 실행당 gets는 약 11배인데 시간은 약 200배입니다. CPU_TIME과 ELAPSED_TIME에는 커서의 파싱 시간도 포함되므로, gets로 설명되지 않는 나머지는 매번 일어난 하드 파스의 CPU라고 보고 있습니다. 파싱 시간을 따로 재지 않았으므로 추정입니다.
AWR 없이 Top SQL을 고를 때 함께 봐야 하는 기준
운영 환경에서 V$SQL을 기준으로 Top SQL을 찾아 개선한 적이 있습니다. 전체 cpu_time을 100%로 놓고 비중이 큰 상위 50개 SQL을 추출했고, 각 SQL의 실행 횟수를 calls/sec와 calls/day로 환산해 초당 얼마나 유입되는 쿼리인지 판단했습니다. 호출량이 많은 SQL은 buffer_gets와 elapsed_time을 함께 확인해 튜닝 포인트로 잡고 개선했습니다.
이번 실험 결과를 그 방식에 겹쳐 보면 기준 하나를 더 고르는 것보다 조회 방식과 시점을 정하는 쪽이 중요했습니다. 21c XE에서 확인한 내용을 기준으로 정리하면 다음과 같습니다.
- 정렬 기준 하나로 결론 내지 않습니다. gets, 실행 횟수, 실행당 gets, elapsed 순위를 앞의 기준별 순위 집계처럼 한 결과에 나란히 두면 자주 불리지만 싼 TQ1과 드물지만 비싼 TQ3가 구분됩니다.
- command_type 47(PL/SQL)은 따로 봅니다. 호출한 블록은 내부 SQL의 수치를 합산하므로 같은 부하가 두 번 계산됩니다.
- FORCE_MATCHING_SIGNATURE로 묶은 순위를 함께 봅니다. 리터럴 SQL은 묶어야 크기가 보이고, 하드 파스 증가량으로 교차 확인할 수 있습니다.
- Top SQL 후보를 찾으면 그 자리에서 실행계획과 수치를 남깁니다. 이번 실험에서는 TQ2의 실행계획을 조회했을 때 이미 커서가 없었습니다.
- calls/sec처럼 시간 구간이 필요한 값은 누적값 한 번으로 계산할 수 없습니다. AWR이 없으면 V$SQLSTATS를 일정 간격으로 별도 테이블에 저장해 두 시점의 차이로 봐야 합니다. 이 저장 방식은 이번 실험에서 실행하지 않았고 후속 실험으로 확인할 부분입니다.
이 결과가 그대로 옮겨지지 않는 조건
- CURSOR_SHARING이 FORCE인 환경에서는 TQ4 같은 리터럴이 바인드로 바뀌어 처음부터 커서 하나로 쌓일 수 있습니다.
- 공유 풀 크기와 리터럴 SQL 유입량에 따라 커서가 밀려나는 속도는 크게 달라질 수 있습니다. 이번 결과의 속도를 운영 DB에 그대로 적용할 수는 없습니다.
- RAC에서는 인스턴스마다 공유 풀이 따로 있어 GV$ 뷰로 봐야 하며, 이 부분은 21c XE에서 직접 검증하기 어렵습니다.
- V$SQL 값은 커서 적재 시점부터의 누적이라 오래 살아 있는 커서는 최근 부하보다 크게 보일 수 있습니다.
테스트의 한계
- CPU와 메모리가 제한된 XE에서 단일 세션으로 워크로드를 한 번 실행했습니다. 시간 값은 3회 중앙값이 아닌 1회 측정값이고 첫 실행의 하드 파스와 캐시 적재가 포함되어 있습니다.
- 진단 쿼리마다 실행 시각을 기록하지 않아 커서가 몇 분 만에 사라졌는지는 말할 수 없습니다. SQL_ID 조회에서는 TQ1~TQ3가 나오지 않았는데 태그별 집계에는 항목이 있었던 차이도, 조회 순서를 기록하지 않아 설명하지 못했습니다.
- 공유 풀 704MB인 환경에서 커서가 밀려난 직접 원인(남은 메모리 변화, 다른 컨테이너의 사용량)은 확인하지 않았습니다.
- TQ2와 TQ3의 cpu_time은 통계가 0이 되기 전에 확보하지 못해, 두 SQL의 시간 차이 원인은 추정으로 남았습니다.
실습 환경 원복
TOPSQL_LAB으로 접속한 DBeaver 연결을 모두 끊은 뒤 SYSTEM 계정에서 실행합니다.
DROP USER topsql_lab CASCADE;Top SQL 순위는 정렬 기준을 고른 순간이 아니라 V$SQL을 조회한 순간에 정해졌습니다
정렬 기준이 고른 1위가 달랐던 문제와 리터럴 SQL이 숨어 있던 문제는 기준을 여러 개 나란히 보면 해결됩니다. 해결되지 않은 것은 시점이었습니다. 진단 쿼리를 몇 번 실행하는 사이 V$SQL의 TQ4 커서는 약 1,000개에서 44개로 줄었고, gets 1위였던 TQ2는 V$SQLSTATS에서도 통계가 0이 되어 CPU 비중 0%로 계산됐습니다. AWR이 없는 환경에서 V$SQL을 한 번 조회한 결과는 Top SQL 목록이 아니라 그 순간 공유 풀에 남아 있던 SQL의 순위입니다. 기준을 정했다면 수치와 실행계획은 찾은 즉시 남겨야 합니다.

댓글 0
첫 댓글을 남겨보세요.