같은 조건의 SQL이 ORA-01722를 낼 때와 안 낼 때: 실행계획이 바꾼 TO_NUMBER 평가 범위
숫자형 옵션만 골라 TO_NUMBER를 적용했다고 생각한 SQL
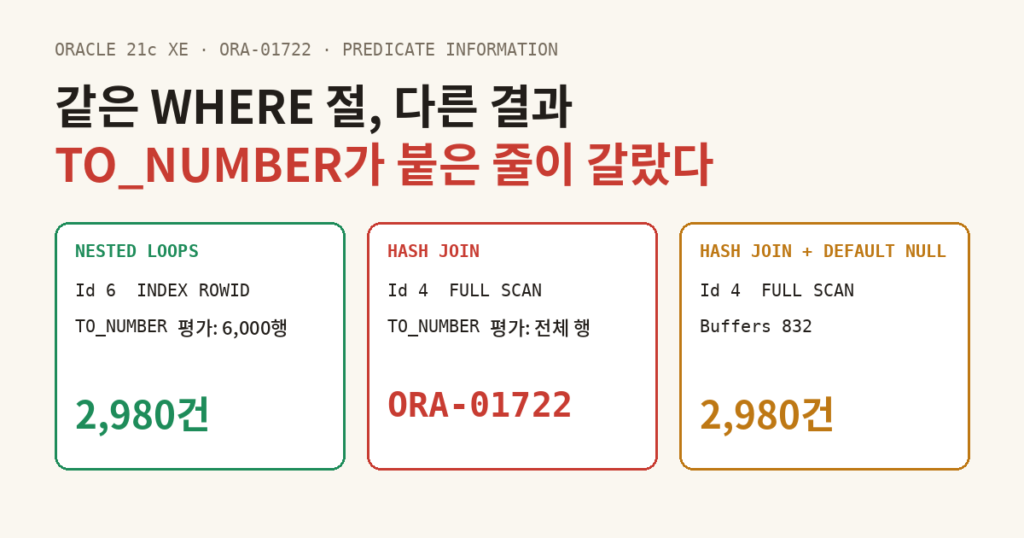
아래 SQL은 숫자형 옵션만 골라 값이 5000보다 큰 행을 셉니다. 21c XE에서 이 WHERE 절을 Nested Loops로 실행하면 2,980건이 나왔고, Hash Join으로 실행하면 ORA-01722: 수치가 부적합합니다로 끝났습니다. 힌트를 모두 뺀 SQL은 오류가 나는 쪽이었습니다.
SELECT COUNT(*) AS matched_cnt
FROM option_def d
JOIN partner_option o ON o.opt_code = d.opt_code
WHERE d.value_type = 'NUM'
  AND TO_NUMBER(o.opt_value) > 5000;
작성자가 기대한 순서는 분명합니다. value_type = 'NUM'으로 숫자형 코드만 남긴 뒤 그 행의 값에만 TO_NUMBER를 적용하는 것입니다. Oracle은 이 평가 순서를 보장하지 않습니다. 실제로 어떤 행에 TO_NUMBER가 적용되었는지를 실행계획의 Predicate Information과 A-Rows로 추적했습니다.
숫자와 문자가 한 컬럼에 섞인 제휴사 옵션 테이블
데이터는 제휴사 옵션 관리를 가정한 가상 데이터입니다. 제휴사별 설정을 키-값 형태로 저장하는 PARTNER_OPTION과, 옵션 코드마다 값의 유형을 정의한 OPTION_DEF를 만들었습니다. OPT_VALUE는 VARCHAR2 컬럼 하나에 숫자와 문자가 함께 들어갑니다.
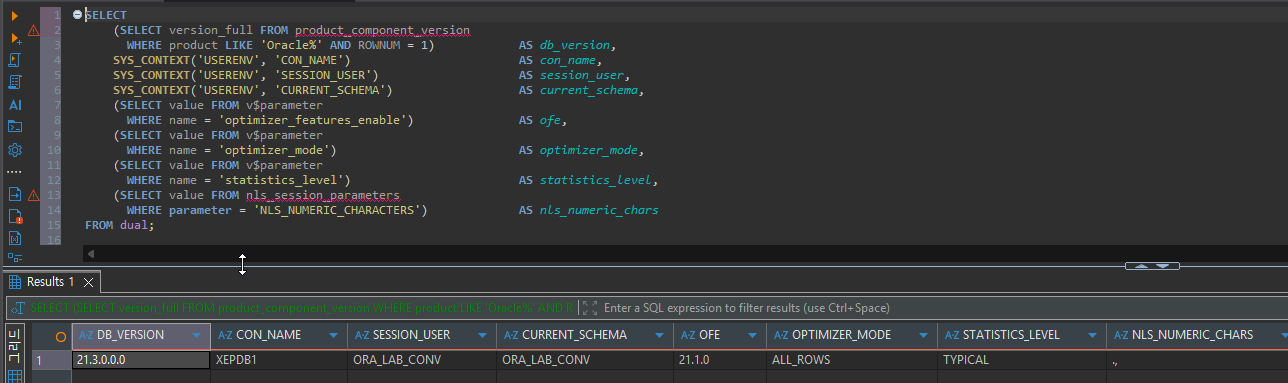
확인은 21c XE(21.3.0.0.0)의 XEPDB1에서 전용 USER ORA_LAB_CONV로 접속해, DBeaver 단일 세션으로 했습니다. optimizer_features_enable은 21.1.0, optimizer_mode는 ALL_ROWS, statistics_level은 TYPICAL이었고, 숫자 변환에 영향을 주는 NLS_NUMERIC_CHARACTERS는 .,였습니다.
OPTION_DEF에는 코드 15개를 넣었습니다. 숫자형(NUM)은 DAILY_LIMIT, RETRY_COUNT, FEE_BP 3개이고 나머지 12개는 문자형(CHAR)입니다. PARTNER_OPTION은 200,000건이며, 숫자형 코드 행은 3%만 두었습니다. 이 건수에서 인덱스 접근과 풀스캔의 Buffers 차이가 분명하게 갈립니다.
CREATE TABLE option_def (
    opt_code   VARCHAR2(30) PRIMARY KEY,
    value_type VARCHAR2(4)  NOT NULL
               CHECK (value_type IN ('NUM', 'CHAR'))
);

CREATE TABLE partner_option (
    option_id  NUMBER        PRIMARY KEY,
    partner_id NUMBER        NOT NULL,
    opt_code   VARCHAR2(30)  NOT NULL,
    opt_value  VARCHAR2(100) NOT NULL
);

-- 숫자형 코드 3%: 값은 0~9999 숫자 문자열 / 문자형 코드 97%: 값은 V000~V999
INSERT /*+ APPEND */ INTO partner_option (option_id, partner_id, opt_code, opt_value)
SELECT
    LEVEL,
    MOD(LEVEL, 5000) + 1,
    CASE
        WHEN MOD(LEVEL, 100) < 3 THEN
            CASE MOD(LEVEL, 3)
                WHEN 0 THEN 'DAILY_LIMIT'
                WHEN 1 THEN 'RETRY_COUNT'
                ELSE        'FEE_BP'
            END
        ELSE
            CASE MOD(LEVEL, 12)
                WHEN 0  THEN 'BANK_CODE'    WHEN 1  THEN 'SETTLE_CYCLE'
                WHEN 2  THEN 'NOTI_EMAIL'   WHEN 3  THEN 'API_VERSION'
                WHEN 4  THEN 'CALLBACK_URL' WHEN 5  THEN 'CURRENCY'
                WHEN 6  THEN 'TIMEZONE'     WHEN 7  THEN 'CONTACT_NAME'
                WHEN 8  THEN 'REGION_CODE'  WHEN 9  THEN 'STATUS_FLAG'
                WHEN 10 THEN 'LANG_CODE'    ELSE         'MEMO'
            END
    END,
    CASE
        WHEN MOD(LEVEL, 100) < 3 THEN TO_CHAR(MOD(LEVEL * 7, 10000))
        ELSE 'V' || TO_CHAR(MOD(LEVEL, 1000), 'FM000')
    END
FROM dual
CONNECT BY LEVEL <= 200000;

COMMIT;

CREATE INDEX idx_popt_code ON partner_option (opt_code);
적재 후 두 테이블의 통계를 수집했습니다. PARTNER_OPTION은 200,000행, 844블록입니다. IDX_POPT_CODE는 BLEVEL 2, 리프 블록 606개, 고유 키 15개이고, 클러스터링 팩터는 12,321입니다. 같은 코드의 행이 여러 블록에 흩어져 있다는 뜻으로, 뒤에서 Nested Loops의 Buffers를 해석할 때 다시 씁니다.
문자 값이 어느 코드에 있는지는 VALIDATE_CONVERSION으로 확인했습니다. 이 함수는 숫자로 바꿀 수 없는 값을 오류 없이 0으로 돌려주므로, 오류를 내지 않고 문제 행을 셀 수 있습니다.
SELECT d.value_type,
       COUNT(*)                   AS row_cnt,
       COUNT(DISTINCT o.opt_code) AS code_cnt,
       SUM(CASE WHEN VALIDATE_CONVERSION(o.opt_value AS NUMBER) = 0
                THEN 1 ELSE 0 END) AS not_number_cnt
FROM partner_option o
JOIN option_def d ON d.opt_code = o.opt_code
GROUP BY d.value_type
ORDER BY d.value_type;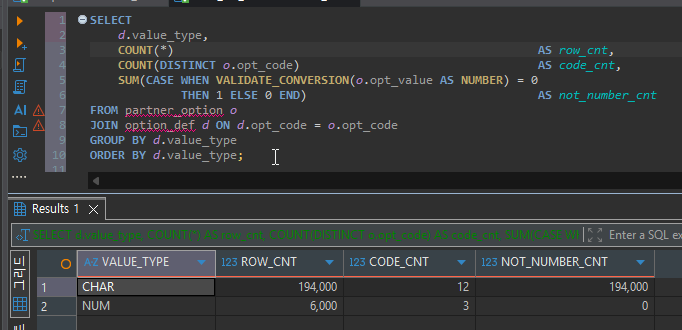
SQL은 아래 표의 TC 번호로 나눠 실행했습니다. 실행계획은 SELECT 목록에 넣은 'TC01' 같은 태그 리터럴로 V$SQL에서 커서를 찾아 조회했습니다. DBeaver는 SQL 위의 주석 줄까지 서버로 보내기 때문에, SQL_TEXT가 SELECT로 시작한다고 가정하지 않고 앞뒤에 %를 붙여 찾았습니다.
SELECT p.plan_table_output
FROM (
    SELECT sql_id, child_number
    FROM v$sql
    WHERE sql_text LIKE '%''TC01''%'
      AND sql_text NOT LIKE '%DISPLAY_CURSOR%'
    ORDER BY last_active_time DESC
    FETCH FIRST 1 ROW ONLY
) s,
TABLE(DBMS_XPLAN.DISPLAY_CURSOR(s.sql_id, s.child_number, 'ALLSTATS LAST')) p;
이 조회를 위해 SYSTEM 계정에서 테스트 USER에게 V_$SQL, V_$SQL_PLAN, V_$SQL_PLAN_STATISTICS_ALL, V_$SESSION의 SELECT 권한을 직접 부여했습니다.
| TC | 바꾼 조건 |
|---|---|
| TC01 | LEADING(d o) USE_NL(o) INDEX(o idx_popt_code) |
| TC02 | LEADING(d o) USE_HASH(o) FULL(o) |
| TC03 | 힌트 없음, 인덱스 VISIBLE과 INVISIBLE |
| TC05 | TC02 힌트 그대로, TO_NUMBER(o.opt_value DEFAULT NULL ON CONVERSION ERROR) |
| TC06 | 조인 없이 PARTNER_OPTION 단독 풀스캔 |
Nested Loops에서는 TO_NUMBER가 6,000행에만 적용되었습니다
TC01은 공통 SQL에 아래 힌트만 붙였습니다. OPTION_DEF에서 숫자형 코드를 먼저 찾고, 코드마다 인덱스로 PARTNER_OPTION을 조회하는 계획입니다.
/*+ GATHER_PLAN_STATISTICS LEADING(d o) USE_NL(o) INDEX(o idx_popt_code) */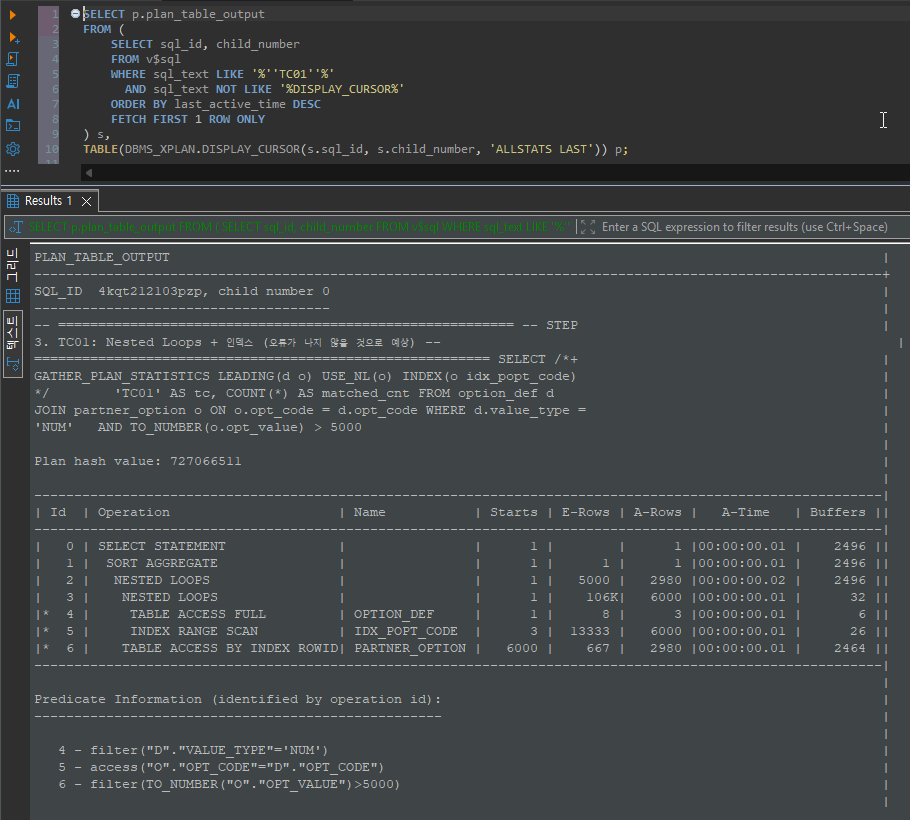
| Id | Operation | Starts | E-Rows | A-Rows | Buffers | Predicate |
|---|---|---|---|---|---|---|
| 4 | TABLE ACCESS FULL OPTION_DEF | 1 | 8 | 3 | 6 | filter("D"."VALUE_TYPE"='NUM') |
| 5 | INDEX RANGE SCAN IDX_POPT_CODE | 3 | 13,333 | 6,000 | 26 | access("O"."OPT_CODE"="D"."OPT_CODE") |
| 6 | TABLE ACCESS BY INDEX ROWID PARTNER_OPTION | 6,000 | 667 | 2,980 | 2,464 | filter(TO_NUMBER("O"."OPT_VALUE")>5000) |
확인된 흐름은 이렇습니다. OPTION_DEF에서 숫자형 코드 3개가 남았고, 인덱스 범위 스캔이 코드마다 한 번씩 3번 실행되어 6,000개의 ROWID를 찾았습니다. TO_NUMBER 필터는 그 행을 테이블에서 읽는 Id 6에 붙어 있어 6,000행에만 적용되었고, 2,980행이 Aggregate로 넘어갔습니다. 문자 값을 가진 194,000행은 읽히지 않았으므로 오류가 날 기회가 없었습니다.
대신 비용이 컸습니다. 전체 Buffers 2,496 중 2,464가 Id 6에서 나왔습니다. 클러스터링 팩터 12,321이 보여 주듯 같은 코드의 행이 흩어져 있어, ROWID 6,000번 접근이 대부분 서로 다른 블록을 읽은 것으로 보입니다.
Hash Join에서는 같은 필터가 풀스캔 줄에 붙었습니다
TC02는 힌트만 바꿨습니다. WHERE 절은 TC01과 글자 하나 다르지 않습니다.
/*+ GATHER_PLAN_STATISTICS LEADING(d o) USE_HASH(o) FULL(o) */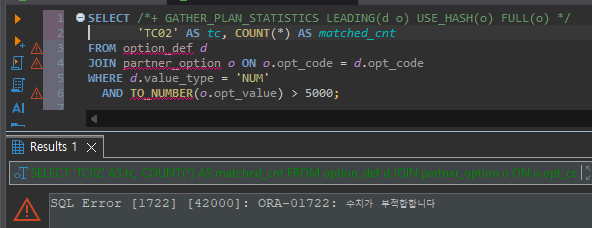
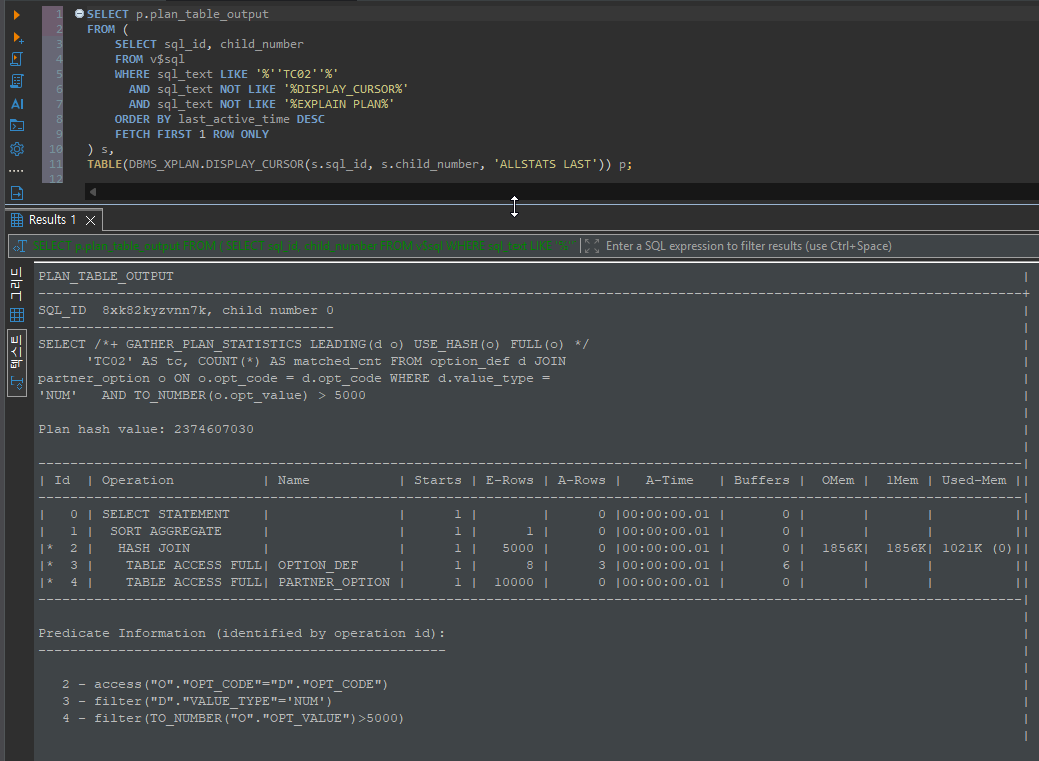
Predicate Information의 문구는 TC01과 똑같이 filter(TO_NUMBER("O"."OPT_VALUE")>5000)입니다. 달라진 것은 붙은 위치입니다. TC02에서는 이 필터가 Id 4, 즉 PARTNER_OPTION 풀스캔에 붙었습니다. value_type = 'NUM' 조건은 OPTION_DEF를 읽는 Id 3에 있고, 두 테이블이 만나는 것은 Id 2의 HASH JOIN입니다. 조인으로 숫자형 코드만 남기기 전에 PARTNER_OPTION의 모든 행이 TO_NUMBER를 통과해야 하는 구조이므로, 문자 값 194,000행이 평가 대상에 들어갔습니다.
| 비교 | TC01 Nested Loops | TC02 Hash Join |
|---|---|---|
| TO_NUMBER가 붙은 줄 | Id 6 TABLE ACCESS BY INDEX ROWID | Id 4 TABLE ACCESS FULL |
| 평가 대상 | 인덱스로 찾은 숫자형 코드 6,000행 | PARTNER_OPTION 전체 행 |
| 결과 | 2,980건 | ORA-01722 |
오류로 끝난 실행의 ALLSTATS LAST에는 PARTNER_OPTION의 A-Rows와 Buffers가 모두 0으로 남았습니다. 오류가 나려면 최소한 문자 값 하나는 읽었어야 하므로, 실패한 실행의 행 소스 통계는 진행 정도를 보여 주지 않는다고 판단했습니다. 몇 번째 행에서 멈췄는지는 이번 방법으로 확인할 수 없었습니다. Hash Join 계획에 JOIN FILTER는 나타나지 않았습니다.
힌트를 빼자 옵티마이저는 처음부터 Hash Join을 골랐습니다
힌트 없는 TC03은 인덱스가 VISIBLE인 상태에서도 ORA-01722로 끝났습니다. 실행 직후 DISPLAY_CURSOR로 커서를 조회했지만 결과가 비어 있었고, 원인은 확인하지 못했습니다. 그래서 SQL을 실제로 실행하지 않고 계획만 보여 주는 EXPLAIN PLAN으로 옵티마이저의 선택을 확인했습니다.
EXPLAIN PLAN SET STATEMENT_ID = 'TC03_VIS' FOR
SELECT 'TC03' AS tc, COUNT(*) AS matched_cnt
FROM option_def d
JOIN partner_option o ON o.opt_code = d.opt_code
WHERE d.value_type = 'NUM'
  AND TO_NUMBER(o.opt_value) > 5000;

SELECT * FROM TABLE(DBMS_XPLAN.DISPLAY(NULL, 'TC03_VIS', 'TYPICAL'));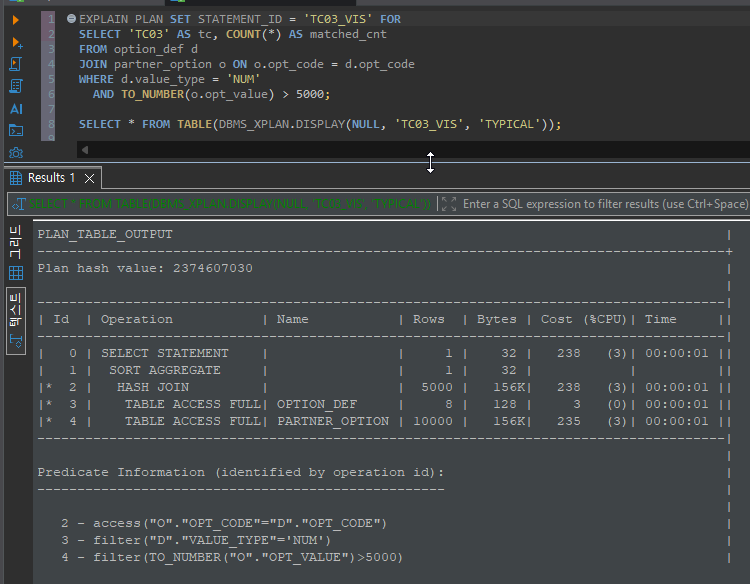
같은 방법으로 TC01의 Nested Loops 계획을 EXPLAIN PLAN으로 확인하면 Cost는 6,914로, Hash Join의 약 29배였습니다. 옵티마이저가 Nested Loops를 버린 이유는 추정 행 수에 있었습니다.
| 추정 지점 | E-Rows | 실제 | 계산 근거 |
|---|---|---|---|
| 숫자형 코드 수 | 8 | 3 | OPTION_DEF 15행을 value_type 값 2개로 나눈 값 |
| 코드당 PARTNER_OPTION 행 | 13,333 | 2,000 | 200,000행을 고유 코드 15개로 나눈 값 |
| Nested Loops 안쪽 전체 | 106K | 6,000 | 8 × 13,333 |
| 풀스캔 후 TO_NUMBER 필터 | 10,000 | 2,980 (TC05) | 200,000의 5% |
옵티마이저는 숫자형 코드가 테이블의 절반 이상을 차지한다고 계산했습니다. 그렇다면 106K행을 ROWID로 하나씩 읽는 것보다 테이블을 한 번 훑는 쪽이 싸다고 본 것은 자연스러운 판단입니다. TO_NUMBER 필터의 추정치는 TC01 Id 6의 667(13,333의 5%), 풀스캔의 10,000(200,000의 5%)에서 모두 5%로 맞아떨어집니다. 함수가 씌워진 범위 조건에 기본 선택도 5%가 적용된 것으로 추정합니다.
이어서 인덱스를 INVISIBLE로 바꾼 뒤 같은 SQL을 다시 실행하고 커서를 조회했습니다.
ALTER INDEX idx_popt_code INVISIBLE;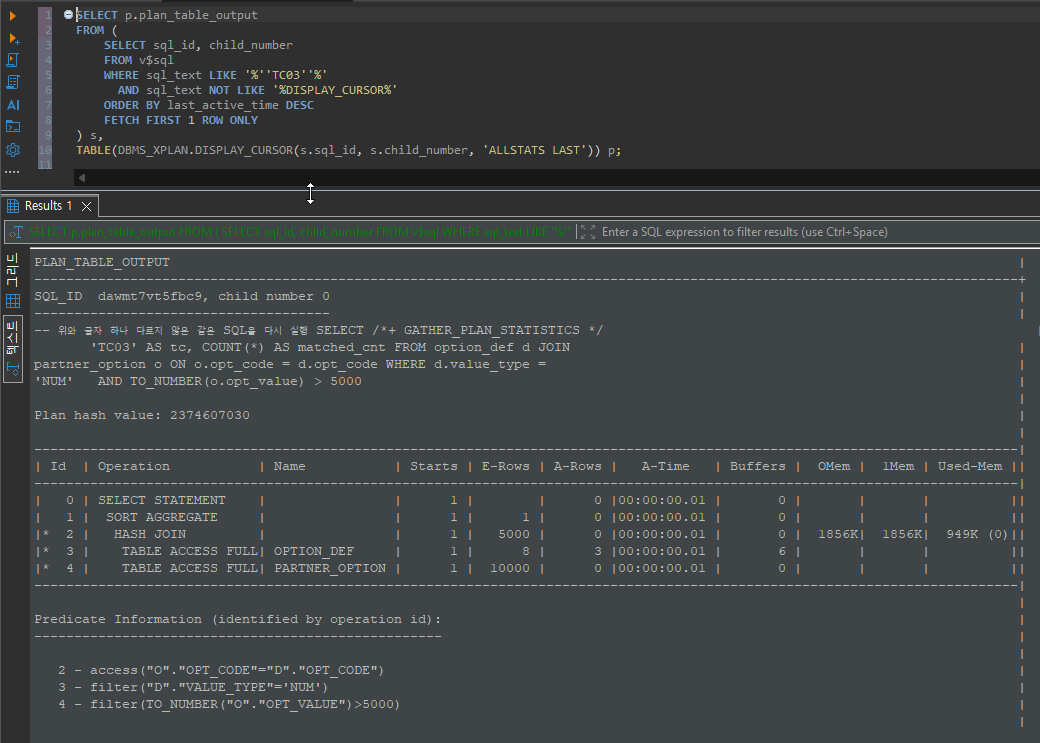
INVISIBLE 상태의 계획도 Plan hash 2374607030으로 TC02, VISIBLE 상태의 EXPLAIN PLAN과 같았습니다. 옵티마이저가 처음부터 인덱스를 쓰지 않았으므로 인덱스 가시성은 결과에 영향을 주지 않았습니다. 확인 후에는 ALTER INDEX idx_popt_code VISIBLE로 원복했습니다. 참고로 두 번의 TC03 실행은 SQL 본문이 같았지만, DBeaver가 서로 다른 주석 줄을 함께 보내 SQL_ID가 다르게 잡혔습니다.
단일 테이블에서도 적은 순서대로 평가되지 않았습니다
조인이 없으면 적은 순서대로 평가될지 확인하려고 TC06을 실행했습니다. 숫자형 코드 조건을 앞에, TO_NUMBER 조건을 뒤에 적었습니다.
SELECT /*+ GATHER_PLAN_STATISTICS FULL(o) */
       'TC06' AS tc, COUNT(*) AS matched_cnt
FROM partner_option o
WHERE o.opt_code IN ('DAILY_LIMIT', 'RETRY_COUNT', 'FEE_BP')
  AND TO_NUMBER(o.opt_value) > 5000;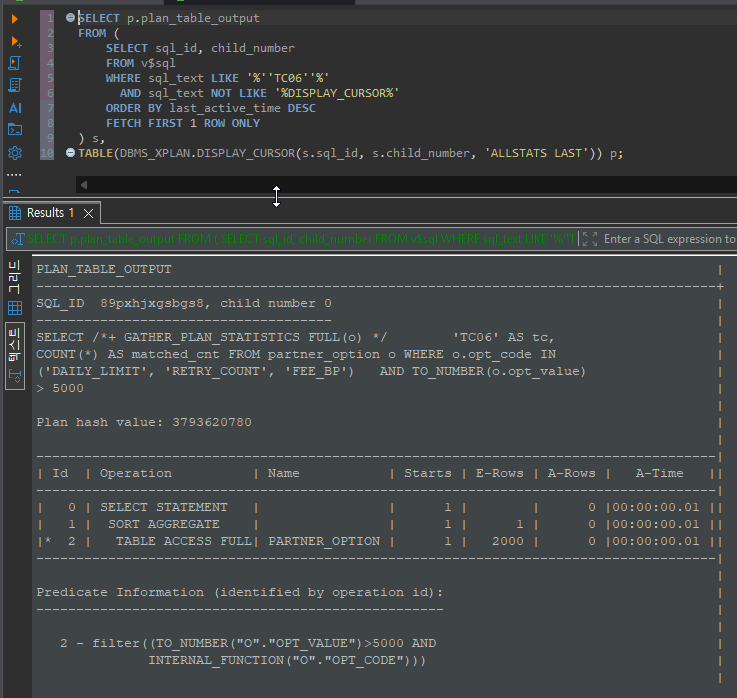
2 - filter((TO_NUMBER("O"."OPT_VALUE")>5000 AND
           INTERNAL_FUNCTION("O"."OPT_CODE")))
결과는 ORA-01722였습니다. 하나의 filter 안에서 TO_NUMBER 조건이 앞에, IN 목록 조건(INTERNAL_FUNCTION)이 뒤에 표시되었습니다. 오류가 났다는 사실과 표시 순서는 확인된 결과입니다. 이 표시 순서가 실제 평가 순서라는 점은 오류 결과와 맞아떨어지는 해석입니다. E-Rows 2,000도 200,000행 중 코드 3개의 몫(40,000행)에 5%를 곱한 값과 같았습니다.
계획은 그대로 두고 TO_NUMBER만 바꿨습니다
TC05는 오류가 난 TC02의 힌트를 그대로 두고, 변환에 실패하면 NULL을 돌려주도록 표현식 하나만 바꿨습니다.
SELECT /*+ GATHER_PLAN_STATISTICS LEADING(d o) USE_HASH(o) FULL(o) */
       'TC05' AS tc, COUNT(*) AS matched_cnt
FROM option_def d
JOIN partner_option o ON o.opt_code = d.opt_code
WHERE d.value_type = 'NUM'
  AND TO_NUMBER(o.opt_value DEFAULT NULL ON CONVERSION ERROR) > 5000;
DISPLAY_CURSOR로 확인한 TC05의 실행계획은 다음과 같습니다. 메모리 사용량 열은 생략했습니다.
Plan hash value: 2374607030

| Id | Operation           | Name           | Starts | E-Rows | A-Rows | Buffers |
|  0 | SELECT STATEMENT    |                |      1 |        |      1 |     832 |
|  1 |  SORT AGGREGATE     |                |      1 |      1 |      1 |     832 |
|* 2 |   HASH JOIN         |                |      1 |   5000 |   2980 |     832 |
|* 3 |    TABLE ACCESS FULL| OPTION_DEF     |      1 |      8 |      3 |       6 |
|* 4 |    TABLE ACCESS FULL| PARTNER_OPTION |      1 |  10000 |   2980 |     826 |

Predicate Information (identified by operation id):
   2 - access("O"."OPT_CODE"="D"."OPT_CODE")
   3 - filter("D"."VALUE_TYPE"='NUM')
4 - filter(TO_NUMBER("O"."OPT_VALUE" DEFAULT NULL ON CONVERSION ERROR )>5000)| TC | Plan hash | 결과 | Aggregate로 간 행 | Buffers |
|---|---|---|---|---|
| TC01 Nested Loops | 727066511 | 성공 | 2,980 | 2,496 |
| TC02 Hash Join | 2374607030 | ORA-01722 | 0 | 확인 불가 |
| TC05 Hash Join + DEFAULT | 2374607030 | 성공 | 2,980 | 832 |
TC05는 실패한 TC02와 Plan hash가 같습니다. 풀스캔 필터에서 문자 값 194,000행은 NULL이 되어 조건을 통과하지 못했고, 숫자 값 중 2,980행이 남아 TC01과 같은 건수가 나왔습니다. Buffers는 832로 Nested Loops의 2,496보다 약 3배 적었습니다. 이 데이터에서는 옵티마이저가 고른 Hash Join이 실제로도 더 싼 계획이었고, 문제는 계획이 아니라 표현식이었다는 뜻입니다.
다만 DEFAULT NULL은 변환에 실패한 값을 조용히 제외합니다. 숫자형 코드에 1,000처럼 쉼표가 들어간 값이 섞여 있다면, NLS_NUMERIC_CHARACTERS가 .,인 이 환경에서는 오류 없이 결과에서 빠질 수 있습니다. 이번 데이터는 숫자형 코드 6,000행이 모두 변환 가능해서 이 차이가 드러나지 않았습니다. 잘못된 숫자 데이터를 찾아내야 하는 업무라면, 앞의 분포 확인처럼 VALIDATE_CONVERSION으로 변환 불가 행을 따로 세는 점검이 함께 필요합니다.
형변환이 섞인 조건을 운영 SQL에서 다룰 때
힌트로 Nested Loops를 고정하는 것은 해결이 아닙니다
TC01은 오류 없이 끝났지만, Cost는 기본 계획의 29배였고 실제 Buffers도 3배였습니다. 성공한 이유도 SQL이 안전해서가 아니라, 실행계획이 우연히 문자 값을 읽지 않았기 때문입니다. 데이터 분포나 통계가 바뀌어 다른 계획이 선택되면 같은 오류가 다시 날 수 있습니다. 통계를 다시 수집해 이전 계획으로 되돌리는 방식도 같은 이유로 근본적인 조치가 되지 않습니다.
잘 돌던 SQL에서 ORA-01722가 생기면 필터가 붙은 줄부터 봅니다
SQL과 데이터가 그대로인데 오류가 새로 생겼다면, 실행계획이 바뀌었을 가능성이 있습니다. 이전 계획과 현재 계획의 Predicate Information에서 TO_NUMBER 같은 변환 함수가 어느 Id에 붙어 있는지 비교합니다. 조인 이후 단계에서 풀스캔 단계로 옮겨갔다면 이번 TC02와 같은 구조입니다. 문제 행의 규모는 VALIDATE_CONVERSION으로 오류 없이 셀 수 있습니다.
이번 데이터에서는 옵티마이저가 숫자형 코드의 비율을 크게 과대평가해 처음부터 Hash Join을 골랐습니다. 숫자형 코드가 드물다는 사실을 통계가 반영하는 환경이라면 Nested Loops가 기본 계획이 되어, 같은 SQL이 오류 없이 돌다가 어느 날 오류를 낼 수 있습니다. 이 경우는 이번에 확인하지 않았습니다. 반대로 컬럼의 모든 값이 숫자로 변환된다면 어느 계획에서도 오류는 나지 않습니다. 이번 결과는 XE의 단일 세션, 200,000건, 두 가지 조인 방식에서만 확인한 것입니다.
검색값이 숫자로 들어와도 컬럼에 같은 TO_NUMBER가 붙습니다
운영에서는 VARCHAR2 컬럼에 인덱스가 있는데, 애플리케이션이 검색값을 숫자형으로 전달해서 SQL이 느려진 경우를 본 적이 있습니다. 문자 컬럼과 숫자 값을 비교하면 Oracle은 컬럼 쪽을 숫자로 바꿔 비교합니다. SQL 작성자가 TO_NUMBER를 직접 쓰지 않아도, 실행계획에는 앞에서 본 TO_NUMBER(o.opt_value)와 같은 형태의 변환이 컬럼에 붙는다는 뜻입니다.
컬럼에 변환 함수가 씌워지면 그 컬럼의 일반 인덱스로 범위를 좁히기 어려워지고, 컬럼에 숫자가 아닌 값이 하나라도 섞여 있으면 이번처럼 ORA-01722까지 이어질 수 있습니다. 느려진 SQL과 오류가 난 SQL이 같은 원인에서 나올 수 있는 셈입니다. 그래서 두 경우 모두 Predicate Information에서 컬럼 쪽에 TO_NUMBER가 붙어 있는지부터 확인하는 편이 빠릅니다. 바인드 변수의 타입을 컬럼과 같은 문자형으로 맞추고, 리터럴이라면 따옴표로 감싸 문자끼리 비교하게 하는 것이 기본 조치입니다. 숫자로 전달된 검색값 때문에 인덱스를 못 타는 경우는 이번 테스트에서 따로 재현하지 않았습니다.

댓글 0
첫 댓글을 남겨보세요.