CLOB을 WHERE·GROUP BY에 넣으면 ORA-00932, 우회책이 다시 깨진 세 지점
DISTINCT 한 단어를 붙였을 뿐인데 돌아온 ORA-00932
ORA-00932: 일관성 없는 데이터 유형: -이(가) 필요하지만 CLOB임. 무엇이 필요한지는 비어 있고, CLOB이라는 말만 남은 메시지입니다.
이 메시지를 운영에서 만난 것은 조회 결과의 중복을 없애려고 SELECT에 DISTINCT를 붙였을 때였습니다. 조회 컬럼에 CLOB 본문이 들어 있었습니다. 업무상 중복 기준은 문서 ID였으므로, ID로 대상을 먼저 추린 뒤 본문을 따로 조회하는 방식으로 바꿔 해결했습니다.
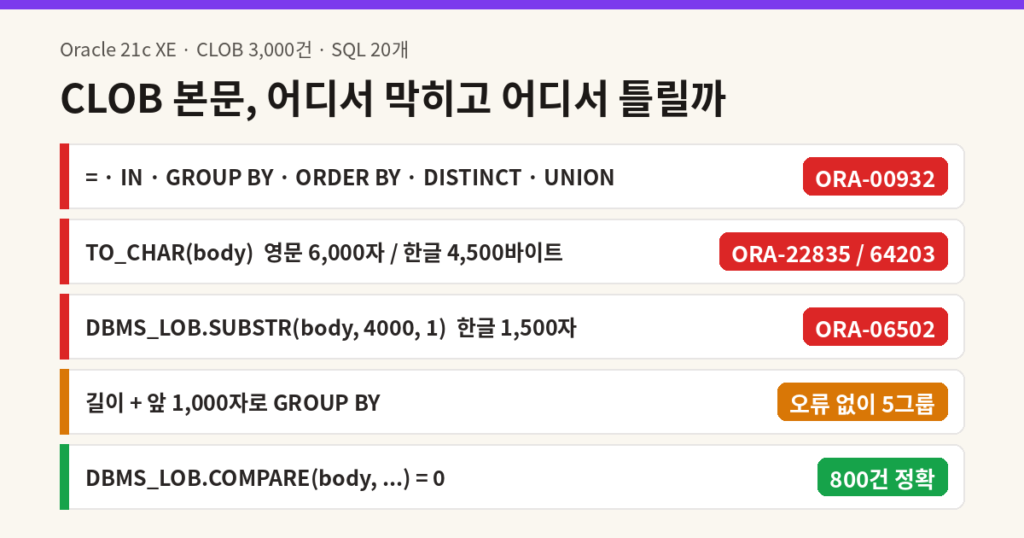
CLOB이 어느 연산까지 막히는지, 우회책으로 쓰는 방법은 어디서 다시 깨지는지를 21c XE에서 SQL 20개로 확인했습니다. 등호와 GROUP BY 같은 비교 연산부터 TO_CHAR, DBMS_LOB.SUBSTR, 앞부분만 잘라 묶기, 해시 함수까지 운영에서 실제로 손이 가는 방법을 차례로 넣어 봤습니다.
고객 문의 본문 3,000건, 길이와 문자가 다른 여섯 가지
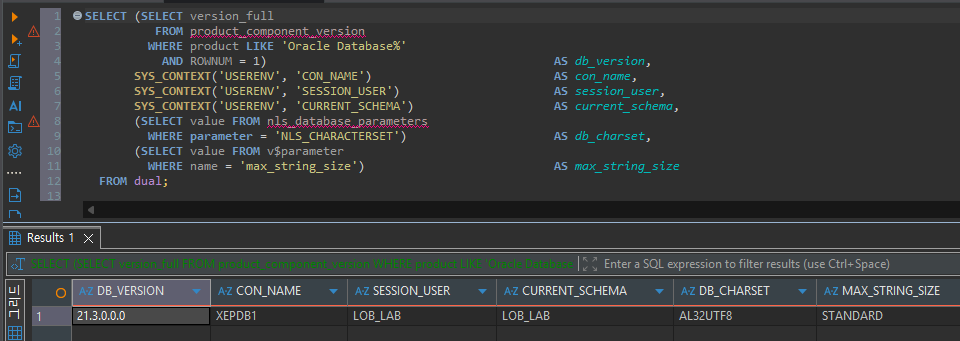
문자셋이 결과를 좌우하는 주제라 환경부터 확인했습니다. 21c XE의 XEPDB1, 데이터베이스 문자셋은 AL32UTF8이고 MAX_STRING_SIZE는 STANDARD입니다. 즉 SQL에서 VARCHAR2는 4,000바이트까지이고, 한글 한 글자는 3바이트입니다.
테스트 테이블 CS_INQUIRY는 가상의 고객 문의 테이블입니다. 본문은 미리 만든 여섯 가지 템플릿을 3,000건에 나눠 넣었습니다. 같은 본문이 수백 건씩 반복되어야 GROUP BY 결과가 맞는지 따질 수 있고, 성능을 재는 테스트가 아니라서 이 정도 규모로 충분했습니다.
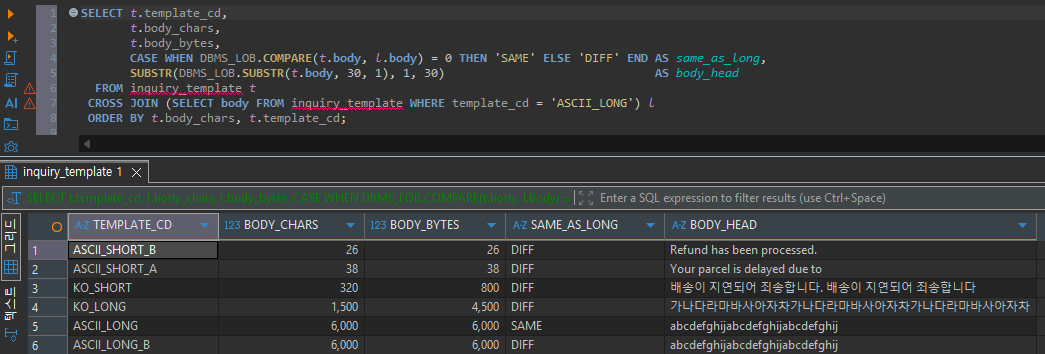
| 템플릿 | 문자 수 | 바이트 | 건수 | 넣은 이유 |
|---|---|---|---|---|
| ASCII_SHORT_A | 38 | 38 | 1,000 | 평범한 짧은 영문 |
| ASCII_SHORT_B | 26 | 26 | 800 | WHERE 비교 대상 Refund has been processed. |
| KO_SHORT | 320 | 800 | 600 | 짧은 한글 |
| KO_LONG | 1,500 | 4,500 | 300 | 글자는 4,000 미만, 바이트는 4,000 초과 |
| ASCII_LONG | 6,000 | 6,000 | 200 | 4,000바이트 초과 |
| ASCII_LONG_B | 6,000 | 6,000 | 100 | 위와 길이·앞부분이 같고 마지막 한 글자만 다름 |
SQL 20개는 PL/SQL 블록 하나에서 DBMS_SQL로 차례로 실행했습니다. 성공하면 가져온 행 수를, 실패하면 오류 메시지를 로그 테이블에 남기게 했습니다. 정답은 서로 다른 본문 6종, Refund has been processed. 800건입니다.
20개 중 통과한 SQL은 7개였습니다
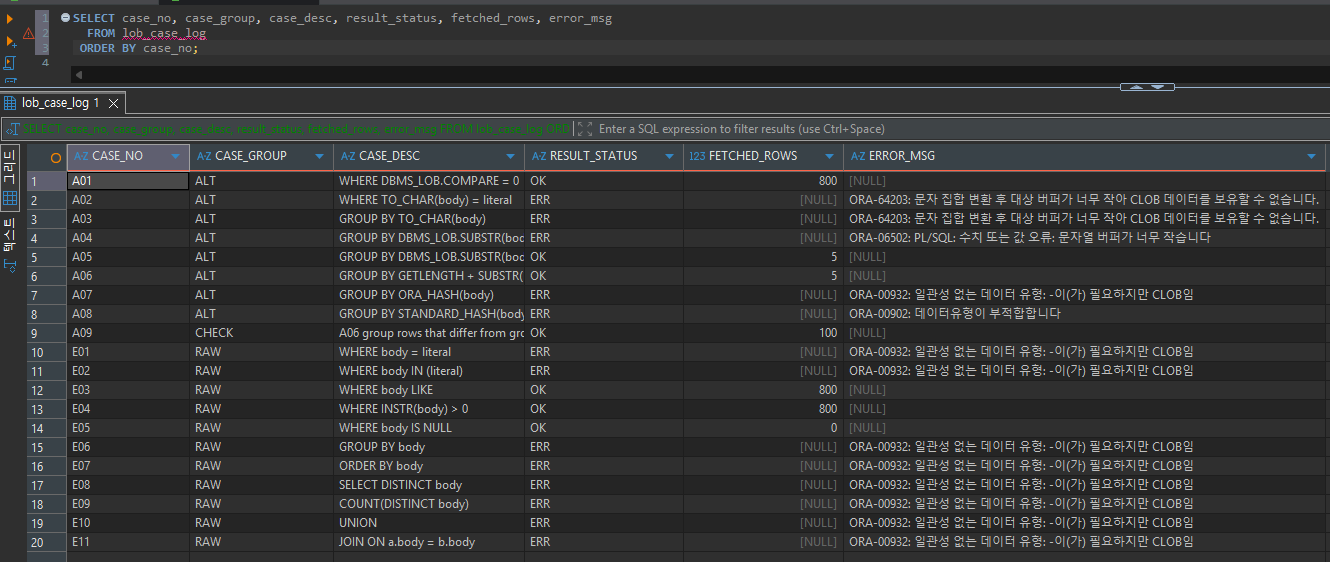
| 번호 | SQL | 결과 |
|---|---|---|
| E01·E02 | WHERE body = '…', body IN ('…') | ORA-00932 |
| E03·E04 | WHERE LIKE, INSTR(body, …) > 0 | 성공 800건 |
| E05 | WHERE body IS NULL | 성공 0건 |
| E06~E11 | GROUP BY, ORDER BY, DISTINCT, COUNT(DISTINCT), UNION, 조인 a.body = b.body | ORA-00932 |
| A01 | WHERE DBMS_LOB.COMPARE(body, TO_CLOB('…')) = 0 | 성공 800건 |
| A02·A03 | TO_CHAR(body) WHERE, GROUP BY | ORA-64203 |
| A04 | GROUP BY DBMS_LOB.SUBSTR(body, 4000, 1) | ORA-06502 |
| A05·A06 | GROUP BY 앞 1,000자, 길이 + 앞 1,000자 | 성공 5그룹 (정답 6) |
| A07 | GROUP BY ORA_HASH(body) | ORA-00932 |
| A08 | GROUP BY STANDARD_HASH(body) | ORA-00902 |
| A09 | A06 그룹의 대표 행과 DBMS_LOB.COMPARE로 실제로 다른 행 | 성공 100건 |
비교·정렬·집합 연산은 같은 오류 하나로 막혔습니다
등호 비교, IN, GROUP BY, ORDER BY, DISTINCT, COUNT(DISTINCT), UNION, 조인 조건까지 여덟 가지가 모두 같은 ORA-00932로 실패했습니다. 공통점은 값끼리 같은지 다른지, 혹은 어느 쪽이 큰지를 따져야 하는 연산이라는 것입니다. CLOB에 그대로 GROUP BY를 걸면 DBeaver에서는 아래처럼 보입니다.
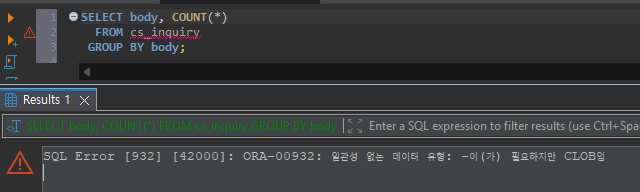
반면 LIKE와 INSTR은 CLOB을 그대로 받아 800건을 정확히 찾았고, IS NULL도 문제없이 0건을 돌려줬습니다. 특정 문자열을 찾는 목적이라면 등호 대신 이 둘로 조건을 바꾸는 것만으로 오류가 사라집니다. 다만 INSTR은 포함 여부만 보고, LIKE는 와일드카드가 없을 때만 등호와 같은 의미입니다. 본문에 %나 _가 섞이면 결과가 달라질 수 있습니다.
TO_CHAR가 남긴 오류 코드는 어떤 행을 먼저 만나느냐에 따라 달랐습니다
매트릭스에서 TO_CHAR(body)는 WHERE와 GROUP BY 모두 ORA-64203: 문자 집합 변환 후 대상 버퍼가 너무 작아 CLOB 데이터를 보유할 수 없습니다로 실패했습니다. 4,000바이트를 넘는 긴 행은 영문(ASCII_LONG)과 한글(KO_LONG) 두 종류라서, 템플릿을 하나씩 걸러 다시 실행했습니다.
SELECT COUNT(*)
  FROM cs_inquiry
 WHERE template_cd = 'ASCII_LONG'
   AND TO_CHAR(body) IS NOT NULL;
-- ORA-22835: 버퍼가 너무 작아 CLOB를 CHAR 또는 BLOB에서 RAW로 변환할 수 없습니다(실제: 6000, 최대: 4000).

SELECT COUNT(*)
  FROM cs_inquiry
 WHERE template_cd = 'KO_LONG'
   AND TO_CHAR(body) IS NOT NULL;
-- ORA-64203: 문자 집합 변환 후 대상 버퍼가 너무 작아 CLOB 데이터를 보유할 수 없습니다.
영문 6,000자 행은 ORA-22835로, 실제 길이 6,000과 최대 4,000이 메시지에 그대로 찍혔습니다. 한글 1,500자 행은 글자 수로는 4,000 미만인데도 바이트로 바꾸는 단계에서 ORA-64203이 났습니다.
매트릭스에서 ORA-64203이 나온 것은 데이터 순서 때문으로 보입니다. 행 번호 순서로 넣을 때 KO_LONG(번호를 30으로 나눈 나머지 24~26)이 ASCII_LONG(27~28)보다 앞에 있었고, 전체 스캔이 한글 긴 행을 먼저 만났을 것이라고 추정합니다. 같은 SQL이라도 데이터 구성과 읽는 순서에 따라 받는 오류 코드가 달라질 수 있다는 뜻입니다. 행을 읽는 순서가 오류를 정하는 모습은 ORA-01722와 실행계획 평가 순서 글에서 본 것과 비슷합니다.
운영에서도 짧은 데이터로 테스트할 때는 TO_CHAR 변환이 문제없다가, 긴 본문이 들어오면서 ORA-22835가 난 적이 있습니다. 이번 결과로 보면, 한글 위주의 본문이 먼저 걸렸다면 같은 상황에서 ORA-64203을 받았을 수도 있습니다. 오류 코드 하나만으로 검색하면 원인을 놓치기 쉬운 이유입니다.
DBMS_LOB.SUBSTR의 4000은 글자 수, 한도는 바이트입니다
GROUP BY DBMS_LOB.SUBSTR(body, 4000, 1)은 ORA-06502: PL/SQL: 수치 또는 값 오류: 문자열 버퍼가 너무 작습니다로 실패했습니다. CLOB에 쓰는 DBMS_LOB.SUBSTR의 두 번째 인자는 글자 수입니다. 그래서 KO_LONG 1,500자는 통째로 잘려 나오는데, 그 결과가 4,500바이트라 SQL의 VARCHAR2 한도 4,000바이트를 넘습니다. 영문만 있었다면 통과했을 SQL이 한글 300건 때문에 전부 실패한 것입니다.
미리보기를 DBMS_LOB.SUBSTR로 분리했을 때도 비슷한 일을 겪었습니다. 한글 데이터가 PL/SQL 수신 변수의 바이트 크기를 넘었고, 추출 길이와 수신 변수 크기를 함께 조정한 뒤 본문 전체는 CLOB 그대로 처리했습니다. 한글만 있다고 보면 4,000바이트 안에 들어가는 길이는 1,333자까지라는 계산이 나옵니다. 하지만 실제 본문은 영문, 숫자, 이모지가 섞여 바이트 수가 달라지므로, 미리보기 길이는 그보다 넉넉히 줄여 잡는 편이 안전합니다.
오류 없이 틀린 다섯 그룹
앞 1,000자로 GROUP BY한 A05는 오류 없이 5그룹을 돌려줬습니다. 정답은 6그룹입니다. 길이까지 함께 묶은 A06도 똑같이 5그룹이었습니다. ASCII_LONG과 ASCII_LONG_B는 길이도 6,000으로 같고 앞 1,000자도 같기 때문에, 둘을 가를 기준이 그룹 키 안에 없습니다.
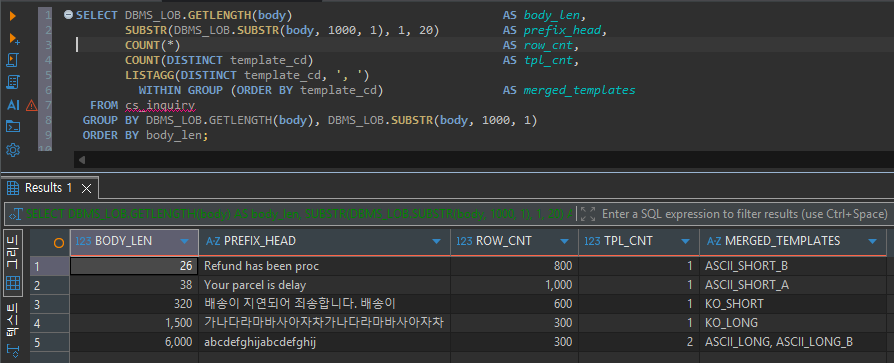
6,000자 그룹은 300건, 템플릿 2종으로 묶였습니다. 이 결과를 그대로 중복 판정에 썼다면 서로 다른 본문 100건이 같은 본문으로 처리됐을 것입니다. 오류가 나지 않아서 결과 숫자만 봐서는 알 수 없습니다.
A09는 이 그룹핑을 검증하는 방법입니다. 그룹마다 가장 작은 ID를 대표 행으로 정하고, 같은 그룹의 모든 행을 DBMS_LOB.COMPARE로 대표 행과 비교했습니다. 그 결과 대표 행과 실제로 다른 100건, 즉 ASCII_LONG_B가 정확히 걸러졌습니다.
해시 함수로 짧은 키를 만드는 방법은 두 함수 모두 CLOB을 직접 받지 못했습니다. ORA_HASH는 ORA-00932, STANDARD_HASH는 ORA-00902: 데이터유형이 부적합합니다로, 같은 이유인데도 오류 코드가 달랐습니다.
CLOB 본문을 비교하거나 묶어야 할 때 고르는 순서
이번 결과는 AL32UTF8, MAX_STRING_SIZE STANDARD, 3,000건 기준입니다. EXTENDED로 VARCHAR2 한도가 32,767바이트로 늘어난 환경이나 다른 문자셋에서는 실패하는 행과 오류 코드가 달라질 수 있습니다. 대안별 실행 시간과 I/O는 재지 않았습니다. 그 전제 아래에서, CLOB 본문을 다룰 때 판단 순서는 아래와 같습니다.
- 중복 기준이 본문이 아니라면 문서 ID 같은 키로 대상을 먼저 추리고, 본문은 마지막에 붙입니다. DISTINCT 사례도 이 방식으로 해결했습니다.
- 본문 전체가 같은지 판정할 때는
DBMS_LOB.COMPARE(…) = 0을 씁니다. LIKE와 INSTR도 이번에 800건을 찾았지만, 길이와 문자 종류에 관계없이 본문 전체의 일치를 판정한 것은 COMPARE였습니다. - 본문 일부를 포함하는지만 보면 될 때는
LIKE나INSTR로 충분합니다. - 본문 기준 그룹핑이 꼭 필요하면 길이와 앞부분으로 1차로 묶고, 반드시
DBMS_LOB.COMPARE로 그룹 안을 다시 확인합니다. 1차 그룹 결과만으로는 서로 다른 본문 100건이 합쳐진 것을 알 수 없었습니다. DBMS_LOB.SUBSTR는 미리보기에만 쓰고, 잘라 낼 길이는 결과가 4,000바이트 안에 들어오는지로 정합니다. 길이가 보장되지 않는 본문에는TO_CHAR를 쓰지 않습니다. 긴 행 하나 때문에 SQL 전체가 멈춥니다.

댓글 0
첫 댓글을 남겨보세요.