건별 INSERT를 FORALL로 바꾸면 redo도 줄어들까? 30만 건 적재 4가지 방식 실측 (Oracle 21c)
정산 원천 30만 건을 이력 테이블로 옮기는 네 가지 PL/SQL
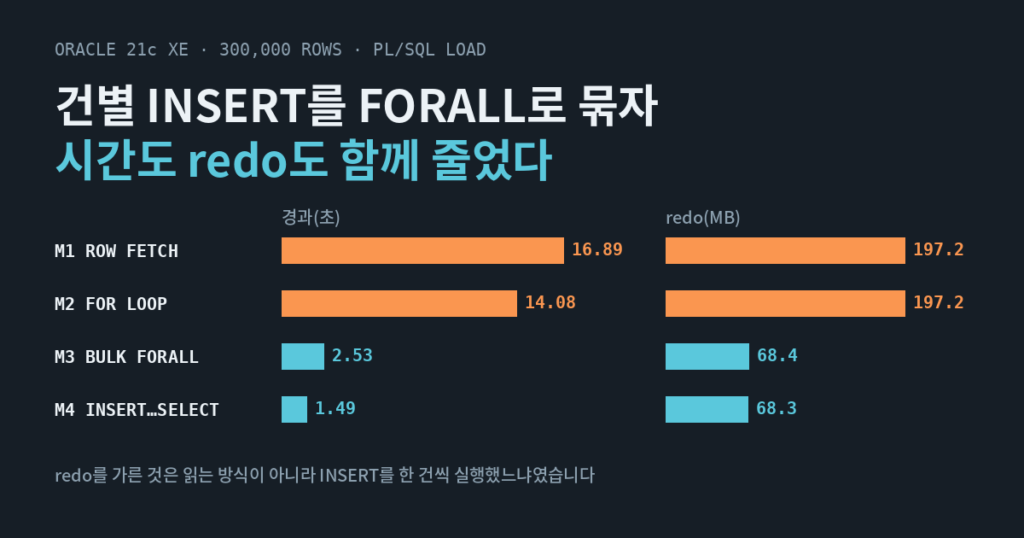
정산 원천 테이블 30만 건을 이력 테이블로 옮기는 PL/SQL을 네 가지 방식으로 작성해 각각 4번씩 실행했습니다. run 1~3 중앙값 기준으로, 건별로 INSERT한 두 방식은 회당 redo가 197.2MB였습니다. 배열로 넣은 두 방식은 68.4MB와 68.3MB였습니다. 처리 시간은 16.89초부터 1.49초까지 벌어졌습니다.
따져 본 것은 두 가지입니다. 건별 INSERT를 FORALL로 바꾸면 시간만 줄어드는지 redo도 함께 줄어드는지, 그리고 행 단위 처리 코드로 보이는 커서 FOR 루프가 정말 한 건씩 읽는지입니다.
SETTLEMENT_STAGE 30만 건을 SETTLEMENT_HISTORY로
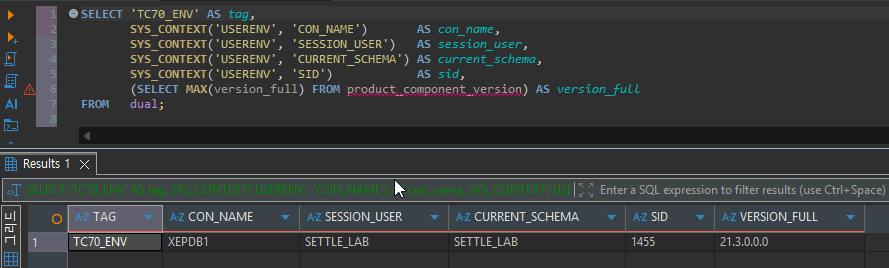
데이터는 정산 업무를 가정한 가상 데이터입니다. Oracle Database 21c Express Edition(21.3.0.0.0)의 XEPDB1에 테스트 사용자 SETTLE_LAB을 만들어 DBeaver에서 실행했습니다. V_$MYSTAT, V_$STATNAME, V_$SQL의 SELECT 권한은 롤이 아니라 직접 부여했습니다. 프로시저 안에서 V$MYSTAT을 읽으려면 롤 권한으로는 안 되기 때문입니다.
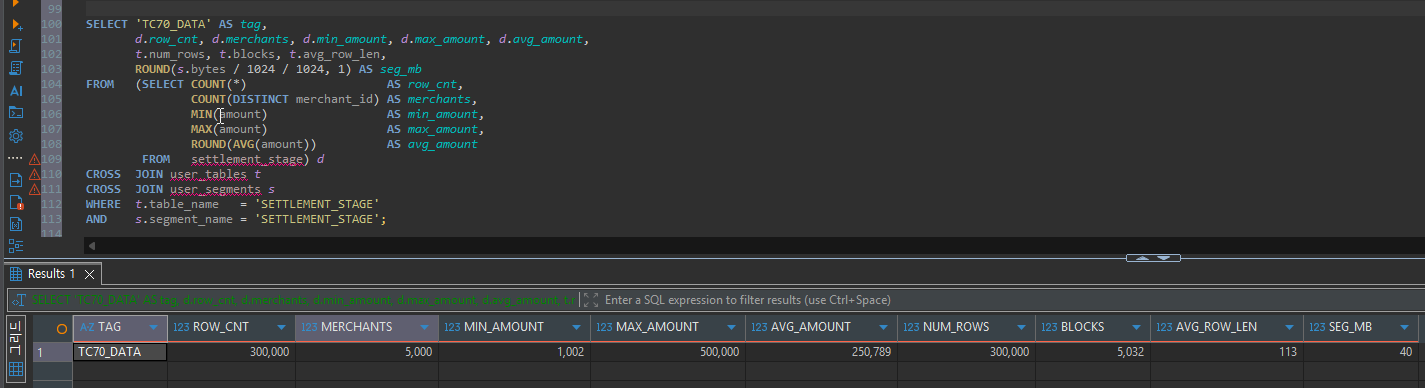
원천 테이블 SETTLEMENT_STAGE는 30만 건입니다. 가맹점 번호(1~5000), 금액(1,000~500,000), 수수료율(0.5~3.5%)은 모두 균등 분포로 만들었고, DBMS_RANDOM.SEED(70)로 값을 고정했습니다.
30만 건이면 방식별 건당 비용 차이가 초 단위로 드러납니다. 통계 기준 BLOCKS 5,032, AVG_ROW_LEN 113, 세그먼트 40MB입니다.
적재 대상 SETTLEMENT_HISTORY에는 PK 인덱스 하나만 두었습니다. DB는 NOARCHIVELOG 모드이고, 온라인 redo 로그는 200MB짜리 3개입니다.
비교한 네 가지 방식
| 방식 | 읽기 | 쓰기 |
|---|---|---|
| M1_ROW_FETCH | 명시적 커서 OPEN 후 FETCH INTO 1건씩 | 건별 INSERT |
| M2_FOR_LOOP | 커서 FOR 루프 | 건별 INSERT |
| M3_BULK_FORALL | BULK COLLECT LIMIT 1000 | FORALL INSERT |
| M4_INSERT_SELECT | INSERT…SELECT 한 문장 (APPEND 미사용) | |
네 방식 모두 수수료와 정산액을 같은 식으로 계산하고, COMMIT은 마지막에 한 번만 합니다. 측정은 프로시저 RUN_LOAD가 맡았습니다. 대상 테이블을 TRUNCATE한 직후 세션 통계를 읽고, 적재와 COMMIT이 끝나면 다시 읽어 그 차이를 결과 테이블에 저장합니다. 세션 통계는 다음 쿼리로 읽었습니다.
SELECT SUM(CASE WHEN n.name = 'redo size'               THEN m.value END),
       SUM(CASE WHEN n.name = 'redo entries'            THEN m.value END),
       SUM(CASE WHEN n.name = 'undo change vector size' THEN m.value END),
       SUM(CASE WHEN n.name = 'execute count'           THEN m.value END)
INTO   o_redo, o_ent, o_undo, o_exec
FROM   v$mystat m
JOIN   v$statname n ON n.statistic# = m.statistic#
WHERE  n.name IN ('redo size', 'redo entries', 'undo change vector size', 'execute count');
M1과 M3의 핵심 루프는 다음과 같습니다. 원천 SELECT와 INSERT에 'TC70_M1' 같은 태그 리터럴을 넣어 두었습니다. V$SQL에서 방식별 커서를 구분하기 위해서입니다.
-- M1: 한 건 fetch, 한 건 INSERT
OPEN c_m1;
LOOP
  FETCH c_m1 INTO r1;
  EXIT WHEN c_m1%NOTFOUND;
  INSERT INTO settlement_history (settle_id, merchant_id, pay_method, amount, fee_amount, net_amount, settle_date, load_tag, memo)
  VALUES (r1.stage_id, r1.merchant_id, r1.pay_method, r1.amount,
          ROUND(r1.amount * r1.fee_rate, 2),
          r1.amount - ROUND(r1.amount * r1.fee_rate, 2),
          TRUNC(r1.approved_at) + 1, 'TC70_M1', r1.memo);
END LOOP;
CLOSE c_m1;

-- M3: 1000건씩 fetch, 1000건씩 INSERT
OPEN c_m3;
LOOP
  FETCH c_m3 BULK COLLECT INTO v_buf LIMIT 1000;
  EXIT WHEN v_buf.COUNT = 0;
  FORALL i IN 1 .. v_buf.COUNT
    INSERT INTO settlement_history (settle_id, merchant_id, pay_method, amount, fee_amount, net_amount, settle_date, load_tag, memo)
    VALUES (v_buf(i).stage_id, v_buf(i).merchant_id, v_buf(i).pay_method, v_buf(i).amount,
            ROUND(v_buf(i).amount * v_buf(i).fee_rate, 2),
            v_buf(i).amount - ROUND(v_buf(i).amount * v_buf(i).fee_rate, 2),
            TRUNC(v_buf(i).approved_at) + 1, 'TC70_M3', v_buf(i).memo);
END LOOP;
CLOSE c_m3;
시간은 DBMS_UTILITY.GET_TIME, CPU는 DBMS_UTILITY.GET_CPU_TIME으로 쟀습니다. 둘 다 단위는 1/100초입니다. run 0은 첫 실행이라 따로 두었고, 비교에는 run 1~3의 중앙값을 썼습니다.
16번 적재한 결과와 중앙값
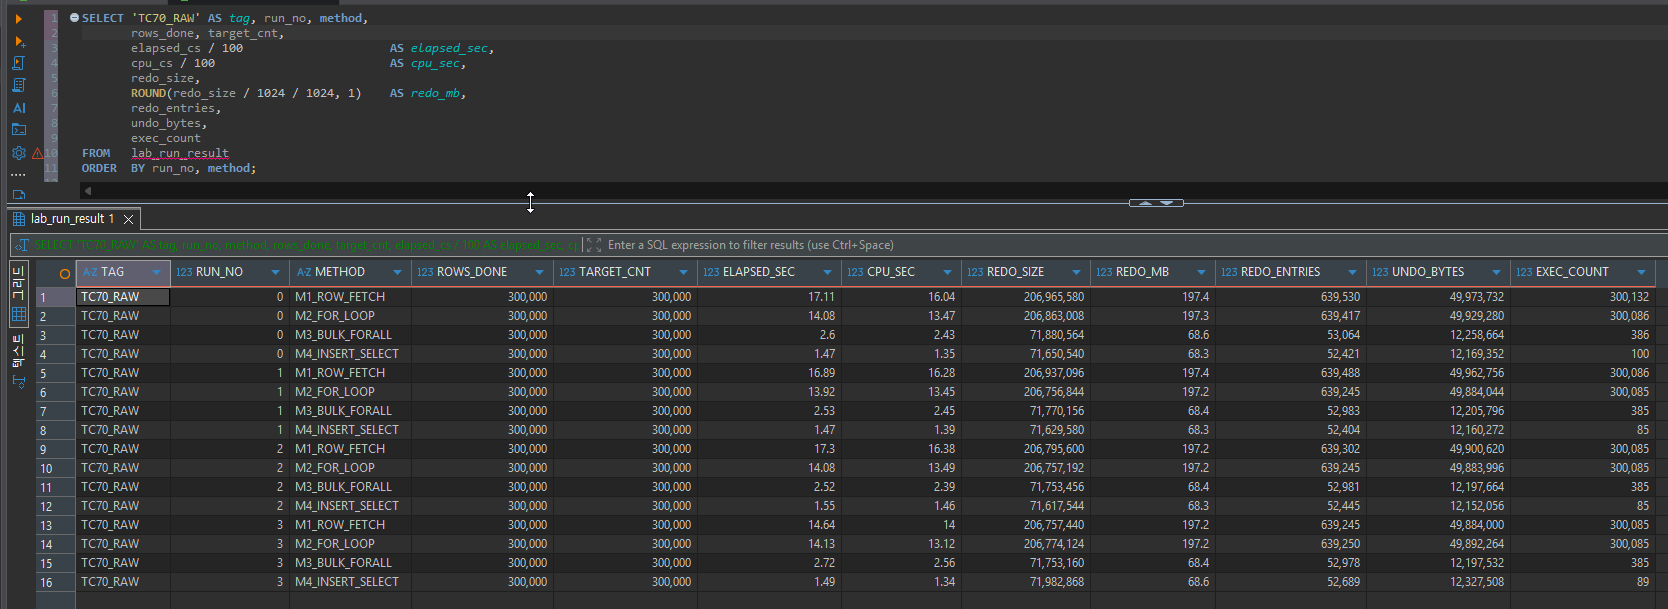
run 0과 이후 회차의 차이는 크지 않았습니다. M1은 run 0에서 17.11초, M4는 1.47초로 run 1~3과 비슷했습니다. 데이터를 만든 직후라 원천 블록이 이미 버퍼 캐시에 올라와 있었을 가능성이 있습니다.
눈에 띄는 편차는 run 3의 M1 하나였습니다. run 1, 2에서 16.89초와 17.3초였던 M1이 run 3에서는 14.64초로 M2(14.13초)와 비슷했습니다. redo와 실행 횟수는 다른 회차와 같았고, 원인은 확인하지 못했습니다. 비교에 평균이 아니라 중앙값을 쓴 이유입니다.
처음 실행한 드라이버 블록은 run 3을 기록하지 못했습니다. V$SQL에서 M1 원천 SELECT가 EXECUTIONS 5, ROWS_PROCESSED 1,470,353이므로, 정상 4회분을 빼면 run 3의 M1이 270,353건 지점에서 멈춘 것으로 보입니다. 그 상태로 run 1~3 중앙값을 구하자 MEDIAN()이 값 두 개의 평균을 돌려줬습니다. M1의 17.095초는 측정값이 아니라 16.89초와 17.3초의 평균이었습니다. run 3만 다시 실행해 16건을 채운 뒤 집계했습니다. 회차별 건수를 먼저 세지 않으면 중앙값처럼 보이는 평균을 그대로 쓰게 됩니다.
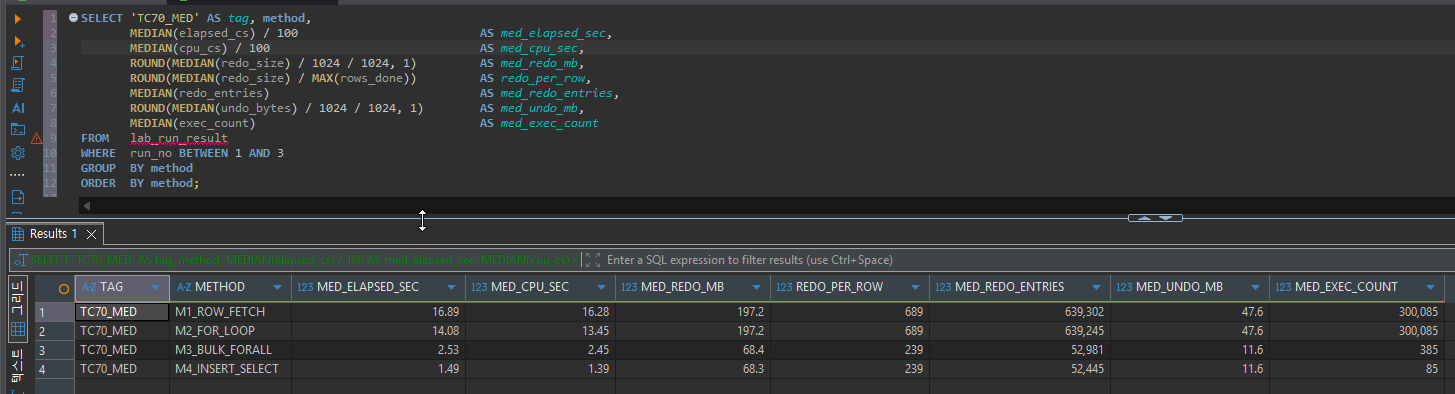
| 방식 | 경과(초) | CPU(초) | redo | 행당 redo | redo entries | undo | execute count |
|---|---|---|---|---|---|---|---|
| M1_ROW_FETCH | 16.89 | 16.28 | 197.2MB | 689B | 639,302 | 47.6MB | 300,085 |
| M2_FOR_LOOP | 14.08 | 13.45 | 197.2MB | 689B | 639,245 | 47.6MB | 300,085 |
| M3_BULK_FORALL | 2.53 | 2.45 | 68.4MB | 239B | 52,981 | 11.6MB | 385 |
| M4_INSERT_SELECT | 1.49 | 1.39 | 68.3MB | 239B | 52,445 | 11.6MB | 85 |
시간: 건별 INSERT를 없애자 16.89초가 2.53초가 됐습니다
FORALL(M3)은 명시적 FETCH 루프(M1)보다 약 6.7배, 커서 FOR 루프(M2)보다 약 5.6배 빨랐습니다. INSERT…SELECT(M4)는 FORALL보다도 약 1.7배 빨랐고, M1과 비교하면 약 11.3배 차이입니다.
네 방식 모두 CPU 시간이 경과 시간의 93~97%를 차지했습니다. 이번 환경에서는 대기가 아니라 CPU 처리가 시간을 결정했다는 뜻입니다. 단일 세션이고 COMMIT도 한 번뿐이라 log file sync 같은 대기가 끼어들 여지가 적었습니다.
M1과 M3의 차이는 PL/SQL과 SQL 엔진 사이를 30만 번 오가느냐 300번 오가느냐에서 생긴 것으로 봅니다. 실행 횟수가 이 해석과 맞지만, 문맥 전환 비용만 따로 잰 것은 아닙니다.
redo: 읽는 방식을 바꿔도 redo는 그대로였습니다
M1과 M2는 읽는 방식만 다르고, INSERT는 둘 다 건별입니다. redo도 197.2MB, 행당 689바이트로 같았습니다. M3와 M4 역시 68.4MB와 68.3MB, 행당 239바이트로 사실상 같습니다. redo를 가른 것은 INSERT를 한 건씩 실행했느냐, 여러 건을 한 번에 실행했느냐였습니다. 건별 INSERT 쪽이 약 2.9배 많았습니다.
redo entries의 차이는 더 컸습니다. 건별 INSERT는 약 63만 9천 개로 행당 약 2.13개였고, 배열 INSERT는 약 5만 3천 개로 행당 약 0.18개였습니다. 약 12배 차이입니다. 배열 INSERT는 같은 블록에 들어가는 여러 행의 변경을 묶어서 기록합니다. 그만큼 레코드마다 붙는 헤더와 undo 기록이 줄어든 것으로 해석합니다. undo change vector size도 47.6MB와 11.6MB로 약 4.1배 차이가 났습니다.
이 테스트 DB는 NOARCHIVELOG라 redo가 아카이브로 쌓이지 않았습니다. 그래도 M1 한 번이 200MB짜리 온라인 로그 하나를 거의 채웠습니다. ARCHIVELOG 운영 DB라면 30만 건마다 197MB와 68MB의 차이가 거의 그대로 아카이브 로그 양의 차이로 이어집니다.
운영 환경에서 대용량 테이블 DELETE를 진행하던 중 아카이브 공간 사용률이 80% 임계치를 넘어 감지된 적이 있습니다. 그때는 그 테이블을 DELETE 대신 파티션 TRUNCATE로 작업해 달라고 개발자에게 요청해 대응했습니다. 대량 변경에서 아카이브 공간을 좌우하는 것은 처리 방식이고, 이번에도 같은 30만 건이 방식에 따라 약 2.9배 다른 redo를 만들었습니다.
처리 건수는 같았고, 실행 횟수와 fetch 단위가 달랐습니다
네 방식 모두 16회 내내 결과가 같았습니다. 처리 건수와 대상 테이블 건수는 300,000건, 정산액 합계는 73,734,270,071.62였습니다. 결과가 같으므로 시간과 redo의 차이는 처리 방식에서만 나온 것입니다.
세션 통계의 execute count는 M1과 M2가 300,085, M3가 385, M4가 85였습니다. M4의 85를 방식과 상관없는 고정분으로 보면, M1과 M2는 정확히 30만 번, M3는 300번 INSERT를 실행한 셈입니다. 300은 30만 건을 LIMIT 1000으로 나눈 묶음 수와 같습니다. 고정분 85는 TRUNCATE 이후 공간 할당 같은 재귀 SQL로 추정하며, 따로 확인하지는 않았습니다.
커서 FOR 루프는 100건씩 읽고 있었습니다
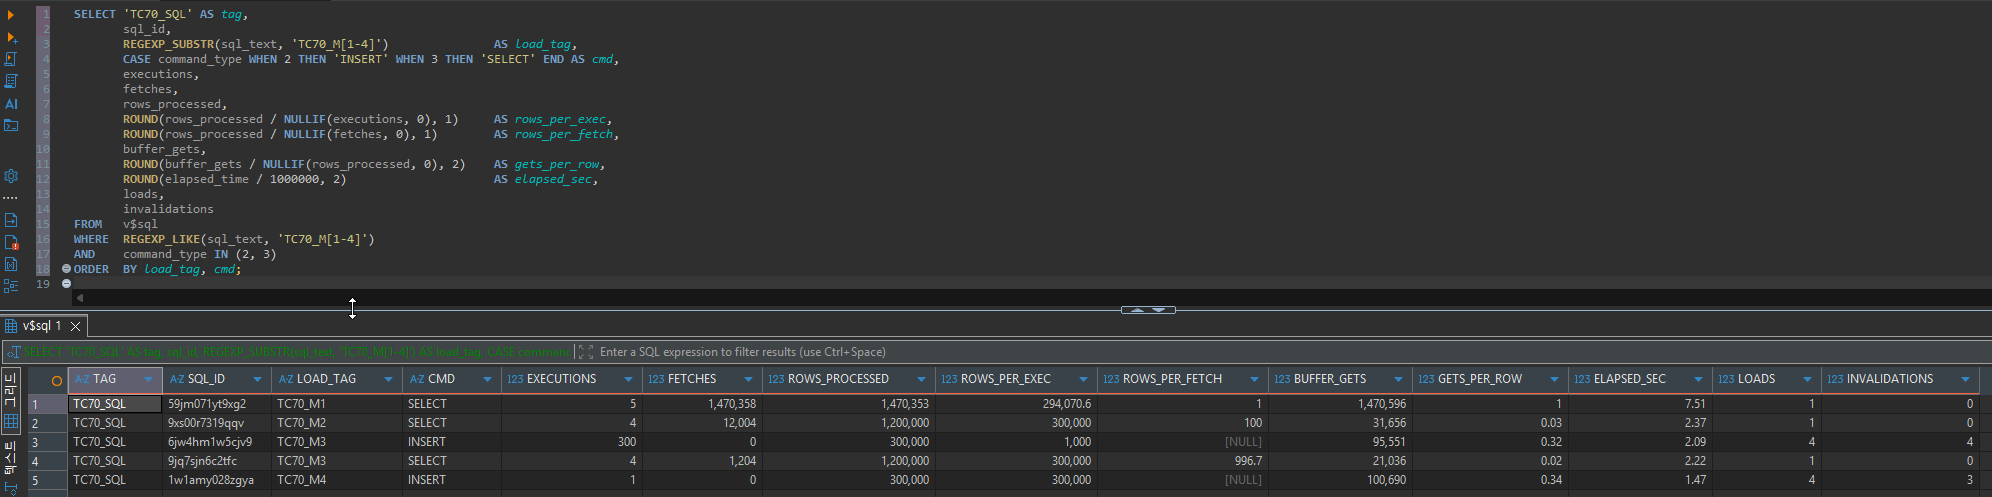
V$SQL의 원천 SELECT 커서에 fetch 단위가 그대로 드러났습니다. 아래는 4회 실행분이 누적된 값이고, M1에는 중간에 멈춘 1회분도 포함돼 있습니다.
| 원천 SELECT | FETCHES | ROWS_PROCESSED | fetch당 건수 | BUFFER_GETS | 행당 buffer get |
|---|---|---|---|---|---|
| TC70_M1 | 1,470,358 | 1,470,353 | 1 | 1,470,596 | 1 |
| TC70_M2 | 12,004 | 1,200,000 | 100 | 31,656 | 0.03 |
| TC70_M3 | 1,204 | 1,200,000 | 996.7 | 21,036 | 0.02 |
RUN_LOAD의 PLSQL_OPTIMIZE_LEVEL은 기본값인 2였습니다. 이 수준에서는 컴파일러가 커서 FOR 루프를 100건 단위 배열 fetch로 바꿉니다. 그래서 커서 FOR 루프를 한 건씩 처리하는 코드로 보는 것은 적어도 읽기 쪽에서는 맞지 않습니다. M3의 996.7은 실행마다 마지막에 빈 fetch가 한 번씩 붙어서 1,000보다 조금 낮게 나온 값입니다.
읽은 블록 수도 크게 달랐습니다.
- M1은 한 번에 한 건씩 가져오면서 행마다 buffer get이 한 번씩 생겼습니다.
- M2는 4회 실행에 31,656번, 회당 약 7,900번이었습니다.
- M3는 회당 약 5,260번으로, 원천 BLOCKS 5,032에 가까웠습니다.
M1과 M2의 시간 차이 2.81초는 이 읽기 쪽 차이에서 나왔다고 봅니다. 두 방식은 redo도 INSERT 실행 횟수도 같기 때문입니다. 반면 100건씩 읽은 M2와 1,000건씩 읽은 M3의 원천 SELECT 경과 시간은 4회 합계 2.37초와 2.22초로, 회당 약 0.04초 차이였습니다. 그래서 커서 FOR 루프를 BULK COLLECT로 바꾸기만 해서는 큰 이득이 없을 것으로 봅니다. 16.89초가 2.53초로 줄어든 몫은 대부분 INSERT를 FORALL로 묶은 데서 나왔습니다.
다만 M2와 M3 사이에서는 fetch 단위(100 → 1,000)와 INSERT 방식이 함께 바뀌었습니다. 두 요인의 몫을 정확히 나누려면 BULK COLLECT에 건별 INSERT를 붙인 조합을 따로 재야 합니다.
V$SQL 누적값을 그대로 읽으면 안 되는 이유 두 가지
첫째, TRUNCATE가 INSERT 커서를 매번 무효화했습니다. INSERT 커서는 LOADS 4, INVALIDATIONS 3~4였고, 실행 통계는 마지막 적재 1회분만 남아 있었습니다. FORALL INSERT는 EXECUTIONS 300, INSERT…SELECT는 1입니다. 반면 원천 SELECT는 무효화되지 않아 4회분이 누적돼 있습니다. 한 결과 화면 안에서도 행마다 집계 기간이 다른 셈입니다.
둘째, 태그로 구분하는 조회를 다시 했을 때는 M1과 M2의 건별 INSERT 커서가 V$SQL에 남아 있지 않았습니다. 공유 풀에서 밀려난 것으로 추정합니다. 그 직전 조회에서 보인 건별 INSERT 커서 하나는 EXECUTIONS 300,000, buffer gets 1,038,568(행당 약 3.46), 경과 9.39초였지만, M1과 M2 중 어느 쪽인지는 확인하지 못했습니다. FORALL INSERT는 행당 0.32, INSERT…SELECT는 0.34였습니다.
행 단위 배치를 리뷰할 때 보는 순서
이번 결과에서 가장 분명했던 것은 redo가 읽는 방식이 아니라 INSERT의 실행 단위를 따라갔다는 점입니다. 커서 FOR 루프는 이미 100건씩 읽고 있었습니다. 그러니 행 단위 배치를 리뷰할 때 먼저 볼 곳은 루프 안의 DML입니다. 이번 결과를 바탕으로 정한 판단 순서는 다음과 같습니다.
- V$SQL에서 배치 DML의 ROWS_PROCESSED를 EXECUTIONS로 나눠 봅니다. 1에 가까우면 루프 안에서 건별로 DML을 실행하고 있다는 뜻입니다. TRUNCATE 같은 DDL이 섞인 배치라면 LOADS와 INVALIDATIONS도 함께 보고, 그 값이 몇 회분인지부터 확인합니다.
- 변환 로직을 SQL 식으로 옮길 수 있으면 INSERT…SELECT로 바꿉니다. 이번에 가장 빨랐고, redo는 FORALL과 같으면서 시간은 약 1.7배 짧았습니다.
- 행마다 PL/SQL 판단이 필요해 루프를 없앨 수 없으면 FORALL로 묶습니다. 이번 데이터에서는 그것만으로 M1 대비 시간이 약 1/6.7, redo가 약 1/2.9로 줄었습니다.
- ARCHIVELOG 환경이라면 배치 세션의
V$SESSTAT에서redo size를 함께 기록해 두고, 아카이브 공간 계획에 씁니다.
COMMIT 단위를 정해 둔 운영 배치에서 다시 볼 숫자
운영에서는 배치의 COMMIT 단위를 대상 테이블의 액세스 빈도에 따라 정해서 작업하도록 하고 있습니다. 기본은 1만 건 단위이고, 액세스가 잦은 테이블이면 2,000~3,000건 단위로 커밋합니다.
이번 측정은 네 방식 모두 COMMIT을 마지막에 한 번만 했습니다. 같은 30만 건을 1만 건 단위로 커밋하면 COMMIT이 30번, 2,000건 단위면 150번 들어갑니다. COMMIT마다 커밋 redo와 log file sync 대기가 더해지므로 방식별 차이가 이번 숫자와 달라질 수 있지만, 이 조건은 측정하지 않았습니다. FORALL로 묶는다면 LIMIT를 COMMIT 단위의 약수로 맞춰 두는 편이 묶음 경계와 커밋 경계를 맞추기 쉽습니다. 이번에 쓴 LIMIT 1000은 1만 건, 2,000건, 3,000건 단위와 모두 맞아떨어집니다.
COMMIT 말고도 숫자를 바꿀 조건이 있습니다.
- 대상 테이블에는 PK 하나뿐입니다. 보조 인덱스가 붙으면 모든 방식의 redo가 늘어납니다. 그때도 배열 INSERT가 같은 비율로 유리한지는 이번에 확인하지 않았습니다.
- 단일 세션, XE의 CPU 제한 아래서 잰 값입니다. LIMIT는 1000 하나만 썼고, APPEND(direct-path) 적재와는 비교하지 않았습니다.
- run 3의 M1처럼 회차에 따라 2초 넘게 흔들린 경우가 있었습니다. M3와 M4의 1.7배처럼 1초 안쪽의 차이는 데이터 규모나 행 길이가 달라지면 바뀔 수 있습니다.

댓글 0
첫 댓글을 남겨보세요.