GATHER_PLAN_STATISTICS 힌트를 넣었는데도 A-Rows가 안 보이는 이유
DBMS_XPLAN.DISPLAY_CURSOR로 실행계획을 열었는데 E-Rows만 있고 A-Rows와 Buffers 열이 없는 경우가 있습니다. 실제로 몇 행을 처리했고 블록을 얼마나 읽었는지 알고 싶어서 조회한 것이니, 정작 필요한 숫자가 빠진 셈입니다.
원인은 대개 두 가지 중 하나입니다.
- SQL이 실행 통계를 수집하지 않은 상태로 실행되었습니다.
- 통계는 수집했지만 출력 형식이 그 통계를 보여 주지 않는 형식입니다.
두 경우 모두 화면에 열이 보이지 않는다는 점은 같습니다. 그래서 화면만 보고 원인을 구분하기 어렵습니다.
이 글에서는 Oracle 21c XE에서 같은 조건의 SQL을 세 가지 조합으로 조회해, 각 화면이 어떻게 다른지 비교했습니다. 결론부터 말하면, 세 화면 모두 실행계획은 같았습니다. Plan hash value 898571460, TABLE ACCESS FULL로 동일했습니다. 달라진 것은 우리가 볼 수 있는 정보의 양뿐이었습니다.
실험 환경
| 항목 | 조건 |
|---|---|
| DB | Oracle Database 21c XE (21.3.0.0.0), Windows |
| 접속 도구 | DBeaver |
| PDB / 계정 | XEPDB1 / XPLAN_LAB |
| 테이블 | XPLAN_STATS_TEST, 100,000행 |
| 조회 조건 | CUSTOMER_ID = 42 (1,000행, 전체의 1%) |
| 인덱스 | PK_XPLAN_STATS_TEST(ID), IX_XPLAN_STATS_CUSTOMER(CUSTOMER_ID) |
| 세션 STATISTICS_LEVEL | TYPICAL (기본값) |
세 조회 모두 WHERE 조건과 집계식은 같습니다. 바꾼 것은 GATHER_PLAN_STATISTICS 힌트 유무와 DISPLAY_CURSOR의 출력 형식뿐입니다. 캐시를 비우거나 시스템 설정을 바꾸지 않았으므로, 속도를 비교하는 실험은 아닙니다.
권한과 테스트 데이터 준비
실습 계정 권한
XPLAN_LAB 계정이 이미 있다는 전제입니다. 같은 PDB에 SYS로 접속해 실행합니다.
sql
GRANT CREATE SESSION, CREATE TABLE TO xplan_lab;
ALTER USER xplan_lab QUOTA 100M ON users;

GRANT SELECT ON sys.v_$sql TO xplan_lab;
GRANT SELECT ON sys.v_$sql_plan TO xplan_lab;
GRANT SELECT ON sys.v_$session TO xplan_lab;
GRANT SELECT ON sys.v_$sql_plan_statistics_all TO xplan_lab;
GRANT SELECT ON sys.v_$parameter TO xplan_lab;

GRANT EXECUTE ON sys.dbms_xplan TO xplan_lab;
GRANT EXECUTE ON sys.dbms_stats TO xplan_lab;
DISPLAY_CURSOR는 V$SQL, V$SQL_PLAN, V$SQL_PLAN_STATISTICS_ALL을 읽습니다. 이 중 V$SQL_PLAN_STATISTICS_ALL 권한이 없으면, 통계를 수집했어도 실제 통계가 보이지 않거나 오류가 납니다. 권한 부족도 “A-Rows가 안 보이는” 원인이 될 수 있으므로 처음에 정리해 두는 것이 좋습니다.
권한은 PDB별로 적용됩니다. 관리자 연결과 실습 연결이 같은 PDB인지 먼저 확인합니다.
sql
SELECT USER AS login_user,
       SYS_CONTEXT('USERENV', 'CON_NAME') AS pdb_name
FROM dual;
테이블 생성과 데이터 적재
이후 SQL은 XPLAN_LAB으로 실행합니다. 첫 블록은 같은 이름의 테이블이 있으면 삭제합니다. DBeaver에서는 BEGIN부터 END;까지를 한 문장으로 실행합니다.
sql
BEGIN
    EXECUTE IMMEDIATE 'DROP TABLE xplan_stats_test PURGE';
EXCEPTION
    WHEN OTHERS THEN
        IF SQLCODE != -942 THEN
            RAISE;
        END IF;
END;

CREATE TABLE xplan_stats_test (
    id           NUMBER        NOT NULL,
    customer_id  NUMBER        NOT NULL,
    amount       NUMBER(12, 2) NOT NULL,
    padding      VARCHAR2(200),
    CONSTRAINT pk_xplan_stats_test PRIMARY KEY (id)
);

INSERT INTO xplan_stats_test (id, customer_id, amount, padding)
SELECT
    LEVEL,
    MOD(LEVEL - 1, 100) + 1,
    MOD(LEVEL, 1000) + 1,
    RPAD('X', 200, 'X')
FROM dual
CONNECT BY LEVEL <= 100000;

COMMIT;

CREATE INDEX ix_xplan_stats_customer
    ON xplan_stats_test (customer_id);

BEGIN
    DBMS_STATS.GATHER_TABLE_STATS(
        ownname          => USER,
        tabname          => 'XPLAN_STATS_TEST',
        estimate_percent => 100,
        method_opt       => 'FOR ALL COLUMNS SIZE 1',
        cascade          => TRUE
    );
END;
CUSTOMER_ID는 1~100이 순서대로 반복되므로, 고객마다 정확히 1,000행씩 고르게 분포합니다. 이 실험은 지난 글처럼 통계와 데이터가 어긋나는 상황을 만들지 않았습니다. 예상과 실제가 일치하는 조건에서 “보이느냐, 안 보이느냐”만 비교하기 위해서입니다.
준비 상태를 한 번에 확인
세션 설정, 데이터 건수, 인덱스 구성을 한 번의 조회로 확인했습니다.
sql
WITH data_summary AS (
    SELECT COUNT(*) AS total_rows,
           COUNT(DISTINCT customer_id) AS customer_count,
           SUM(CASE WHEN customer_id = 42 THEN 1 ELSE 0 END) AS target_rows
    FROM xplan_stats_test
), index_summary AS (
    SELECT LISTAGG(index_name || '(' || column_name || ')', ', ')
               WITHIN GROUP (ORDER BY index_name, column_position) AS index_columns
    FROM user_ind_columns
    WHERE table_name = 'XPLAN_STATS_TEST'
)
SELECT SYS_CONTEXT('USERENV', 'CON_NAME') AS pdb_name,
       SYS_CONTEXT('USERENV', 'SID') AS sid,
       USER AS schema_name,
       (SELECT MAX(version_full)
          FROM product_component_version
         WHERE product LIKE 'Oracle Database%') AS oracle_version,
       (SELECT value
          FROM v$parameter
         WHERE name = 'statistics_level') AS statistics_level,
       d.total_rows, d.customer_count, d.target_rows, i.index_columns
FROM data_summary d
CROSS JOIN index_summary i;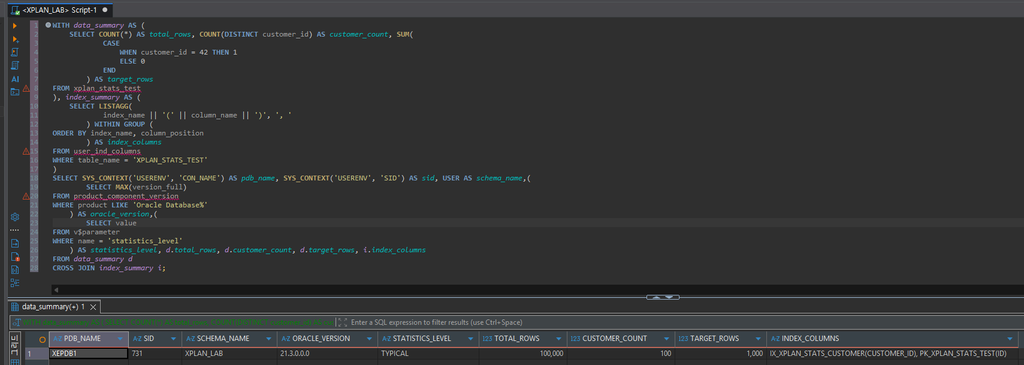
XEPDB1의 XPLAN_LAB 계정(SID 731)에서 다음 항목을 확인했습니다.
- Oracle 21.3.0.0.0
- STATISTICS_LEVEL은 TYPICAL
- 전체 100,000행, 고객 100명, 조회 대상 1,000행
- 인덱스 두 개
여기서 STATISTICS_LEVEL이 TYPICAL이라는 점이 중요합니다. 이 상태에서는 SQL 실행 단계별 통계가 기본으로 수집되지 않습니다.
첫 번째 화면: 힌트 없이 실행하고 ALLSTATS LAST로 조회
평소처럼 힌트 없이 SQL을 실행합니다. 커서를 찾기 위해 고유 주석만 붙였습니다.
sql
SELECT /* XP04_NO_STATS_V1 */
    COUNT(*) AS matched_rows,
    SUM(t.amount) AS total_amount
FROM xplan_stats_test t
WHERE t.customer_id = 42;
결과는 1,000건, 합계 493,000입니다. 생성식으로 직접 계산해도 같은 값이 나옵니다. CUSTOMER_ID 42는 LEVEL이 42, 142, 242 … 99,942인 행입니다. 이 행들의 AMOUNT는 1,000행 단위 구간마다 43, 143 … 943이 반복되어 구간당 합이 4,930입니다. 이런 구간이 100개이므로 493,000이 됩니다.
이 커서를 SQL_ID와 CHILD_NUMBER로 지정해 ALLSTATS LAST 형식으로 조회합니다.
sql
SELECT p.plan_table_output
FROM (
    SELECT sql_id, child_number
    FROM v$sql
    WHERE sql_text LIKE 'SELECT /* XP04_' || 'NO_STATS_V1 */%'
      AND parsing_schema_name = USER
      AND executions > 0
    ORDER BY last_active_time DESC, child_number DESC
    FETCH FIRST 1 ROW ONLY
) c,
TABLE(
    DBMS_XPLAN.DISPLAY_CURSOR(c.sql_id, c.child_number, 'ALLSTATS LAST')
) p;
조건 문자열을 'XP04_' || 'NO_STATS_V1'로 나눈 이유가 있습니다. 그대로 쓰면 이 조회 SQL의 본문에도 같은 문자열이 들어가 조회 SQL 자신이 검색되기 때문입니다.
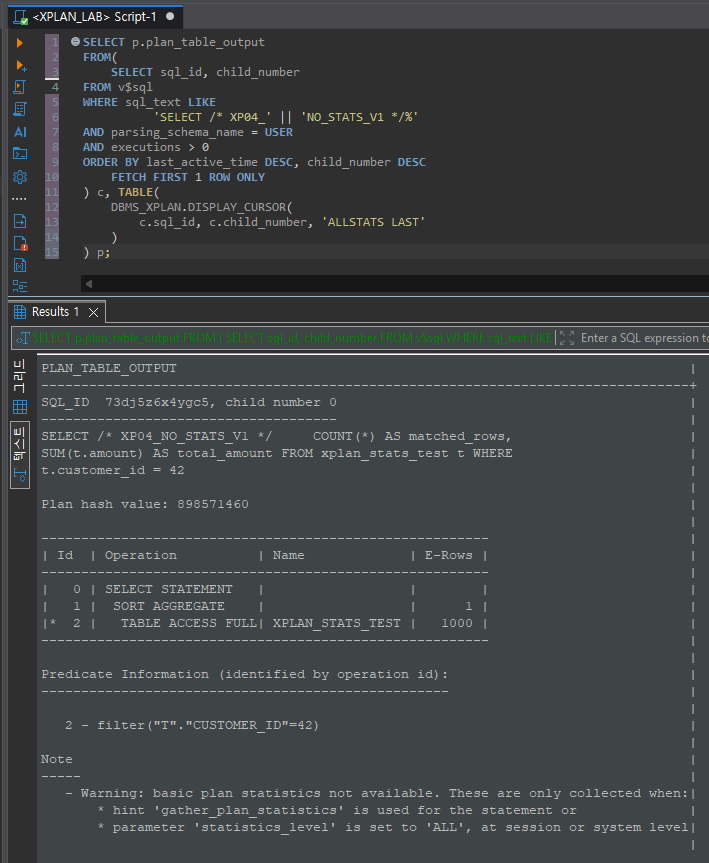
SQL_ID 73dj5z6x4ygc5의 계획이 출력되었습니다. 열은 Id, Operation, Name, E-Rows 네 개뿐입니다. TABLE ACCESS FULL의 E-Rows는 1,000입니다.
이 화면에서 가장 중요한 것은 하단의 Note입니다.
- Warning: basic plan statistics not available. These are only collected when:
    * hint 'gather_plan_statistics' is used for the statement or
    * parameter 'statistics_level' is set to 'ALL', at session or system level
Oracle이 원인과 해결 방법을 직접 알려 주고 있습니다. 실제 통계는 힌트를 쓰거나, STATISTICS_LEVEL을 ALL로 바꿨을 때만 수집됩니다. 이 경고가 보이면 출력 형식이 아니라 수집 단계의 문제입니다.
A-Rows 열이 없다고 해서 처리한 행이 0이라는 뜻은 아닙니다. 실제로는 1,000행을 반환했지만 그 사실을 기록하지 않았을 뿐입니다. 비교표에 이 값을 적는다면 0이 아니라 **”확인 불가”**로 적어야 합니다.
두 번째 화면: 힌트를 넣고 TYPICAL로 조회
이번에는 GATHER_PLAN_STATISTICS 힌트를 추가해 실행합니다.
sql
SELECT /*+ GATHER_PLAN_STATISTICS */
       /* XP04_WITH_STATS_V1 */
    COUNT(*) AS matched_rows,
    SUM(t.amount) AS total_amount
FROM xplan_stats_test t
WHERE t.customer_id = 42;
그리고 출력 형식만 TYPICAL로 지정해 조회합니다.
sql
SELECT p.plan_table_output
FROM (
    SELECT sql_id, child_number
    FROM v$sql
    WHERE sql_text LIKE 'SELECT /*+ GATHER_PLAN_STATISTICS */%'
      AND INSTR(sql_text, 'XP04_' || 'WITH_STATS_V1') > 0
      AND parsing_schema_name = USER
      AND executions > 0
    ORDER BY last_active_time DESC, child_number DESC
    FETCH FIRST 1 ROW ONLY
) c,
TABLE(
    DBMS_XPLAN.DISPLAY_CURSOR(c.sql_id, c.child_number, 'TYPICAL')
) p;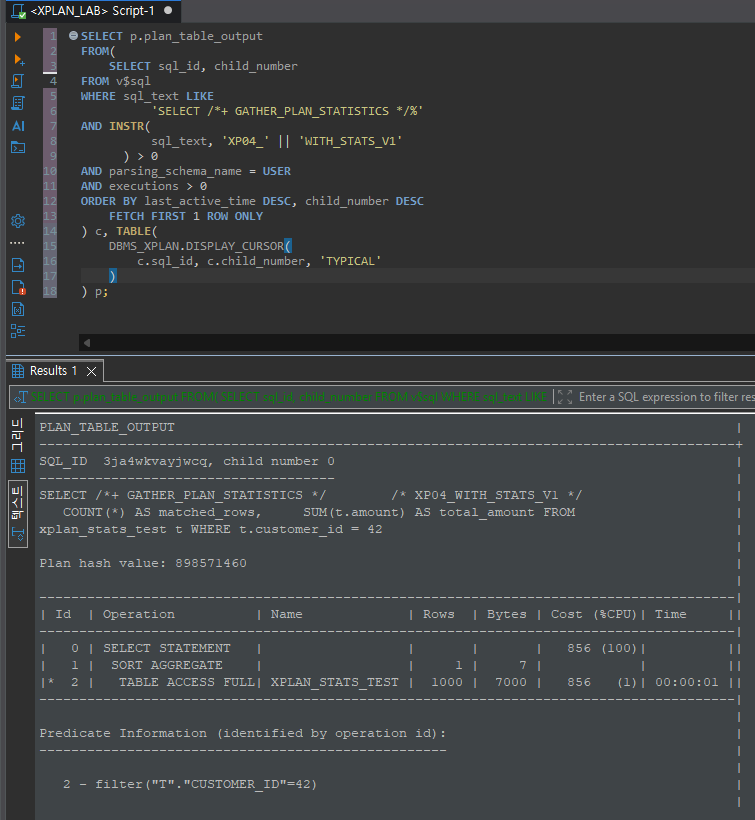
SQL_ID 3ja4wkvayjwcq, child number 0의 계획입니다. 이번에는 Rows, Bytes, Cost(%CPU), Time 열이 보입니다. TABLE ACCESS FULL은 Rows 1,000, Bytes 7,000, Cost 856입니다. 하지만 A-Rows와 Buffers는 여전히 없습니다. 첫 번째 화면과 달리 경고 Note도 없습니다.
이 화면만 보고 “힌트가 안 먹었다”고 판단하기 쉽습니다. 실제로는 통계가 수집되어 있습니다. TYPICAL은 옵티마이저의 예상치를 보여 주는 형식이라 실제 통계 열을 출력하지 않을 뿐입니다.
이름이 같아서 헷갈리는 부분도 짚고 넘어가겠습니다.
- 세션 파라미터 STATISTICS_LEVEL = TYPICAL은 무엇을 수집할지 정하는 설정입니다.
- DISPLAY_CURSOR의 **’TYPICAL’**은 무엇을 보여 줄지 정하는 출력 형식입니다.
이름만 같을 뿐 서로 관계가 없습니다.
세 번째 화면: 같은 커서를 ALLSTATS LAST로 조회
SQL을 다시 실행하지 않고, 두 번째 화면과 같은 커서의 출력 형식만 바꿉니다.
sql
SELECT p.plan_table_output
FROM (
    SELECT sql_id, child_number
    FROM v$sql
    WHERE sql_text LIKE 'SELECT /*+ GATHER_PLAN_STATISTICS */%'
      AND INSTR(sql_text, 'XP04_' || 'WITH_STATS_V1') > 0
      AND parsing_schema_name = USER
      AND executions > 0
    ORDER BY last_active_time DESC, child_number DESC
    FETCH FIRST 1 ROW ONLY
) c,
TABLE(
    DBMS_XPLAN.DISPLAY_CURSOR(c.sql_id, c.child_number, 'ALLSTATS LAST')
) p;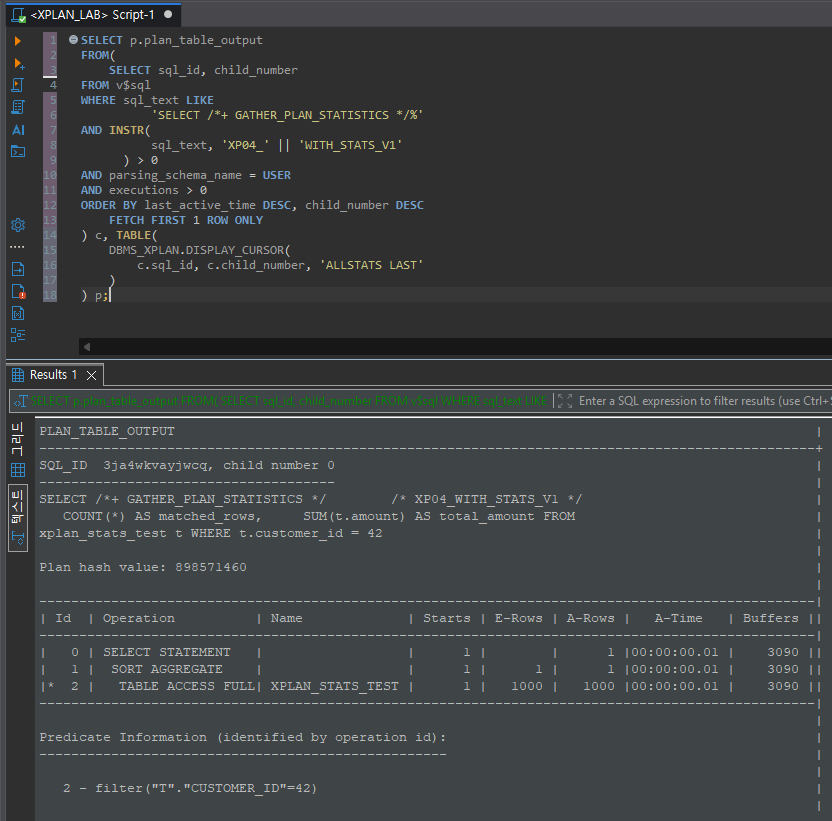
같은 SQL_ID 3ja4wkvayjwcq, child number 0인데 이번에는 Starts, E-Rows, A-Rows, A-Time, Buffers가 모두 나타났습니다. 캡처 3과 4는 같은 커서를 조회했으므로, 두 화면의 차이는 출력 형식 하나로만 설명됩니다. 통계는 두 번째 화면에서도 이미 있었던 것입니다.
| 단계 | Starts | E-Rows | A-Rows | Buffers |
|---|---|---|---|---|
| SELECT STATEMENT | 1 | (없음) | 1 | 3,090 |
| SORT AGGREGATE | 1 | 1 | 1 | 3,090 |
| TABLE ACCESS FULL | 1 | 1,000 | 1,000 | 3,090 |
A-Rows, Buffers, Reads 열을 읽는 방법
A-Rows는 단계마다 의미가 다릅니다. TABLE ACCESS FULL의 1,000은 조건을 통과해 위로 넘긴 행 수입니다. 테이블 전체 100,000행을 검사한 결과가 1,000행이라는 뜻입니다. 위쪽 SORT AGGREGATE는 이 1,000행을 COUNT와 SUM으로 묶어 1행을 반환했으므로 A-Rows가 1인 것이 정상입니다.
Buffers는 더하지 않습니다. 세 줄에 같은 3,090이 반복되는 것은 자식 단계의 값이 부모로 누적되어 표시되기 때문입니다. 9,270으로 합산하면 안 됩니다. 이 SQL의 전체 논리 읽기는 3,090입니다. 디스크에서 읽은 블록 수가 아니라 버퍼 캐시에서 블록에 접근한 횟수입니다.
Reads 열이 없는 이유: ALLSTATS에는 물리 읽기를 나타내는 Reads 열도 포함됩니다. 이 화면에 Reads가 없는 것은 마지막 실행에서 디스크 읽기가 없었기 때문으로 보입니다. DBMS_XPLAN은 값이 없는 열을 출력에서 생략합니다. 테이블 생성 직후라 블록이 이미 버퍼 캐시에 있었던 것으로 해석했습니다. 같은 SQL이라도 캐시 상태에 따라 Reads 열이 나타나기도 하고 사라지기도 합니다.
A-Time 00:00:00.01은 표시 정밀도 단위의 실행 통계입니다. DBeaver에서 체감하는 응답 시간과는 다른 값입니다.
ALLSTATS와 ALLSTATS LAST의 차이: LAST를 빼면 이 커서의 모든 실행을 누적한 통계가 나옵니다. 같은 SQL을 세 번 실행했다면 Starts는 3, Buffers는 약 9,000이 됩니다. 한 번의 실행을 분석하려면 LAST를 붙여야 합니다. 이번에는 한 번만 실행해 Starts가 1이므로 두 형식의 결과가 같았을 것입니다.
Cost를 함께 보고 싶다면 'ALLSTATS LAST +COST'처럼 수식어를 붙이면 됩니다. 예상 비용과 실제 통계를 한 화면에서 비교할 수 있습니다.
세 화면 비교: 실행계획은 같고 보이는 정보만 달랐습니다
| 비교 항목 | 화면 1: 힌트 없음 + ALLSTATS LAST | 화면 2: 힌트 + TYPICAL | 화면 3: 힌트 + ALLSTATS LAST |
|---|---|---|---|
| SQL_ID | 73dj5z6x4ygc5 | 3ja4wkvayjwcq | 3ja4wkvayjwcq |
| Plan hash value | 898571460 | 898571460 | 898571460 |
| 접근 경로 | TABLE ACCESS FULL | TABLE ACCESS FULL | TABLE ACCESS FULL |
| 테이블 단계 예상 행 수 | 1,000 | 1,000 | 1,000 |
| 테이블 단계 실제 행 수 | 수집 안 됨 | 수집됨, 출력 안 됨 | 1,000 |
| 최상위 Buffers | 수집 안 됨 | 수집됨, 출력 안 됨 | 3,090 |
| 경고 Note | 있음 | 없음 | 없음 |
이 표에서 판단에 쓸 수 있는 신호는 경고 Note의 유무입니다. A-Rows가 안 보이는데 경고가 있으면 수집 단계의 문제이고, 경고 없이 안 보이면 출력 형식의 문제일 가능성이 큽니다.
힌트를 넣자 SQL 텍스트가 바뀌어 SQL_ID도 달라졌습니다. 그런데도 Plan hash value는 같습니다. 이것은 GATHER_PLAN_STATISTICS 힌트가 실행계획을 바꾸는 힌트가 아니라는 확인이기도 합니다.
1% 조회인데 왜 인덱스를 안 탔을까
조회 대상은 전체의 1%이고 CUSTOMER_ID 인덱스도 있는데, 세 경우 모두 전체 스캔을 했습니다. 이 데이터에서는 그럴 만한 이유가 보입니다.
CUSTOMER_ID가 1~100으로 반복 적재되어 있어서, 고객 42의 행은 100행마다 하나씩 테이블 전체에 흩어져 있습니다. 인덱스를 쓰면 1,000행 각각에 대해 서로 다른 테이블 블록을 찾아가야 합니다. 게다가 SUM(AMOUNT) 때문에 테이블 접근을 피할 수도 없습니다. 반면 전체 스캔은 여러 블록을 한 번에 읽는 멀티블록 읽기로 테이블을 한 번 훑으면 됩니다. Buffers 3,090은 이 테이블을 처음부터 끝까지 읽은 작업량에 가까운 값으로 보입니다.
다만 이번 캡처에는 인덱스 경로의 비용이 없어서, 이것이 실제 선택 이유라고 확정할 수는 없습니다. USER_TABLES의 BLOCKS와 3,090을 비교해 보거나, /*+ INDEX(t ix_xplan_stats_customer) */ 힌트를 넣고 같은 방식으로 Buffers를 비교해 보면 직접 확인할 수 있습니다. 이번 글의 목적은 통계 표시 조건이므로 접근 경로는 바꾸지 않았습니다.
힌트 대신 STATISTICS_LEVEL=ALL을 쓸 때 주의할 점
애플리케이션 SQL은 텍스트를 고칠 수 없는 경우가 많습니다. 이때는 경고 메시지가 알려 준 두 번째 방법, 즉 세션의 STATISTICS_LEVEL을 ALL로 바꾸는 방법을 씁니다.
sql
ALTER SESSION SET statistics_level = ALL;

-- 대상 SQL 실행 후 DISPLAY_CURSOR(..., 'ALLSTATS LAST')로 조회

ALTER SESSION SET statistics_level = TYPICAL;
이 방법은 SQL 텍스트가 그대로이므로 SQL_ID가 바뀌지 않습니다. 하지만 CHILD_NUMBER는 바뀔 수 있습니다. 실행 통계를 수집하는 세션과 수집하지 않는 세션은 같은 커서를 공유하지 않을 수 있기 때문입니다. 그러면 Oracle이 새 자식 커서를 만듭니다. V$SQL_SHARED_CURSOR의 STATS_ROW_MISMATCH 컬럼이 이 경우를 나타냅니다.
따라서 SQL_ID만 지정하고 CHILD_NUMBER를 0으로 고정해 조회하면, 통계가 없는 기존 커서를 보고 “설정을 바꿨는데도 안 보인다”고 오해할 수 있습니다. 이번 글에서 SQL_ID와 CHILD_NUMBER를 항상 함께 조회한 이유가 이것입니다.
이미 SQL_ID와 자식 커서를 알고 있다면 직접 지정해도 됩니다. 아래 값은 이번 실험의 값입니다.
sql
SELECT *
FROM TABLE(
    DBMS_XPLAN.DISPLAY_CURSOR('3ja4wkvayjwcq', 0, 'ALLSTATS LAST')
);
DBeaver에서 SQL_ID를 생략한 DISPLAY_CURSOR(NULL, NULL, 'ALLSTATS LAST')를 쓰면 “세션의 직전 SQL”을 보여 줍니다. 그런데 DBeaver는 메타데이터 조회 같은 내부 SQL을 실행하기도 해서, 엉뚱한 커서가 나올 수 있습니다.
운영 SQL에서 실행 통계를 수집할 때
- 측정 부담이 있습니다. 실행 통계 수집은 단계마다 행 수와 시간을 기록하는 비용이 듭니다. 호출 빈도가 높은 SQL이나 시스템 전체의 STATISTICS_LEVEL을 ALL로 바꾸는 것은 피하고, 진단할 SQL과 세션으로 범위를 좁힙니다.
- 결과를 끝까지 가져와야 합니다. 많은 행을 반환하는 SELECT를 DBeaver에서 첫 페이지만 가져오면, A-Rows는 전체 실행이 아니라 가져온 만큼만 기록됩니다. 이번 실험은 집계로 결과를 한 행으로 만들어 이 문제를 피했습니다.
- 커서가 오래 남지 않을 수 있습니다. Shared Pool에서 커서가 밀려나면 DISPLAY_CURSOR로 조회할 수 없습니다. 실행 직후에 조회하고, 필요한 출력은 따로 저장해 둡니다.
- 진단이 끝나면 되돌립니다. 스크립트에 넣은 힌트는 제거하고, 세션 설정은 원래 값으로 복구합니다. 이번 환경의 원래 값은 TYPICAL이었습니다.
실습 객체 정리
sql
ALTER SESSION SET statistics_level = TYPICAL;

DROP TABLE xplan_stats_test PURGE;
테이블을 삭제하면 인덱스와 옵티마이저 통계도 함께 삭제됩니다.
A-Rows와 Buffers가 안 보일 때 인덱스를 추가하거나 DBMS_STATS로 테이블 통계를 다시 수집하는 것은 도움이 되지 않습니다. 테이블 통계는 옵티마이저의 예상치를 위한 것이고, A-Rows와 Buffers는 실행 중에 기록되는 값이기 때문입니다. 경고 Note가 있는지, 출력 형식이 ALLSTATS 계열인지, 조회한 커서가 통계를 수집한 바로 그 자식 커서인지를 이 순서로 확인하면 대부분 원인을 찾을 수 있습니다.

댓글 0
첫 댓글을 남겨보세요.