Oracle 통계를 고치자 예상 행 수는 맞았는데 Buffers는 그대로였던 이유
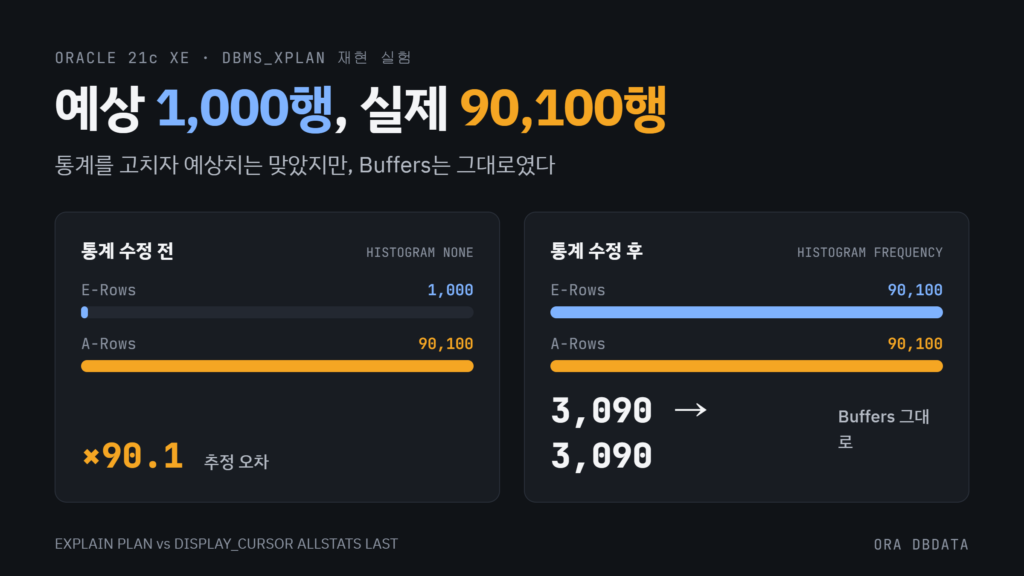
실행계획에서 Rows 1,000을 보고 “1,000행짜리 쿼리”라고 판단한 적이 있다면, 그 숫자가 어디서 나왔는지 한 번 확인해 볼 필요가 있습니다. EXPLAIN PLAN의 Rows는 실행 결과가 아닙니다. 옵티마이저가 통계를 바탕으로 계산한 예상 출력 행 수입니다.
이 차이를 직접 확인하려고 Oracle 21c XE에 10만 행 테이블을 만들었습니다. 그리고 통계를 잠근 상태에서 데이터 분포만 바꿔 보았습니다. 결과는 두 가지였습니다.
- 예상 1,000행, 실제 90,100행으로 90.1배 차이가 났습니다.
- 통계를 다시 수집하자 예상 행 수는 90,100으로 맞았습니다. 하지만 실행계획과 Buffers 3,090은 그대로였습니다.
이 글에서 더 중요하게 다루는 것은 두 번째 결과입니다. 예상치가 정확해지는 것과 SQL의 작업량이 줄어드는 것은 별개의 문제였습니다.
1. 실험 환경
| 항목 | 조건 |
|---|---|
| DB | Oracle Database 21c Express Edition (21.3.0.0.0), Windows |
| 접속 도구 | DBeaver |
| 실습 계정 | PDB 내 별도 계정 XPLAN_LAB |
| 테이블 | XPLAN_ORDERS, 100,000행, STATUS 값 100종 |
| 조회 조건 | STATUS = ‘S001’ (변경 후 90,100행, 전체의 90.1%) |
| 인덱스 | XPLAN_ORDERS_STATUS_IX (STATUS) |
| 실행 통계 | GATHER_PLAN_STATISTICS 힌트 + DISPLAY_CURSOR(‘ALLSTATS LAST’) |
각 SQL은 두 번 실행하고 마지막 실행의 통계를 확인했습니다. 병렬 쿼리와 동적 샘플링은 세션에서 끄고, Buffer Cache는 비우지 않았습니다. 로컬 환경에서 0.01초 단위의 시간 차이는 의미가 약합니다. 그래서 비교 기준은 실행 시간보다 행 수와 Buffers로 잡았습니다.
2. 재현 데이터 만들기: 건수는 그대로, 분포만 바꾸기
통계가 실제 데이터와 어긋나는 상황을 만드는 방법은 여러 가지입니다. 이번에는 전체 건수는 그대로 두고 특정 값으로 데이터를 몰아주는 방식을 택했습니다. 운영에서도 전체 건수는 비슷한데 특정 상태값만 누적되는 테이블이 흔하기 때문입니다. 이런 경우 NUM_ROWS만 보면 통계가 정상처럼 보입니다.
실습 계정과 권한
관리자 계정으로 실습 PDB에 접속해 실행합니다. USERS, TEMP 테이블스페이스가 있다고 가정했습니다.
sql
SELECT SYS_CONTEXT('USERENV', 'CON_NAME') AS pdb_name
FROM dual;

CREATE USER XPLAN_LAB
IDENTIFIED BY "XplanLab_21c_2026"
DEFAULT TABLESPACE USERS
TEMPORARY TABLESPACE TEMP
QUOTA 200M ON USERS;

GRANT CREATE SESSION, CREATE TABLE TO XPLAN_LAB;
GRANT SELECT ON SYS.V_$SQL TO XPLAN_LAB;
GRANT SELECT ON SYS.V_$SESSION TO XPLAN_LAB;
GRANT SELECT ON SYS.V_$SQL_PLAN TO XPLAN_LAB;
GRANT SELECT ON SYS.V_$SQL_PLAN_STATISTICS_ALL TO XPLAN_LAB;
GRANT SELECT ON SYS.V_$VERSION TO XPLAN_LAB;
GRANT EXECUTE ON SYS.DBMS_XPLAN TO XPLAN_LAB;
GRANT EXECUTE ON SYS.DBMS_STATS TO XPLAN_LAB;
비밀번호는 로컬 실습용 예시입니다. 이후 SQL은 모두 XPLAN_LAB 계정으로 실행합니다.
테이블 생성과 10만 행 적재
아래 블록은 기존 XPLAN_ORDERS를 삭제하고 다시 만듭니다. 실험을 반복할 때도 여기서부터 실행하면 같은 조건이 만들어집니다.
sql
ALTER SESSION SET cursor_sharing = EXACT;
ALTER SESSION SET optimizer_dynamic_sampling = 0;
ALTER SESSION DISABLE PARALLEL QUERY;

BEGIN
    EXECUTE IMMEDIATE 'DROP TABLE xplan_orders PURGE';
EXCEPTION
    WHEN OTHERS THEN
        IF SQLCODE != -942 THEN
            RAISE;
        END IF;
END;
/

CREATE TABLE xplan_orders (
    order_id NUMBER NOT NULL,
    status   VARCHAR2(4) NOT NULL,
    amount   NUMBER(10,2) NOT NULL,
    padding  VARCHAR2(200) NOT NULL
);

INSERT INTO xplan_orders (order_id, status, amount, padding)
SELECT
    LEVEL,
    'S' || TO_CHAR(MOD(LEVEL - 1, 100) + 1, 'FM000'),
    MOD(LEVEL, 1000) + 1,
    RPAD('X', 200, 'X')
FROM dual
CONNECT BY LEVEL <= 100000;

COMMIT;

CREATE INDEX xplan_orders_status_ix
ON xplan_orders(status);
DBeaver에서 PL/SQL 블록만 선택 실행할 때는 BEGIN부터 END;까지만 선택하고 마지막 /는 빼야 합니다.
STATUS는 MOD 함수로 S001~S100이 순서대로 반복되도록 넣었습니다. 처음에는 값마다 정확히 1,000행씩 고르게 분포합니다. PADDING 컬럼은 행 크기를 키워 테이블 블록 수를 현실적으로 만들기 위해 넣었습니다.
통계 수집 후 잠그고, 분포 변경
sql
BEGIN
    DBMS_STATS.GATHER_TABLE_STATS(
        ownname          => USER,
        tabname          => 'XPLAN_ORDERS',
        estimate_percent => 100,
        method_opt       => 'FOR ALL COLUMNS SIZE 1',
        cascade          => TRUE,
        degree           => 1,
        no_invalidate    => FALSE
    );

    DBMS_STATS.LOCK_TABLE_STATS(
        ownname => USER,
        tabname => 'XPLAN_ORDERS'
    );
END;
/

UPDATE xplan_orders
SET status = 'S001'
WHERE order_id <= 90000;

COMMIT;
SIZE 1은 히스토그램 없이 통계를 수집하라는 뜻입니다. 통계 잠금은 DML을 막지 않습니다. 실험 도중 자동 통계 수집 작업이 통계를 고쳐 버리지 않도록 막는 용도입니다.
UPDATE 후 S001은 ORDER_ID 1~90,000의 90,000행과, 나머지 10,000행 중 원래 S001이던 100행을 합쳐 90,100행이 됩니다.
데이터 확인
sql
SELECT
    COUNT(*) AS total_rows,
    COUNT(CASE WHEN status = 'S001' THEN 1 END) AS target_rows,
    COUNT(DISTINCT status) AS distinct_status,
    SUM(CASE WHEN status = 'S001' THEN amount ELSE 0 END) AS target_sum
FROM xplan_orders;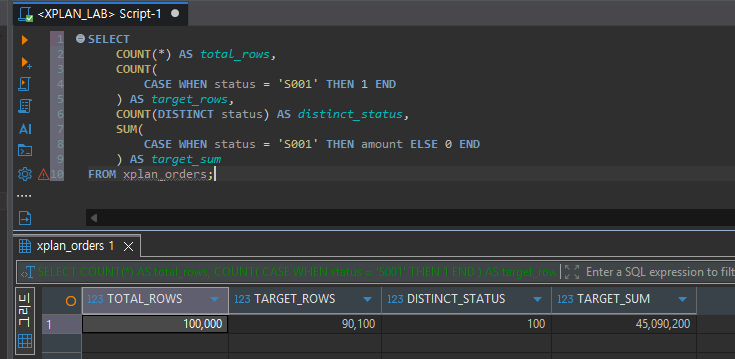
전체 100,000행 중 S001이 90,100행, STATUS 종류는 여전히 100개, S001의 AMOUNT 합계는 45,090,200입니다. 이 합계는 뒤에서 통계를 바꾼 뒤에도 결과가 같은지 검증하는 기준값으로 씁니다.
옵티마이저가 보고 있는 통계 확인
sql
SELECT
    t.table_name,
    t.num_rows,
    t.last_analyzed,
    t.stattype_locked,
    c.column_name,
    c.num_distinct,
    c.histogram,
    c.num_buckets
FROM user_tab_statistics t
JOIN user_tab_col_statistics c
  ON c.table_name = t.table_name
WHERE t.table_name = 'XPLAN_ORDERS'
  AND c.column_name = 'STATUS'
  AND t.partition_name IS NULL;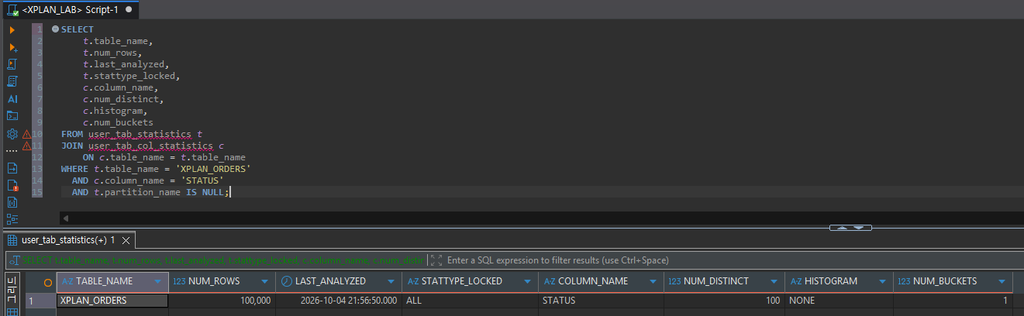
NUM_ROWS는 100,000으로 실제와 같습니다. 이 값만 보면 통계에 문제가 없어 보입니다. 하지만 STATUS 컬럼은 NUM_DISTINCT 100, HISTOGRAM NONE, NUM_BUCKETS 1입니다. 옵티마이저는 “100개 값이 고르게 분포한다”고 가정할 수밖에 없습니다.
이 가정에서 STATUS = ‘S001’의 예상 행 수는 100,000 ÷ 100 = 1,000이 됩니다. 실제로는 90,100행인데도 말입니다. LAST_ANALYZED나 NUM_ROWS만으로 통계가 최신인지 판단하면 이런 분포 변화를 놓칩니다. STATTYPE_LOCKED가 ALL인 것은 앞에서 잠근 결과입니다.
운영에서 변경량을 확인하려면 USER_TAB_STATISTICS의 STALE_STATS 컬럼을 함께 보는 것이 좋습니다. 다만 DML 모니터링 정보가 딕셔너리에 반영된 뒤에 값이 바뀌므로, 직후에는 DBMS_STATS.FLUSH_DATABASE_MONITORING_INFO 실행이 필요할 수 있습니다.
3. EXPLAIN PLAN으로 본 예상 계획
EXPLAIN PLAN은 SQL을 실행하지 않고 예상 계획만 PLAN_TABLE에 저장합니다.
sql
DELETE FROM plan_table
WHERE statement_id = 'XPLAN_BEFORE';

EXPLAIN PLAN
SET STATEMENT_ID = 'XPLAN_BEFORE'
FOR
SELECT /*+ GATHER_PLAN_STATISTICS */ /* XPLAN_LAB_BEFORE */
    COUNT(*) AS matched_rows,
    SUM(amount) AS total_amount
FROM xplan_orders
WHERE status = 'S001';

SELECT plan_table_output
FROM TABLE(
    DBMS_XPLAN.DISPLAY('PLAN_TABLE', 'XPLAN_BEFORE', 'TYPICAL')
);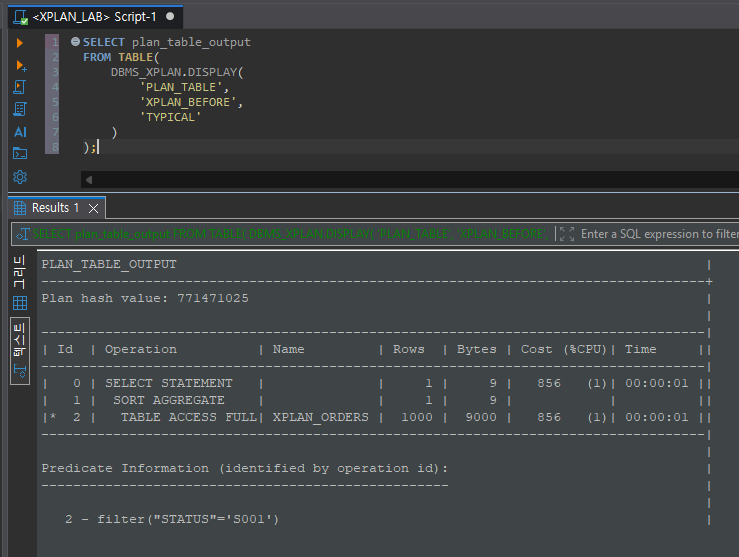
TABLE ACCESS FULL 단계의 Rows는 1,000, Bytes는 9,000, Cost는 856입니다. Plan hash value는 771471025입니다.
이 숫자를 읽을 때 자주 헷갈리는 부분을 정리하면 다음과 같습니다.
- Rows 1,000은 테이블에서 1,000행을 읽는다는 뜻이 아닙니다. 전체 스캔 단계가 필터를 적용한 뒤 내보낼 것으로 예상하는 행 수입니다. Bytes 9,000도 이 1,000행에 행당 예상 크기를 곱한 값입니다.
- Cost 856은 밀리초가 아닙니다. 접근 경로끼리 비교하기 위한 상대적인 비용입니다. Time 열의 00:00:01도 측정값이 아닙니다.
- EXPLAIN PLAN에 GATHER_PLAN_STATISTICS 힌트를 넣어도, 실행하지 않았으니 실제 통계는 생기지 않습니다.
이번 실험에서는 EXPLAIN PLAN의 Plan hash value와 실제 실행 커서의 값이 같았습니다. 하지만 항상 같다는 보장은 없습니다. EXPLAIN PLAN은 바인드 변수 값을 엿보지(bind peeking) 않습니다. 세션 파라미터가 실제 애플리케이션과 다를 수도 있습니다. 그리고 적응형 계획(Adaptive Plan)이 실행 중 바뀐 결과도 반영하지 않습니다. 느린 SQL을 분석할 때 실제 커서를 봐야 하는 이유가 여기에 있습니다.
4. 실제 실행 후 E-Rows와 A-Rows 비교
실행 통계를 수집하면서 SQL 실행
아래 SELECT를 두 번 실행합니다.
sql
SELECT /*+ GATHER_PLAN_STATISTICS */ /* XPLAN_LAB_BEFORE */
    COUNT(*) AS matched_rows,
    SUM(amount) AS total_amount
FROM xplan_orders
WHERE status = 'S001';
COUNT와 SUM으로 결과를 한 행으로 만든 데는 이유가 있습니다. DBeaver는 결과를 일정 건수만 먼저 가져옵니다. 상세 행을 조회하면 커서가 끝까지 실행되지 않은 상태의 통계를 보게 될 수 있습니다. 집계 결과 한 행이면 이 문제를 피할 수 있습니다.
힌트를 SQL마다 넣기 어렵다면 ALTER SESSION SET statistics_level = ALL;로 세션 전체의 실행 통계를 수집할 수도 있습니다. 다만 오버헤드가 있으므로 분석용 세션에서만 사용합니다.
대상 커서를 지정해서 실제 계획 조회
sql
SELECT p.plan_table_output
FROM v$sql s,
     TABLE(
         DBMS_XPLAN.DISPLAY_CURSOR(
             s.sql_id,
             s.child_number,
             'ALLSTATS LAST +PREDICATE'
         )
     ) p
WHERE s.parsing_schema_name = USER
  AND s.executions > 0
  AND s.sql_text LIKE 'SELECT /*+ GATHER_PLAN_STATISTICS */%'
  AND INSTR(s.sql_text, 'XPLAN_LAB_' || 'BEFORE') > 0;
조건을 'XPLAN_LAB_' || 'BEFORE'로 나눠 쓴 것은 의도한 것입니다. 'XPLAN_LAB_BEFORE'라고 그대로 쓰면 이 조회 SQL의 본문에도 같은 문자열이 들어가, V$SQL에서 조회 SQL 자기 자신도 검색됩니다. 문자열을 나눠 두면 대상 SQL만 찾을 수 있습니다.
DISPLAY_CURSOR를 인수 없이 호출하면 세션의 직전 SQL을 보여 줍니다. DBeaver처럼 도구가 내부 SQL을 실행하는 환경에서는 엉뚱한 커서가 나올 수 있어서, SQL_ID와 CHILD_NUMBER를 직접 넘겼습니다.
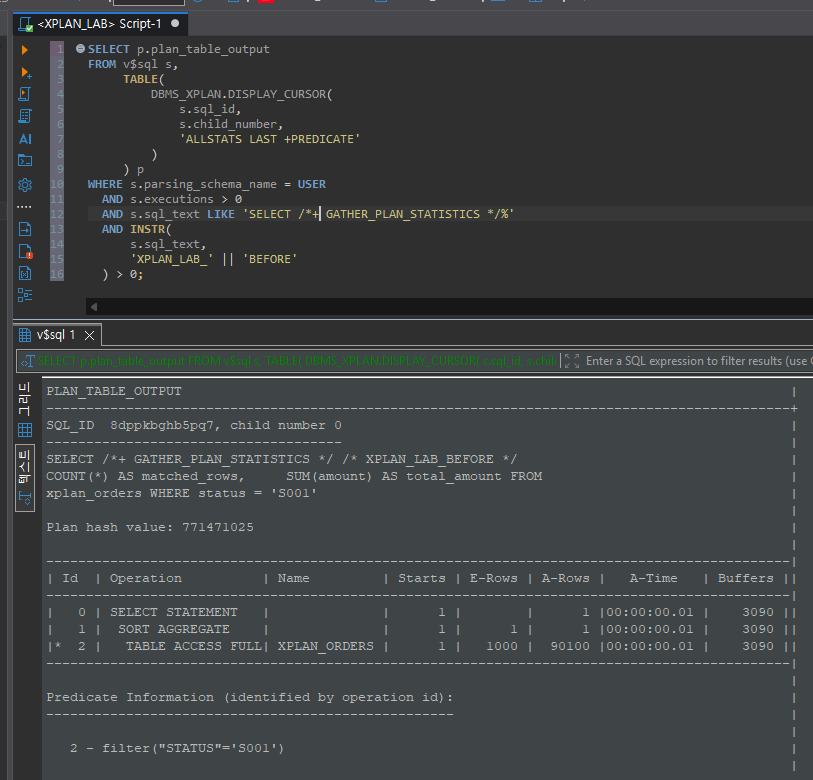
TABLE ACCESS FULL 단계에서 E-Rows는 1,000, A-Rows는 90,100입니다. Starts는 1, Buffers는 3,090입니다.
이 결과를 읽는 방법
오차 비율: 90,100 ÷ 1,000 = 90.1배입니다. 예상보다 90.1배 많은 행이 이 단계에서 나왔다는 뜻이지, 90.1배 느렸다는 뜻은 아닙니다.
최상위 A-Rows가 1인 이유: SORT AGGREGATE와 SELECT STATEMENT는 집계 결과 한 행을 반환하므로 A-Rows가 1입니다. 추정 오차는 최상위가 아니라 그 아래 TABLE ACCESS FULL 단계에서 확인해야 합니다.
A-Rows는 검사한 행 수가 아닙니다: 전체 스캔은 100,000행을 모두 검사했지만, 필터를 통과해 위로 올라간 행이 90,100입니다.
Starts가 1보다 크면 곱해서 비교합니다: E-Rows는 1회 실행당 예상치이고, A-Rows는 모든 실행의 누적값입니다. 예를 들어 Nested Loop 안쪽 연산의 Starts가 500이라면 E-Rows × 500과 A-Rows를 비교해야 합니다. 이번에는 Starts가 1이라 그대로 비교할 수 있습니다.
Buffers는 누적값입니다: 세 줄 모두 3,090으로 표시된 것은 자식 연산의 값이 부모로 누적되기 때문입니다. 세 줄을 더해 9,270으로 계산하면 안 됩니다. 또한 3,090은 논리적 블록 접근 횟수이며, 디스크에서 읽은 블록 수와는 다릅니다.
5. 통계 재수집 후 다시 실행
STATUS 히스토그램을 포함해 재수집
데이터와 인덱스는 그대로 두고 통계만 다시 수집합니다.
sql
BEGIN
    DBMS_STATS.UNLOCK_TABLE_STATS(
        ownname => USER,
        tabname => 'XPLAN_ORDERS'
    );

    DBMS_STATS.GATHER_TABLE_STATS(
        ownname          => USER,
        tabname          => 'XPLAN_ORDERS',
        estimate_percent => 100,
        method_opt       =>
            'FOR ALL COLUMNS SIZE 1 FOR COLUMNS SIZE 254 status',
        cascade          => TRUE,
        degree           => 1,
        no_invalidate    => FALSE
    );
END;
/
STATUS에만 최대 254개 버킷의 히스토그램을 허용했습니다. 이 단계는 테이블, 컬럼, 인덱스 통계를 모두 다시 수집하므로 “히스토그램 하나만 바꾼 실험”은 아닙니다.
같은 SQL을 주석만 바꿔 실행
sql
SELECT /*+ GATHER_PLAN_STATISTICS */ /* XPLAN_LAB_AFTER */
    COUNT(*) AS matched_rows,
    SUM(amount) AS total_amount
FROM xplan_orders
WHERE status = 'S001';
주석을 바꾸면 SQL 텍스트가 달라져 새 커서가 만들어지므로 변경 전 커서와 구분할 수 있습니다. 두 번 실행한 뒤 실제 계획을 조회합니다.
sql
SELECT p.plan_table_output
FROM v$sql s,
     TABLE(
         DBMS_XPLAN.DISPLAY_CURSOR(
             s.sql_id,
             s.child_number,
             'ALLSTATS LAST +PREDICATE'
         )
     ) p
WHERE s.parsing_schema_name = USER
  AND s.executions > 0
  AND s.sql_text LIKE 'SELECT /*+ GATHER_PLAN_STATISTICS */%'
  AND INSTR(s.sql_text, 'XPLAN_LAB_' || 'AFTER') > 0;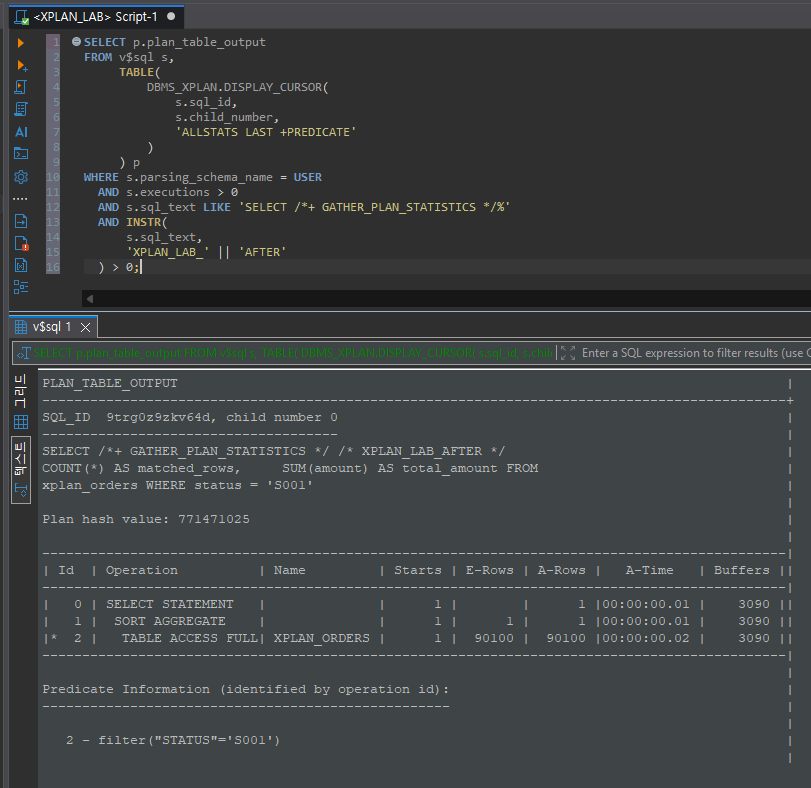
E-Rows와 A-Rows가 모두 90,100으로 일치합니다. 하지만 접근 방식은 여전히 TABLE ACCESS FULL, Plan hash value는 771471025, Buffers는 3,090으로 변경 전과 같습니다.
결과와 히스토그램 확인
sql
SELECT
    COUNT(*) AS matched_rows,
    SUM(amount) AS total_amount
FROM xplan_orders
WHERE status = 'S001';

SELECT
    table_name,
    column_name,
    num_distinct,
    histogram,
    num_buckets,
    last_analyzed
FROM user_tab_col_statistics
WHERE table_name = 'XPLAN_ORDERS'
  AND column_name = 'STATUS';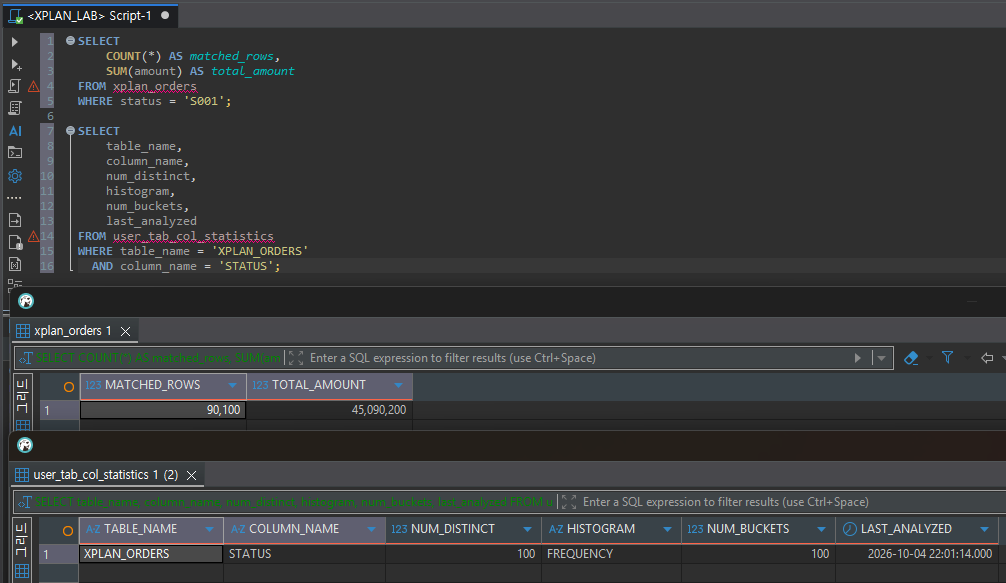
조회 건수 90,100과 합계 45,090,200은 변경 전과 같습니다. 통계 변경이 결과에는 영향을 주지 않았다는 확인입니다.
STATUS 히스토그램은 FREQUENCY, NUM_BUCKETS는 100입니다. 고유값이 100개로 허용 버킷 254개보다 적기 때문에, 값마다 버킷 하나를 쓰는 빈도 히스토그램이 만들어졌습니다. 이제 옵티마이저는 S001이 전체의 90.1%라는 사실을 알고 있습니다.
6. 전후 비교: 정확해진 것은 예상치뿐이었습니다
| 비교 항목 | 통계 수정 전 | 통계 수정 후 |
|---|---|---|
| STATUS 히스토그램 | NONE | FREQUENCY |
| TABLE ACCESS FULL의 Starts | 1 | 1 |
| TABLE ACCESS FULL의 E-Rows | 1,000 | 90,100 |
| TABLE ACCESS FULL의 A-Rows | 90,100 | 90,100 |
| 실제 ÷ 예상 | 90.1배 | 1배 |
| 접근 방식 | TABLE ACCESS FULL | TABLE ACCESS FULL |
| Plan hash value | 771471025 | 771471025 |
| Buffers | 3,090 | 3,090 |
| 집계 결과 | 90,100 / 45,090,200 | 90,100 / 45,090,200 |
통계 재수집으로 얻은 것은 카디널리티 추정의 정확도입니다. 블록 접근량이나 실행 시간은 줄지 않았습니다. 수정 후 캡처에서 TABLE ACCESS FULL의 A-Time이 0.02초로 표시되지만, 0.01초 단위의 단일 실행 값으로 느려졌다고 볼 근거는 없습니다.
“통계를 갱신했더니 실행계획이 정확해졌다”는 말은 맞지만, “그래서 SQL이 빨라졌다”는 별도로 검증해야 하는 주장이라는 것을 이 결과가 보여 줍니다.
인덱스가 있는데 왜 수정 전에도 전체 스캔을 했을까요?
수정 후 전체 스캔은 자연스럽습니다. 90.1%의 행을 집계하는데 인덱스를 거쳐 테이블 블록을 반복해서 찾아가는 것보다, 테이블을 한 번 쭉 읽는 편이 유리합니다.
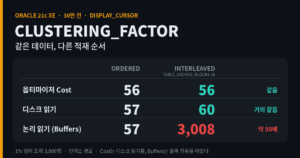
흥미로운 것은 수정 전입니다. 옵티마이저는 1,000행, 즉 1%만 읽으면 된다고 예상했는데도 인덱스를 쓰지 않았습니다. 제가 추정하는 이유는 데이터 배치입니다. 초기 적재 때 STATUS를 S001~S100 순서로 반복해서 넣었기 때문에, 같은 STATUS의 행이 테이블의 거의 모든 블록에 흩어져 있습니다. 이런 경우 인덱스의 클러스터링 팩터가 높아져, 1,000행이라도 테이블 블록 접근 비용이 크게 계산될 수 있습니다. 또한 SUM(AMOUNT) 때문에 인덱스만으로는 답을 낼 수 없어 테이블 접근이 반드시 필요합니다.
다만 이번 캡처에는 클러스터링 팩터와 인덱스 경로의 비용이 없어 이것이 원인이라고 확정할 수는 없습니다. 직접 확인하고 싶다면 아래 SQL로 클러스터링 팩터를 테이블 블록 수, 행 수와 비교해 보면 됩니다. 클러스터링 팩터가 행 수에 가까울수록 데이터가 인덱스 순서와 무관하게 흩어져 있다는 뜻입니다.
sql
SELECT i.index_name,
       i.clustering_factor,
       t.blocks,
       t.num_rows
FROM user_indexes i
JOIN user_tables t
  ON t.table_name = i.table_name
WHERE i.table_name = 'XPLAN_ORDERS';
7. 90배 오차가 문제 되지 않은 이유, 그리고 문제가 되는 경우
이번 실험에서 추정 오차가 90배였는데도 성능에 영향이 없었던 이유는 단순합니다. 단일 테이블 집계라서, 예상 행 수가 무엇이든 옵티마이저가 고를 합리적인 경로가 전체 스캔 하나뿐이었기 때문입니다. 잘못된 예상치를 바탕으로 결정할 다음 단계가 없었던 것입니다.
추정 오차가 실제 장애로 이어지는 것은 그 숫자가 부모 연산의 선택에 쓰일 때입니다.
- 조인 방식: 이 테이블을 주문 상세 테이블과 조인한다고 가정해 보겠습니다. 옵티마이저가 S001을 1,000행으로 믿으면, 1,000번 인덱스를 찾아가는 Nested Loop를 선택하기 쉽습니다. 실제로는 90,100번 반복하게 됩니다. 이 상황이라면 Hash Join이 더 나은 선택이었을 수 있습니다.
- 조인 순서: 작은 집합이라고 잘못 판단한 테이블이 드라이빙 테이블이 되면, 이후 모든 조인 단계의 반복 횟수가 커집니다.
- 메모리 할당: 정렬이나 해시 작업 영역을 작은 데이터 기준으로 잡으면 TEMP 사용이 늘 수 있습니다.
그래서 실행계획에서 E-Rows와 A-Rows의 차이를 발견했다면, 다음 질문은 “그 오차 때문에 위쪽 연산의 선택이 달라졌는가”입니다. 이번 실험은 그 답이 “아니오”였던 경우입니다. 위의 조인 시나리오는 이번에 측정한 결과가 아니며, 다음 실험에서 직접 재현해 볼 주제입니다.
8. 운영에서 통계를 건드리기 전에
이번 실험은 100% 수집과 즉시 커서 무효화(no_invalidate => FALSE)를 사용했습니다. 실습 테이블에서는 문제가 없지만, 운영 테이블에 그대로 적용하면 수집 시간이 길어지고 해당 테이블을 쓰는 다른 SQL의 계획이 한꺼번에 바뀔 수 있습니다.
운영에서 통계를 변경할 때는 다음을 먼저 준비합니다.
- DBMS_STATS.EXPORT_TABLE_STATS로 기존 통계를 별도 통계 테이블에 보관하고, 문제가 생기면 IMPORT_TABLE_STATS로 되돌립니다.
- 원래 통계 잠금 여부와 테이블별 수집 설정(DBMS_STATS.GET_PREFS)을 기록해 둡니다.
- 히스토그램은 모든 컬럼에 만들지 않고, 추정 오차가 확인된 컬럼부터 검토합니다.
- 이번 실험은 리터럴 조건이었습니다. 바인드 변수를 쓰는 SQL은 첫 실행 때의 바인드 값과 Adaptive Cursor Sharing 동작에 따라 결과가 달라질 수 있으므로 별도로 확인합니다.
9. 실습 객체 정리
XPLAN_LAB 계정에서 실행합니다.
sql
DROP TABLE xplan_orders PURGE;

DELETE FROM plan_table
WHERE statement_id = 'XPLAN_BEFORE';

COMMIT;
테이블을 삭제하면 인덱스와 통계도 함께 삭제됩니다. ALTER SESSION으로 바꾼 설정은 연결을 끊으면 사라집니다. 실습 계정까지 지우려면 관리자 계정에서 DROP USER XPLAN_LAB CASCADE;를 실행합니다.
10. 이 실험 이후 실행계획을 읽는 순서
이번 실험을 하면서 실행계획을 보는 순서를 다음처럼 정리했습니다.
- EXPLAIN PLAN이 아니라 실제 커서를 봅니다. GATHER_PLAN_STATISTICS나 statistics_level = ALL로 실행한 뒤, SQL_ID와 CHILD_NUMBER를 지정해 DISPLAY_CURSOR로 확인합니다.
- Starts를 먼저 봅니다. 1보다 크면 E-Rows × Starts와 A-Rows를 비교합니다.
- 오차가 처음 벌어지는 가장 안쪽 연산을 찾습니다. 최상위 결과 행 수가 아니라, 오차가 시작된 지점이 원인에 가깝습니다.
- 그 오차가 위쪽 연산의 선택을 바꿨는지 판단합니다. 조인 방식, 조인 순서, 접근 경로가 영향을 받았다면 통계 보정을 검토하고, 이번처럼 영향이 없다면 다른 원인을 찾습니다.
- 수정 후에는 Buffers로 작업량을 다시 비교합니다. E-Rows가 맞아졌다는 것과 SQL이 가벼워졌다는 것은 따로 확인해야 합니다.
이번 실험에서 1~4단계까지는 “통계 문제”라는 답이 나왔지만, 5단계에서 Buffers가 그대로였습니다. 통계를 고친 것은 옵티마이저의 판단 근거를 바로잡은 것이지, 이 SQL이 해야 하는 일의 양을 줄인 것은 아니었습니다.

댓글 0
첫 댓글을 남겨보세요.