DELETE로 90%를 지웠는데 FULL SCAN은 왜 6,069블록을 그대로 읽을까: HWM과 SHRINK·MOVE 비교
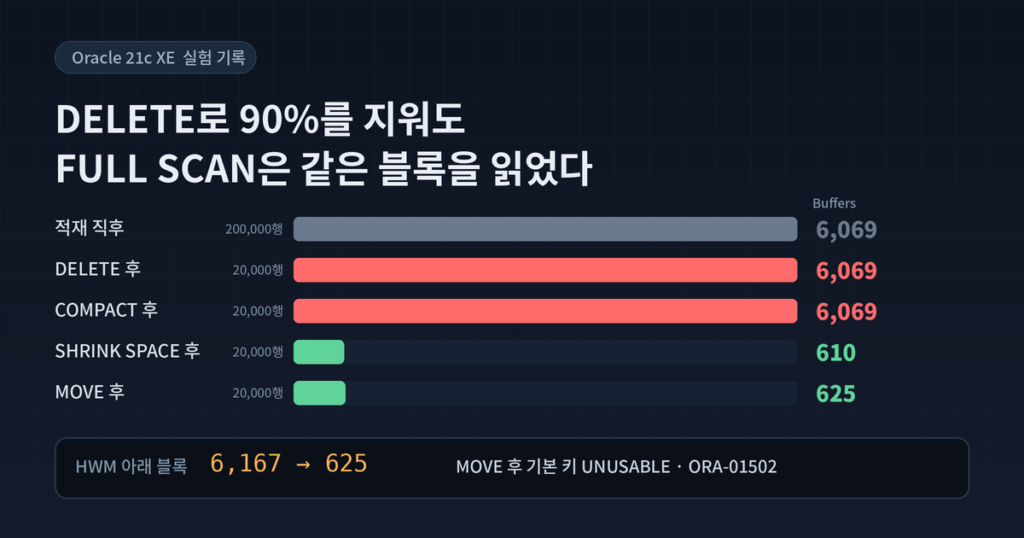
20만 건일 때도 2만 건일 때도 FULL SCAN은 6,069블록을 읽었습니다
로그인 이력 200,000건을 FULL SCAN했을 때 Buffers는 6,069였습니다. 보관 기간이 지난 180,000건을 DELETE하고 COMMIT한 뒤 같은 SQL을 다시 실행했습니다. 반환된 행은 20,000건으로 줄었지만 Buffers는 6,069로 한 블록도 줄지 않았습니다.
FULL SCAN은 세그먼트의 HWM(High Water Mark) 아래 블록을 모두 읽습니다. DELETE는 블록 안의 행을 지울 뿐 HWM을 내리지 않습니다. 여기까지는 잘 알려진 설명입니다. 이 실험에서는 그 다음을 숫자로 확인했습니다. SHRINK SPACE COMPACT, SHRINK SPACE, MOVE 중 어느 단계에서 HWM 아래 블록과 Buffers가 실제로 줄어드는지, 그리고 각 방법이 ROWID와 인덱스에 무엇을 남기는지입니다.
모든 결과는 Oracle 21c XE에서 직접 실행하고 캡처한 값입니다. 데이터는 블로그 테스트용 가상 시나리오인 로그인 이력 정리로 만들었습니다.
실험 조건: 같은 데이터를 담은 두 테이블
테스트는 PDB(XEPDB1)에 만든 전용 사용자 HWM_LAB으로 진행했고, 클라이언트는 DBeaver입니다. SHRINK SPACE는 ASSM(자동 세그먼트 공간 관리) 테이블스페이스에서만 동작하므로, 환경 확인 단계에서 USERS 테이블스페이스의 공간 관리 방식도 함께 조회했습니다.
SELECT
    (SELECT banner_full FROM v$version WHERE ROWNUM = 1)          AS db_version,
    SYS_CONTEXT('USERENV', 'CON_NAME')                             AS con_name,
    SYS_CONTEXT('USERENV', 'SESSION_USER')                         AS session_user,
    SYS_CONTEXT('USERENV', 'CURRENT_SCHEMA')                       AS current_schema,
    (SELECT value FROM v$parameter WHERE name = 'db_block_size')   AS db_block_size,
    (SELECT segment_space_management FROM user_tablespaces
      WHERE tablespace_name = 'USERS')                             AS users_ssm
FROM dual;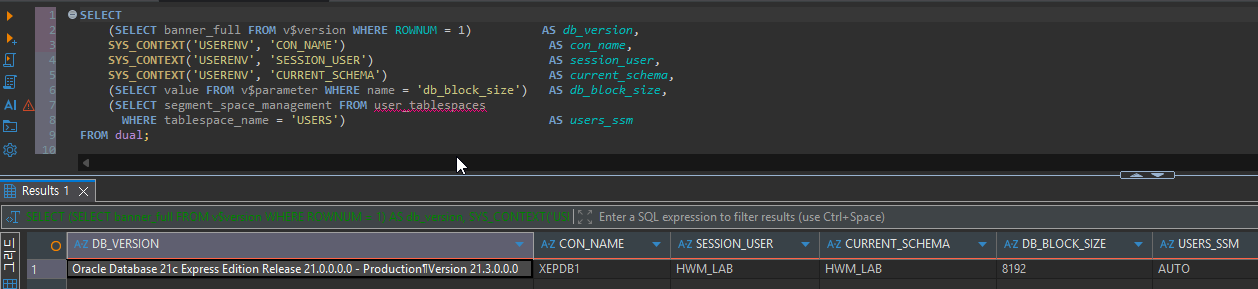
space_log 생성에서 ORA-01031이 난 이유
단계별 공간 측정값을 쌓을 SPACE_LOG 테이블을 만들다가 권한 오류가 발생했습니다.
SQL Error [1031] [42000]: ORA-01031: 권한이 불충분합니다원인 후보는 두 가지였습니다. 하나는 DBeaver의 활성 스키마가 다른 스키마로 잡혀 SESSION_USER와 CURRENT_SCHEMA가 어긋난 경우이고, 다른 하나는 테이블 정의에 넣은 GENERATED ALWAYS AS IDENTITY 컬럼이었습니다. 활성 스키마는 HWM_LAB으로 정상이었고, session_privs를 조회하자 CREATE PROCEDURE, CREATE SESSION, CREATE TABLE, SELECT ANY DICTIONARY만 있었습니다. IDENTITY 컬럼은 내부적으로 시퀀스를 함께 만들기 때문에 CREATE SEQUENCE 권한이 필요한데, 이 권한이 빠져 있었습니다. SYSTEM에서 권한을 추가한 뒤 같은 CREATE TABLE이 정상 실행되었습니다. 시스템 권한이라 재접속은 필요하지 않았습니다.
-- SYSTEM 계정, XEPDB1 (최종적으로 필요한 권한)
CREATE USER hwm_lab IDENTIFIED BY "HwmLab#2026"
    DEFAULT TABLESPACE users
    QUOTA 500M ON users;

GRANT CREATE SESSION, CREATE TABLE, CREATE SEQUENCE, CREATE PROCEDURE TO hwm_lab;
GRANT SELECT ANY DICTIONARY TO hwm_lab;   -- DISPLAY_CURSOR, DBA_EXTENTS 조회용
데이터 설계와 측정 방법
구조와 데이터가 똑같은 LOGIN_HIST_A와 LOGIN_HIST_B를 만들고 각각 200,000건을 넣었습니다. 하루 1,000건씩 200일 분량을 날짜 순서로 적재했기 때문에, 오래된 행은 세그먼트 앞쪽 블록에, 최근 행은 뒤쪽 블록에 놓입니다. 이후 두 테이블에서 같은 조건으로 앞쪽 180일(180,000건)을 지우고, A에는 SHRINK를, B에는 MOVE를 적용했습니다. 데이터 규모는 블록 수가 수천 개 단위가 되어 삭제 전후 차이가 분명하면서, XE에서 적재와 정리가 몇십 초 안에 끝나는 200,000건으로 정했습니다.
CREATE TABLE login_hist_a (
    login_id    NUMBER(10)    NOT NULL,
    member_id   NUMBER(10)    NOT NULL,
    login_dt    DATE          NOT NULL,
    client_ip   VARCHAR2(15)  NOT NULL,
    user_agent  VARCHAR2(200) NOT NULL,
    CONSTRAINT login_hist_a_pk PRIMARY KEY (login_id)
);
-- LOGIN_HIST_B도 이름만 바꿔 같은 구조로 생성

INSERT /*+ APPEND */ INTO login_hist_a
SELECT LEVEL,
       MOD(LEVEL, 5000) + 1,
       DATE '2026-01-01' + TRUNC((LEVEL - 1) / 1000),
       '10.0.' || MOD(LEVEL, 256) || '.' || MOD(LEVEL, 251),
       RPAD('Mozilla/5.0 lab-agent ' || MOD(LEVEL, 50), 180, 'x')
FROM dual
CONNECT BY LEVEL <= 200000;

COMMIT;   -- APPEND 적재 직후 COMMIT (ORA-12838 방지)
공간은 DBMS_SPACE로 측정했습니다. UNUSED_SPACE로 세그먼트 전체 블록과 HWM 위의 미사용 블록을, SPACE_USAGE로 HWM 아래 블록의 여유 공간 분포(FS1~FS4, FULL)를 구해 SPACE_LOG에 쌓는 프로시저를 만들었습니다. FS4는 여유 공간이 75~100%인 블록, FULL은 더 넣을 공간이 없는 블록입니다.
CREATE OR REPLACE PROCEDURE log_space (p_step IN VARCHAR2, p_table IN VARCHAR2) IS
    l_total_blocks NUMBER; l_total_bytes NUMBER;
    l_unused_blocks NUMBER; l_unused_bytes NUMBER;
    l_lue_file NUMBER; l_lue_block NUMBER; l_last_used_block NUMBER;
    l_unf_b NUMBER; l_unf_by NUMBER;
    l_fs1_b NUMBER; l_fs1_by NUMBER; l_fs2_b NUMBER; l_fs2_by NUMBER;
    l_fs3_b NUMBER; l_fs3_by NUMBER; l_fs4_b NUMBER; l_fs4_by NUMBER;
    l_full_b NUMBER; l_full_by NUMBER;
BEGIN
    DBMS_SPACE.UNUSED_SPACE(
        segment_owner => USER, segment_name => UPPER(p_table), segment_type => 'TABLE',
        total_blocks => l_total_blocks, total_bytes => l_total_bytes,
        unused_blocks => l_unused_blocks, unused_bytes => l_unused_bytes,
        last_used_extent_file_id => l_lue_file,
        last_used_extent_block_id => l_lue_block,
        last_used_block => l_last_used_block);

    DBMS_SPACE.SPACE_USAGE(
        segment_owner => USER, segment_name => UPPER(p_table), segment_type => 'TABLE',
        unformatted_blocks => l_unf_b, unformatted_bytes => l_unf_by,
        fs1_blocks => l_fs1_b, fs1_bytes => l_fs1_by,
        fs2_blocks => l_fs2_b, fs2_bytes => l_fs2_by,
        fs3_blocks => l_fs3_b, fs3_bytes => l_fs3_by,
        fs4_blocks => l_fs4_b, fs4_bytes => l_fs4_by,
        full_blocks => l_full_b, full_bytes => l_full_by);

    INSERT INTO space_log (step, table_name, seg_blocks, below_hwm_blocks, unused_blocks,
                           unformatted_blocks, fs1_blocks, fs2_blocks, fs3_blocks,
                           fs4_blocks, full_blocks)
    VALUES (p_step, UPPER(p_table), l_total_blocks, l_total_blocks - l_unused_blocks,
            l_unused_blocks, l_unf_b, l_fs1_b, l_fs2_b, l_fs3_b, l_fs4_b, l_full_b);
    COMMIT;
END;
FULL SCAN은 아래 SQL로 측정했습니다. 기본 키가 있으면 COUNT(*)를 인덱스로 처리할 수 있으므로 FULL(t) 힌트로 테이블 스캔을 고정했습니다. 실행 통계는 DBMS_XPLAN.DISPLAY_CURSOR의 ALLSTATS LAST로 조회했고, 단계마다 태그 리터럴만 바꿨습니다.
SELECT /*+ FULL(t) GATHER_PLAN_STATISTICS */ 'S1A' AS tag, COUNT(*) AS cnt
FROM login_hist_a t;

SELECT p.plan_table_output
FROM v$sql s,
     TABLE(DBMS_XPLAN.DISPLAY_CURSOR(s.sql_id, s.child_number, 'ALLSTATS LAST')) p
WHERE s.sql_text LIKE '%''S1A''%'
  AND s.sql_text NOT LIKE '%v$sql%';
DELETE는 블록을 비웠지만 HWM은 그대로였습니다
DELETE FROM login_hist_a WHERE login_dt < DATE '2026-01-01' + 180;
DELETE FROM login_hist_b WHERE login_dt < DATE '2026-01-01' + 180;
COMMIT;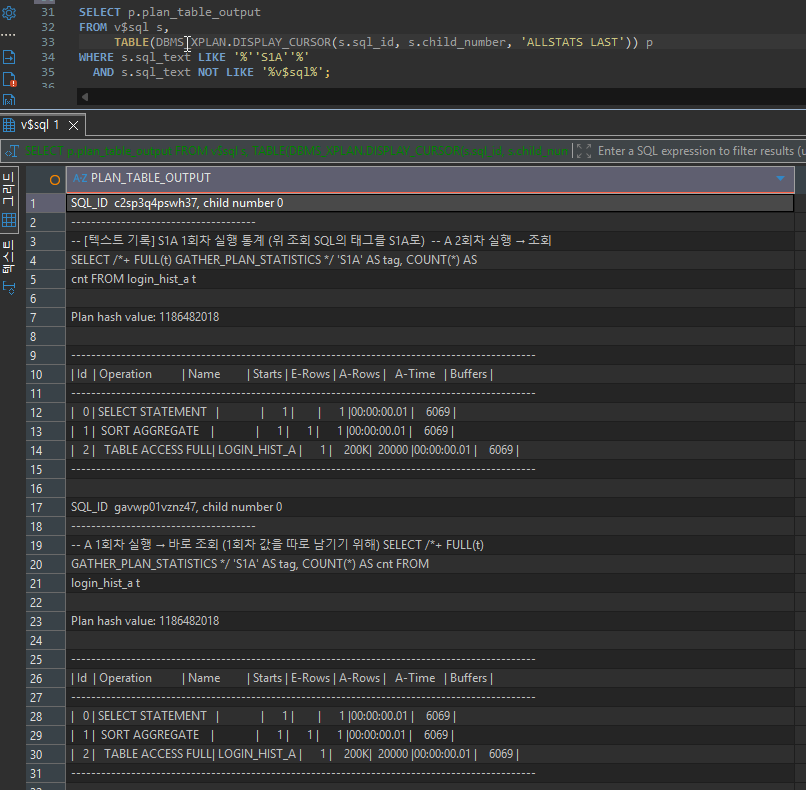
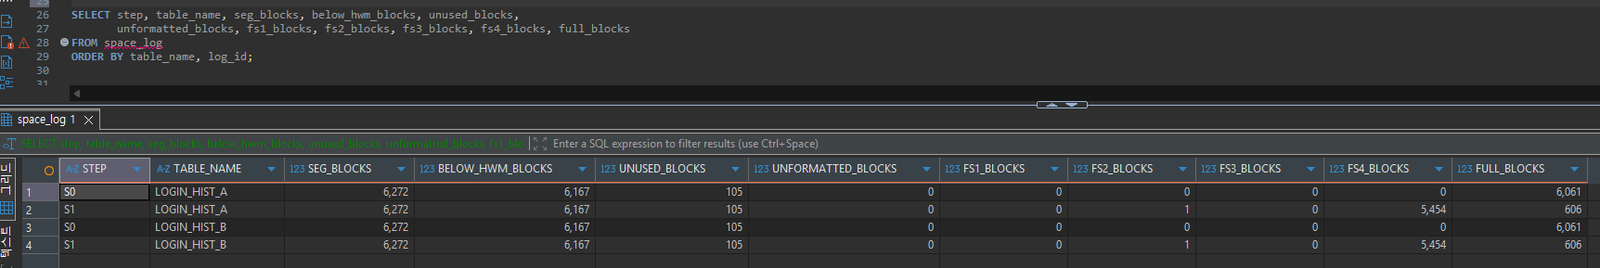
| LOGIN_HIST_A | seg_blocks | below_hwm | fs4 | full |
|---|---|---|---|---|
| S0 적재 직후 | 6,272 | 6,167 | 0 | 6,061 |
| S1 DELETE 후 | 6,272 | 6,167 | 5,454 | 606 |
DELETE는 블록의 상태만 바꿨습니다. 가득 찬 블록 대부분이 거의 빈 블록(FS4)이 되었지만, 그 블록들은 여전히 HWM 아래에 있습니다. LOGIN_HIST_B도 같은 값이었습니다.
| FULL SCAN | A-Rows | Buffers | Reads |
|---|---|---|---|
| S0A 적재 직후 | 200,000 | 6,069 | 6,061 |
| S1A DELETE 후 1회차 | 20,000 | 6,069 | 표시 없음 |
| S1A DELETE 후 2회차 | 20,000 | 6,069 | 표시 없음 |
반환 행은 10분의 1이 되었는데 읽은 블록 수는 같았습니다. FULL SCAN이 행이 아니라 HWM 아래의 블록 단위로 일하기 때문입니다. SPACE_USAGE가 집계한 데이터 블록은 6,061개이고, HWM 아래 6,167블록과의 차이는 세그먼트 헤더와 공간 관리용 비트맵 블록으로 보입니다(추정).
삭제 직후에는 지연 블록 클린아웃 때문에 1회차 Buffers가 더 클 수 있다고 예상했지만, 1회차와 2회차는 A와 B 모두 6,069로 같았습니다. 이번 조건에서는 그 차이가 Buffers로 드러나지 않았습니다. 적재 직후 첫 스캔에서만 Reads가 6,061로 표시된 것은 APPEND 적재가 버퍼 캐시를 거치지 않고 기록되었기 때문으로 보이며(추정), DELETE가 블록을 캐시에 올린 뒤의 스캔에는 Reads가 나타나지 않았습니다.
캡처에 커서가 두 개 보이는 이유도 확인할 만합니다. 1회차와 2회차는 같은 SELECT였지만, DBeaver가 SQL 위의 주석 줄까지 서버로 보내면서 주석이 다른 두 문장이 서로 다른 SQL_ID(gavwp01vznz47, c2sp3q4pswh37)로 기록되었습니다. 태그 리터럴로 찾았기 때문에 두 커서가 모두 조회되었습니다.
COMPACT까지는 아무것도 줄지 않았습니다
A 테이블에는 SHRINK를 두 단계로 나눠 적용했습니다. 먼저 행 이동을 허용하고 SHRINK SPACE COMPACT로 행만 앞쪽 블록으로 모은 뒤, SHRINK SPACE로 HWM을 내렸습니다.
ALTER TABLE login_hist_a ENABLE ROW MOVEMENT;

ALTER TABLE login_hist_a SHRINK SPACE COMPACT;   -- S2: 행 이동, HWM 유지
-- FULL SCAN 측정, log_space('S2_COMPACT', 'LOGIN_HIST_A')

ALTER TABLE login_hist_a SHRINK SPACE;           -- S3: HWM 하향, 공간 반환
-- FULL SCAN 측정, log_space('S3_SHRINK', 'LOGIN_HIST_A')
COMPACT 직후 FULL SCAN Buffers는 6,069, HWM 아래 블록은 6,167로 DELETE 직후와 같았습니다. 블록 분포도 FS4 5,455, FULL 606으로 거의 변하지 않았습니다. SPACE_USAGE는 블록이 몇 개인지를 보여줄 뿐, 행이 세그먼트의 앞쪽으로 옮겨졌는지는 보여주지 않습니다. COMPACT만 실행하고 작업을 끝냈다면, FULL SCAN 비용은 그대로 남은 상태입니다.
SHRINK SPACE 후 Buffers는 610
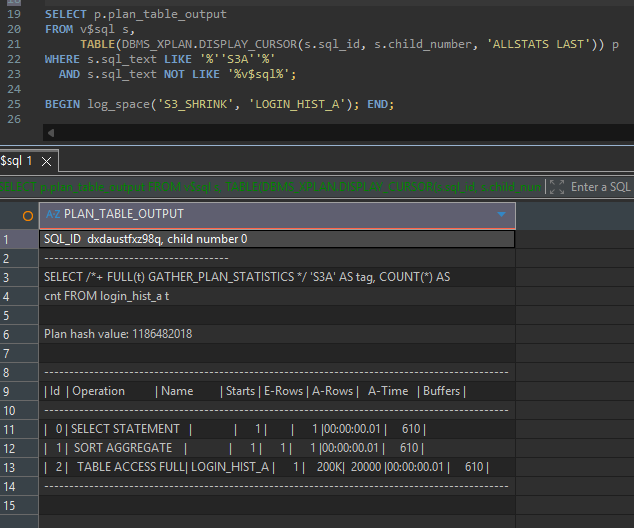
SHRINK SPACE 후 세그먼트는 632블록, HWM 아래는 625블록으로 줄었고, FULL SCAN Buffers는 610이 되었습니다. 반환 행 20,000건은 그대로이므로, 줄어든 것은 순수하게 빈 블록을 읽던 작업입니다.
블록 번호가 오히려 커진 이유는 익스텐트 배치에 있었습니다
SHRINK 전후로 남은 행 중 가장 앞의 행(180001)과 마지막 행(200000)의 ROWID를 비교했습니다.
SELECT login_id, ROWID AS rid, DBMS_ROWID.ROWID_BLOCK_NUMBER(ROWID) AS block_no
FROM login_hist_a
WHERE login_id IN (180001, 200000);| login_id | SHRINK 전 ROWID / 블록 | SHRINK 후 ROWID / 블록 |
|---|---|---|
| 180001 | AAASoTAAMAAABYuAAJ / 5,678 | AAASoTAAMAAAALvAAL / 751 |
| 200000 | AAASoTAAMAAABiWAAK / 6,294 | AAASoTAAMAAACaDAAK / 9,859 |
ROWID 앞부분의 데이터 오브젝트 번호 AAASoT는 그대로였습니다. SHRINK는 같은 세그먼트 안에서 행의 위치만 바꿨습니다. 그런데 200000번 행의 블록 번호는 6,294에서 9,859로 오히려 커졌습니다. 이 숫자를 해석하려고 SHRINK 후 익스텐트 구성을 조회했습니다.
SELECT extent_id, relative_fno, block_id, blocks,
       block_id + blocks - 1 AS last_block
FROM dba_extents
WHERE owner = 'HWM_LAB'
  AND segment_name = 'LOGIN_HIST_A'
ORDER BY extent_id;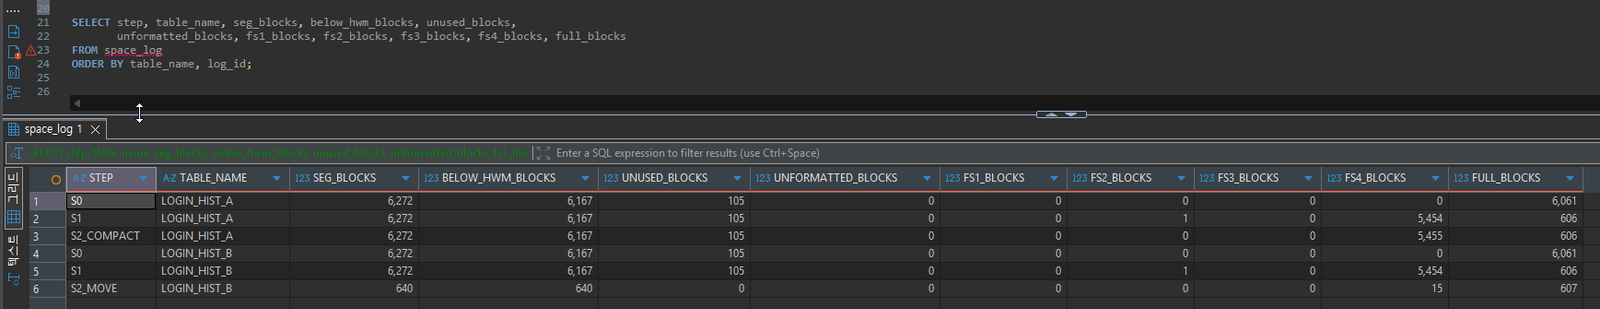
블록 9,859는 0번 익스텐트(9,856~9,863)에 속합니다. 200000번 행은 뒤로 밀려난 것이 아니라 세그먼트의 첫 번째 익스텐트로 옮겨졌습니다. 반대로 180001번 행이 옮겨 간 블록 751은 마지막 19번 익스텐트(640~759)에 있습니다. 세그먼트 끝쪽 행부터 앞쪽 빈 공간으로 채웠다고 보면 설명되는 배치이지만, 행 두 개만 확인했으므로 이동 순서는 추정입니다.
익스텐트 블록 수를 더하면 8 × 16 + 128 × 3 + 120 = 632로, SPACE_LOG의 세그먼트 블록 수와 일치합니다. 다른 큰 익스텐트가 128블록인데 마지막 19번만 120블록이라는 점에서, SHRINK SPACE가 HWM 위쪽 공간을 익스텐트 일부까지 잘라 반환한 것으로 보입니다(추정).
MOVE도 공간을 돌려줬지만 기본 키를 멈춰 세웠습니다
B 테이블에는 UPDATE INDEXES 없이 오프라인 MOVE를 실행했습니다.
ALTER TABLE login_hist_b MOVE;

SELECT index_name, status
FROM user_indexes
WHERE table_name = 'LOGIN_HIST_B';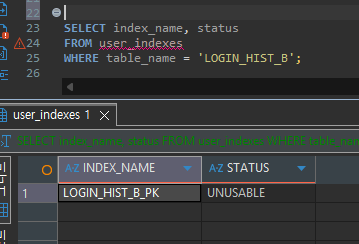
이 상태에서 새 로그인 이력 1건을 넣어 보았습니다.
INSERT INTO login_hist_b (login_id, member_id, login_dt, client_ip, user_agent)
VALUES (300001, 1, DATE '2026-07-20', '10.0.0.1', 'move-test');

SQL Error [1502] [72000]: ORA-01502: 인덱스 'HWM_LAB.LOGIN_HIST_B_PK'또는 인덱스 분할영역은 사용할 수 없은 상태입니다
기본 키를 강제하는 고유 인덱스가 UNUSABLE이면 INSERT 자체가 실패합니다. 실제 정리 작업이라면 MOVE가 끝난 순간부터 REBUILD가 끝날 때까지 이 테이블에 대한 입력이 막힌다는 뜻입니다. ALTER INDEX login_hist_b_pk REBUILD 후 상태는 VALID로 돌아왔습니다.
공간 쪽 결과는 SHRINK와 비슷했습니다. MOVE 후 세그먼트와 HWM 아래 블록은 모두 640, FULL SCAN Buffers는 625였습니다. 새 세그먼트를 직접 기록한 직후라 Reads 607이 함께 표시되었습니다. ROWID는 블록 번호뿐 아니라 데이터 오브젝트 번호까지 바뀌었습니다.
| login_id | MOVE 전 ROWID / 블록 | MOVE 후 ROWID / 블록 |
|---|---|---|
| 180001 | AAASoVAAMAAAD4uAAJ / 15,918 | AAASoYAAMAAAAUDAAA / 1,283 |
| 200000 | AAASoVAAMAAAECWAAK / 16,534 | AAASoYAAMAAAAdwAAB / 1,904 |
데이터 오브젝트 번호가 AAASoV에서 AAASoY로 바뀐 것은 MOVE가 기존 세그먼트 안에서 행을 옮긴 것이 아니라 세그먼트를 새로 만들었다는 근거입니다. 인덱스가 가리키던 ROWID가 모두 무효가 되었으니 인덱스가 UNUSABLE이 되는 것도 같은 이유로 설명됩니다.
단계별 공간 변화를 한 표로 보면
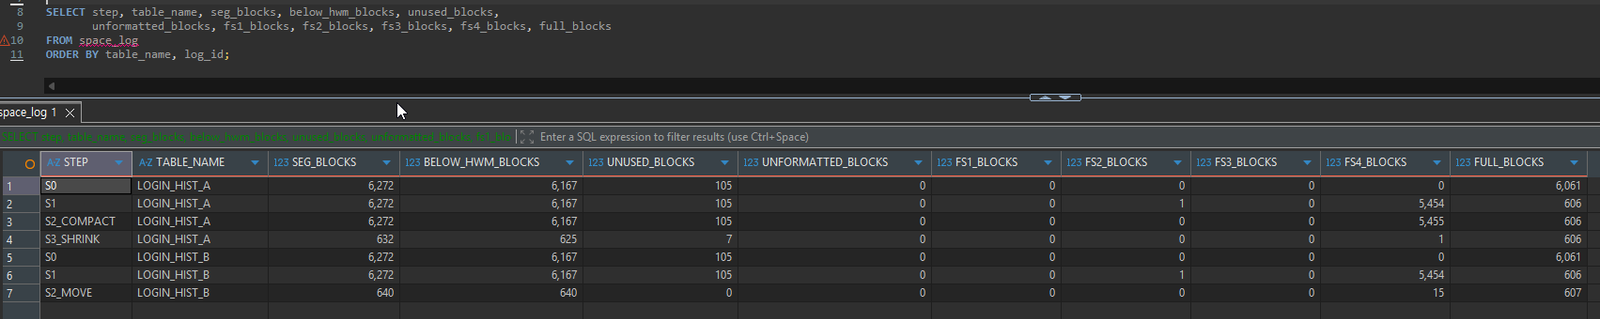
| 단계 | seg_blocks | below_hwm | fs4 | full | FULL SCAN Buffers |
|---|---|---|---|---|---|
| A 적재 직후 | 6,272 | 6,167 | 0 | 6,061 | 6,069 |
| A DELETE 후 | 6,272 | 6,167 | 5,454 | 606 | 6,069 |
| A SHRINK SPACE COMPACT | 6,272 | 6,167 | 5,455 | 606 | 6,069 |
| A SHRINK SPACE | 632 | 625 | 1 | 606 | 610 |
| B MOVE | 640 | 640 | 15 | 607 | 625 |
이번 조건에서 공간 회수 효과는 SHRINK와 MOVE가 거의 같았습니다. MOVE 쪽에 FS4 블록이 15개 더 있었지만 원인은 확인하지 않았습니다. 두 방법의 차이는 공간보다 부수 효과에서 나왔습니다.
| 비교 항목 | SHRINK SPACE | MOVE (UPDATE INDEXES 없이) |
|---|---|---|
| FULL SCAN Buffers | 6,069 → 610 | 6,069 → 625 |
| 세그먼트 | 유지 (오브젝트 번호 그대로) | 새로 생성 (오브젝트 번호 변경) |
| ROWID | 변경 | 변경 |
| 기본 키 인덱스 | 사용 가능 | UNUSABLE, INSERT 시 ORA-01502 |
| 사전 조건 | ASSM, ROW MOVEMENT 활성화 | 추가 공간, 인덱스 REBUILD |
DELETE 이후 정리 방법을 고르는 기준
대량 DELETE 뒤에 FULL SCAN이 줄지 않는다면, 먼저 HWM 아래 블록 수와 SPACE_USAGE 분포를 확인합니다. FS4 블록이 대부분이고 앞으로 같은 양의 데이터가 다시 들어올 예정이 없다면 정리할 근거가 있습니다. 반대로 곧 다시 채워질 테이블이라면 빈 블록은 새 INSERT가 재사용하므로 정리 효과가 오래가지 않습니다.
| 상황 | 판단 | 이번 실험의 근거 |
|---|---|---|
| DELETE 후 FULL SCAN 비용이 그대로 | HWM 아래 블록과 FS4 비율부터 확인 | below_hwm 6,167 유지, FS4 5,454 |
| SHRINK SPACE COMPACT만 실행 | HWM이 내려가지 않았으므로 SHRINK SPACE까지 실행해야 효과가 있음 | COMPACT 후 Buffers 6,069 |
| 정리 중에도 INSERT가 계속 들어오는 테이블 | MOVE 시 인덱스 UNUSABLE 구간을 피할 방법(UPDATE INDEXES 등)을 먼저 검토 | MOVE 직후 ORA-01502 |
| ROWID를 저장하거나 참조하는 프로그램이 있음 | SHRINK와 MOVE 모두 ROWID가 바뀌므로 영향 범위를 먼저 확인 | 두 방법 모두 ROWID 변경 |
문서상 SHRINK SPACE COMPACT 단계는 정리 중에도 DML을 허용하고, 오프라인 MOVE는 작업 동안 테이블을 잠급니다. 이번 실험은 단일 세션이었기 때문에 이 동시성 차이는 직접 검증하지 않았습니다.
이 실험의 한계
단일 세션에서 테이블당 200,000건, 행 크기 약 230바이트로 실행했고, 정리 중의 동시 DML과 잠금은 측정하지 않았습니다. 시간 값은 1회 측정이라 비교에 쓰지 않았고 Buffers만 비교했습니다. SHRINK에는 CASCADE를, MOVE에는 UPDATE INDEXES나 ONLINE을 쓰지 않았으므로, 인덱스 크기 변화와 온라인 정리 방식은 이번 결과에 포함되지 않습니다. 21c XE(21.3.0.0.0, 8KB 블록, ASSM)에서 확인한 결과이며 다른 버전과 스토리지 구성에서는 블록 수가 달라질 수 있습니다.
실습 정리
DBeaver에서 HWM_LAB 연결을 먼저 끊은 뒤 SYSTEM으로 실행합니다. 접속이 남아 있으면 DROP USER가 ORA-01940으로 실패합니다. 인스턴스 파라미터는 바꾸지 않았으므로 원복할 설정은 없습니다.
SELECT sid, serial#, status, program
FROM v$session
WHERE username = 'HWM_LAB';

DROP USER hwm_lab CASCADE;
HWM을 내리지 않은 정리는 FULL SCAN 비용을 한 블록도 줄이지 못했습니다
180,000건을 지운 DELETE도, 행을 앞으로 모은 SHRINK SPACE COMPACT도 FULL SCAN Buffers를 6,069에서 움직이지 못했습니다. 숫자가 610으로 떨어진 것은 SHRINK SPACE가 HWM을 625블록 지점으로 내린 순간이었고, MOVE는 같은 효과를 냈지만 기본 키를 UNUSABLE로 만들어 입력을 막았습니다. 대량 삭제 뒤의 정리 작업이 끝났는지는 실행 로그가 아니라 HWM 아래 블록 수와 FULL SCAN Buffers로 확인해야 한다는 것이 이번 실험에서 얻은 판단입니다.

댓글 0
첫 댓글을 남겨보세요.