같은 데이터, 다른 적재 순서: 클러스터링 팩터가 Cost와 Buffers를 각각 어떻게 바꿨나
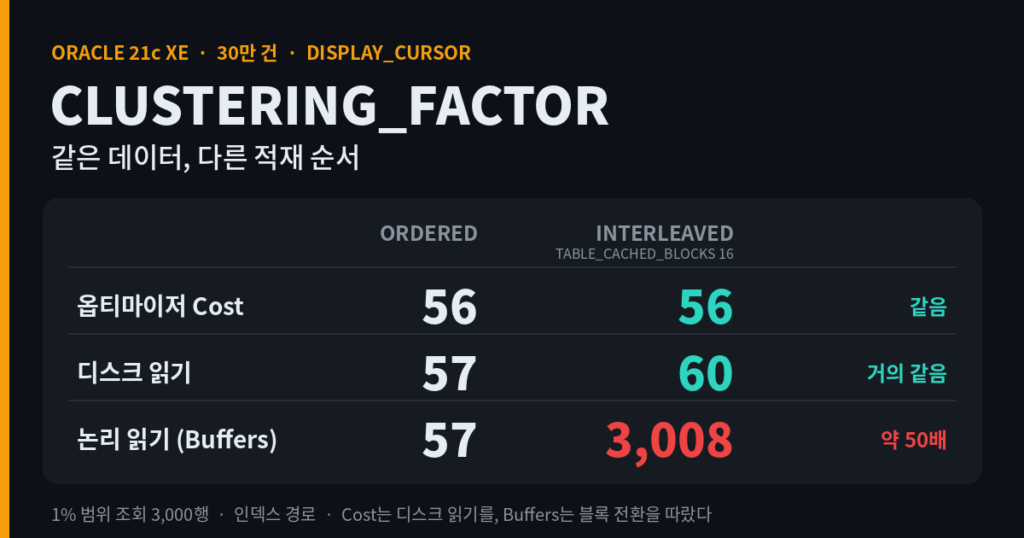
Cost 56인 실행계획 두 개, Buffers는 57과 3,008
같은 30만 행을 담은 테이블 두 개에 같은 범위 조회를 실행했습니다. 두 실행계획은 모두 인덱스 범위 스캔이었고 Cost도 56으로 같았습니다. 그런데 실제로 읽은 블록 수(Buffers)는 57과 3,008이었습니다. 두 테이블의 차이는 데이터를 넣은 순서 하나뿐입니다.
적재 순서는 CLUSTERING_FACTOR(이하 CF)를 바꾸고, CF는 인덱스 경로의 비용을 바꿉니다. 여기까지는 잘 알려진 설명입니다. 확인하고 싶었던 것은 CF가 정확히 무엇을 세는지, 그리고 그것이 실제 읽기와 얼마나 맞는지였습니다. 적재 순서만 다른 테이블 세 개를 Oracle 21c XE에서 비교했습니다.
- ORDERED: 키 순서대로 적재
- RANDOM: 해시 순서로 섞어서 적재
- INTERLEAVED: 인접한 블록 몇 개에 연속 키가 번갈아 들어가도록 적재 (동시 INSERT를 흉내 낸 배치)
측정 전에 세운 가설은 네 가지였습니다.
- ORDERED의 CF는 테이블 블록 수에, RANDOM과 INTERLEAVED의 CF는 행 수에 가깝다.
- 1% 범위 조회에서 옵티마이저는 ORDERED에만 인덱스를 고른다.
- 인덱스를 강제하면 INTERLEAVED의 Buffers는 ORDERED에 가깝다. 실제로는 블록이 모여 있으니까.
TABLE_CACHED_BLOCKS를 16으로 주면 INTERLEAVED의 CF가 내려가 인덱스를 고르지만, 실제 Buffers는 그대로다.
1, 2, 4번은 맞았고 3번은 틀렸습니다. 틀린 3번에서 CF가 세는 것의 정체가 드러났습니다.
적재 순서만 다른 세 테이블
실습 환경은 Oracle Database 21c Express Edition(21.3.0.0.0)의 PDB인 XEPDB1이고, DBeaver로 테스트 전용 USER CF_LAB에 접속했습니다. 운영 DB가 아닌 블로그 실습 환경입니다. 권한은 SYSTEM 계정으로 CREATE SESSION, CREATE TABLE, 쿼터, 그리고 V$SQL 계열과 DISPLAY_CURSOR를 쓰기 위한 SELECT_CATALOG_ROLE만 주었습니다.
비용 계산에 영향을 주는 파라미터는 기본값 그대로였습니다.
db_block_size8192db_file_multiblock_read_count51optimizer_features_enable21.1.0optimizer_index_cost_adj100,optimizer_index_caching0- 전역
TABLE_CACHED_BLOCKS1
배송 이력을 가정한 블로그용 가상 시나리오입니다. 원본 30만 건을 만든 뒤, 같은 데이터를 정렬 순서만 바꿔 CTAS로 세 번 복제했습니다. 30만 건은 테이블 블록 수(약 4,800)와 행 수가 약 60배 차이가 나서 CF가 그 사이 어디에 놓이는지 분명히 보이는 규모입니다. 섞는 순서는 난수 대신 ORA_HASH로 정해서 언제 다시 만들어도 같은 배치가 나옵니다.
CREATE TABLE dlv_src AS
SELECT LEVEL                                                     AS dlv_id,
       MOD(LEVEL * 37, 100000) / 100                             AS amount,
       CASE MOD(LEVEL, 5) WHEN 0 THEN 'RETURNED' ELSE 'DELIVERED' END AS status,
       DATE '2026-01-01' + MOD(LEVEL, 270)                       AS dlv_date,
       RPAD('x', 80, 'x')                                        AS memo
  FROM dual
CONNECT BY LEVEL <= 300000;

CREATE TABLE dlv_ordered     AS SELECT * FROM dlv_src ORDER BY dlv_id;
CREATE TABLE dlv_random      AS SELECT * FROM dlv_src ORDER BY ORA_HASH(dlv_id), dlv_id;
CREATE TABLE dlv_interleaved AS SELECT * FROM dlv_src
                                ORDER BY TRUNC((dlv_id - 1) / 800), MOD(dlv_id, 8), dlv_id;

CREATE INDEX ix_dlv_ord_id ON dlv_ordered (dlv_id);
CREATE INDEX ix_dlv_rnd_id ON dlv_random (dlv_id);
CREATE INDEX ix_dlv_ilv_id ON dlv_interleaved (dlv_id);

BEGIN
  DBMS_STATS.GATHER_TABLE_STATS(USER, 'DLV_ORDERED',     cascade => TRUE, no_invalidate => FALSE);
  DBMS_STATS.GATHER_TABLE_STATS(USER, 'DLV_RANDOM',      cascade => TRUE, no_invalidate => FALSE);
  DBMS_STATS.GATHER_TABLE_STATS(USER, 'DLV_INTERLEAVED', cascade => TRUE, no_invalidate => FALSE);
END;
INTERLEAVED는 800행 묶음 안에서 8개 흐름이 번갈아 들어가도록 정렬했습니다. 연속된 키가 가까운 블록 열 개 남짓을 오가게 만든 것입니다.
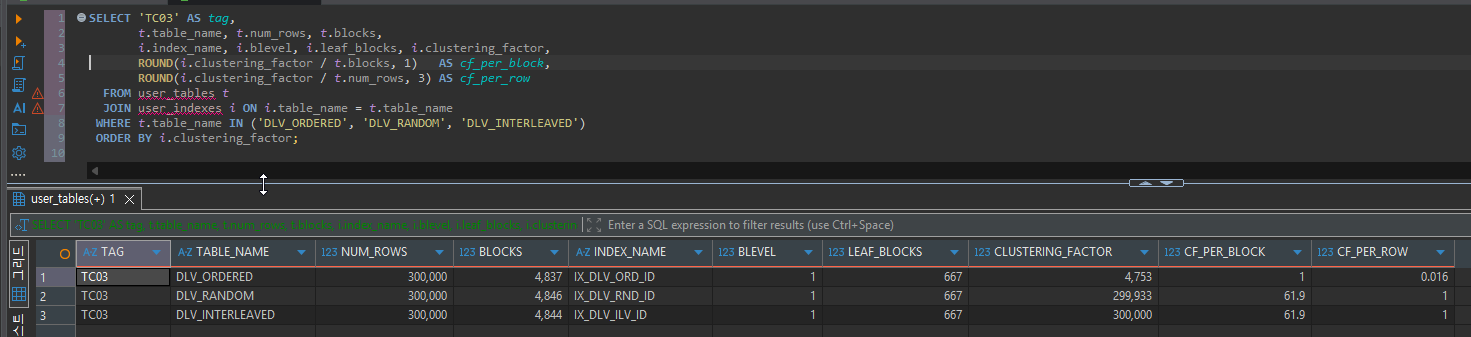
| 테이블 | NUM_ROWS | BLOCKS | BLEVEL / LEAF_BLOCKS | CLUSTERING_FACTOR |
|---|---|---|---|---|
| ORDERED | 300,000 | 4,837 | 1 / 667 | 4,753 |
| RANDOM | 300,000 | 4,846 | 1 / 667 | 299,933 |
| INTERLEAVED | 300,000 | 4,844 | 1 / 667 | 300,000 |
가설 1은 맞았습니다. 그런데 INTERLEAVED의 CF는 행이 무작위로 흩어진 RANDOM보다도 높게 나왔습니다.
CF는 무엇을 세고 있었나
통계 숫자 대신, 조회할 범위(dlv_id 100001~103000, 3,000행)가 실제로 어떻게 흩어져 있는지 DBMS_ROWID로 직접 셌습니다. 두 가지를 봤습니다. 범위 안의 행이 들어 있는 블록의 개수, 그리고 키 순서대로 읽을 때 블록이 바뀌는 횟수입니다.
WITH r AS (
  SELECT 'DLV_ORDERED' AS tn, dlv_id,
         DBMS_ROWID.ROWID_RELATIVE_FNO(rowid) || '.' || DBMS_ROWID.ROWID_BLOCK_NUMBER(rowid) AS blk
    FROM dlv_ordered WHERE dlv_id BETWEEN 100001 AND 103000
  UNION ALL
  SELECT 'DLV_RANDOM', dlv_id,
         DBMS_ROWID.ROWID_RELATIVE_FNO(rowid) || '.' || DBMS_ROWID.ROWID_BLOCK_NUMBER(rowid)
    FROM dlv_random WHERE dlv_id BETWEEN 100001 AND 103000
  UNION ALL
  SELECT 'DLV_INTERLEAVED', dlv_id,
         DBMS_ROWID.ROWID_RELATIVE_FNO(rowid) || '.' || DBMS_ROWID.ROWID_BLOCK_NUMBER(rowid)
    FROM dlv_interleaved WHERE dlv_id BETWEEN 100001 AND 103000
), x AS (
  SELECT tn, blk,
         CASE WHEN blk = LAG(blk) OVER (PARTITION BY tn ORDER BY dlv_id) THEN 0 ELSE 1 END AS chg
    FROM r
)
SELECT tn AS table_name, COUNT(*) AS rows_in_range,
       COUNT(DISTINCT blk) AS distinct_blocks,
       SUM(chg)            AS block_changes_by_key
  FROM x
 GROUP BY tn
 ORDER BY distinct_blocks, block_changes_by_key;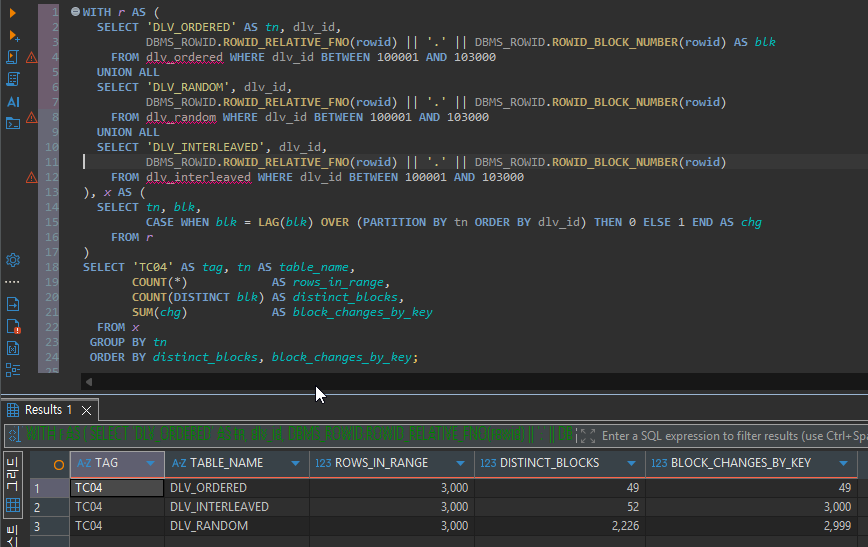
ORDERED는 49개 블록에 모여 있었고, 블록 전환도 49번이었습니다. RANDOM은 2,226개 블록에 흩어져 있었고 전환은 2,999번이었습니다. INTERLEAVED는 블록 수로는 52개라 ORDERED와 거의 같았지만, 전환 횟수는 3,000번으로 RANDOM과 같았습니다. 기본 설정(TABLE_CACHED_BLOCKS 1)의 CF는 인덱스 키 순서대로 따라갈 때 블록이 바뀌는 횟수를 세는 값입니다. 그래서 INTERLEAVED의 CF가 행 수와 같은 300,000이 나온 것입니다.
옵티마이저가 본 비용과 실제로 읽은 블록
테이블마다 같은 1% 범위 조회를 힌트 없이, 인덱스 강제(INDEX), FULL 강제(FULL)의 세 가지로 각각 3회 실행했습니다. DBeaver는 결과를 200행까지만 가져오기 때문에, 행을 반환하지 않고 COUNT(*)와 SUM으로 집계했습니다. 그래야 실행이 끝까지 진행된 상태로 통계가 남습니다. Buffers는 3회차 값입니다.
SELECT /*+ GATHER_PLAN_STATISTICS INDEX(t ix_dlv_rnd_id) */
       'CFT_RND_IDX' AS tag, COUNT(*), SUM(t.amount)
  FROM dlv_random t
 WHERE t.dlv_id BETWEEN 100001 AND 103000;

SELECT t.plan_table_output
  FROM v$sql s,
       TABLE(DBMS_XPLAN.DISPLAY_CURSOR(s.sql_id, s.child_number, 'ALLSTATS LAST +COST')) t
 WHERE s.sql_text LIKE '%''CFT_RND_IDX''%'
   AND s.command_type = 3
   AND s.sql_text NOT LIKE '%plan_table_output%';
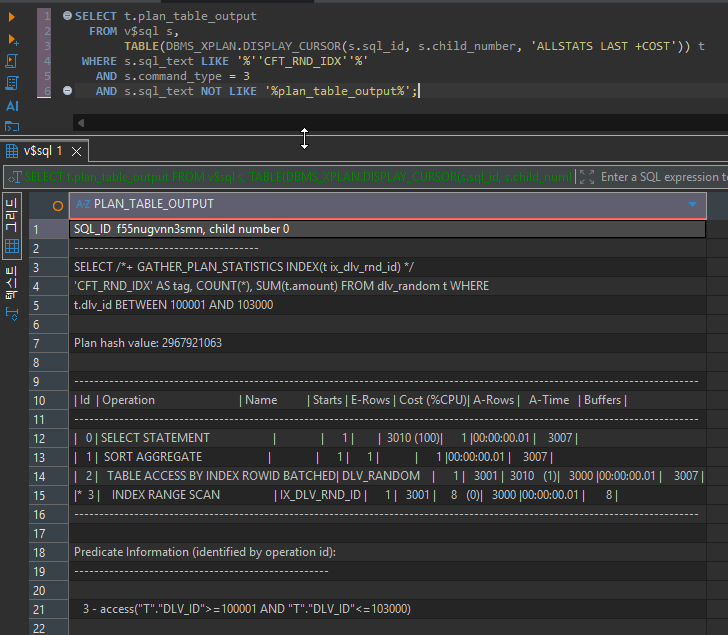
SQL마다 태그 문자열을 넣어 두고, 그 태그로 V$SQL에서 커서를 찾아 DISPLAY_CURSOR를 호출했습니다. DBeaver가 SQL 앞에 주석을 붙여 보내도 찾을 수 있도록 하기 위해서입니다.
| 테이블 | 힌트 없을 때 선택 | 인덱스 경로 Cost | FULL Cost | 인덱스 Buffers | FULL Buffers |
|---|---|---|---|---|---|
| ORDERED | 인덱스 | 56 | 1,319 | 57 | 4,760 |
| RANDOM | FULL | 3,010 | 1,321 | 3,007 | 4,769 |
| INTERLEAVED | FULL | 3,011 | 1,321 | 3,008 | 4,767 |
가설 2는 맞았습니다. 인덱스 경로 Cost는 계산해 보면 인덱스 스캔 8에 CF × 선택도(3,001 / 300,000)를 더한 값과 맞아떨어집니다. ORDERED는 8 + 4,753 × 0.01 ≈ 56이고, RANDOM은 8 + 299,933 × 0.01 ≈ 3,008에 CPU 비용이 더해진 값입니다. 같은 계산으로 보면 RANDOM에서는 선택도가 약 0.44%(1,300행 정도)보다 낮아야 인덱스 Cost가 FULL보다 작아집니다. 이 경계는 계산값이고 직접 측정하지는 않았습니다.
가설 3은 틀렸습니다. INTERLEAVED에 인덱스를 강제하자 Buffers는 3,008로, ORDERED의 57이 아니라 RANDOM의 3,007과 같았습니다. 앞 표의 블록 전환 횟수에 인덱스 블록 8개를 더하면 Buffers와 정확히 같습니다(49 + 8 = 57, 3,000 + 8 = 3,008, 2,999 + 8 = 3,007). 행이 52개 블록에 모여 있어도, 키 순서로 읽으며 블록이 바뀔 때마다 그 블록을 다시 가져오고 그것이 매번 논리 읽기로 세어졌습니다.
표에서 하나 더 볼 것이 있습니다. FULL은 Buffers가 4,760~4,769로 강제 인덱스보다 많은데도 RANDOM과 INTERLEAVED에서 선택됐습니다. FULL은 한 번에 여러 블록을 읽는 I/O로 비용이 계산되기 때문입니다. Buffers 숫자 하나만 보고 옵티마이저의 선택이 틀렸다고 판단할 수는 없습니다.
TABLE_CACHED_BLOCKS 16이 바꾼 것과 바꾸지 못한 것
TABLE_CACHED_BLOCKS는 CF를 계산할 때, 최근에 본 블록 N개 안으로 다시 돌아오면 블록 전환으로 세지 않도록 하는 통계 선호값입니다. 기본값은 1입니다. INTERLEAVED에만 16을 주고 통계를 다시 모았습니다.
BEGIN
  DBMS_STATS.SET_TABLE_PREFS(USER, 'DLV_INTERLEAVED', 'TABLE_CACHED_BLOCKS', '16');
  DBMS_STATS.GATHER_TABLE_STATS(USER, 'DLV_INTERLEAVED', cascade => TRUE, no_invalidate => FALSE);
END;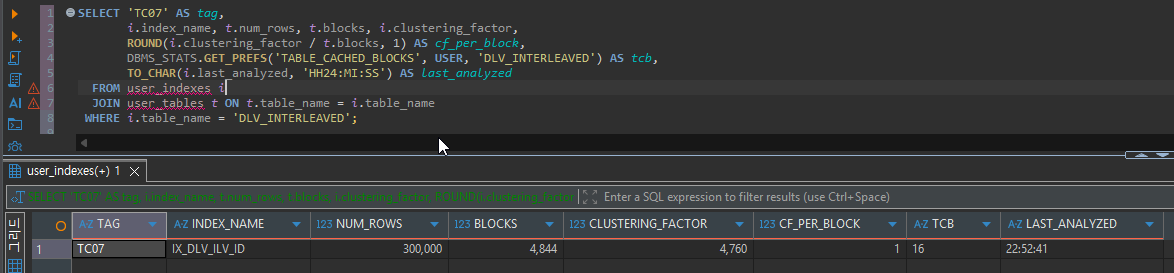
INTERLEAVED의 CF는 300,000에서 4,760으로 내려가 ORDERED의 4,753과 거의 같아졌습니다. 힌트 없는 조회의 실행계획도 FULL(Cost 1,321)에서 인덱스(Cost 56)로 바뀌었습니다. 하지만 그 인덱스 경로의 Buffers는 여전히 3,008이었습니다. 통계만 바뀌었을 뿐 데이터 배치는 그대로이기 때문입니다. 가설 4는 맞았고, 서론의 장면이 바로 이것입니다. ORDERED와 INTERLEAVED는 Cost가 56으로 같지만, Buffers는 57과 3,008입니다.
디스크 읽기는 실제 블록 수를 따랐다
그렇다면 Cost 56은 무엇과 맞는 값일까요. 이를 보려고 버퍼 캐시를 비운 직후 각 쿼리를 1회씩 실행해 디스크 읽기를 측정했습니다. 캐시 비우기는 SYSTEM 계정으로 실행했습니다. 다른 세션의 캐시 적중에도 영향을 주는 명령이라 운영 DB에서는 쓰지 않고, 이 실습 환경에서만 썼습니다. 캐시가 실제로 비워졌는지는 V$BH로 확인했습니다. 비우기 전에는 테이블마다 약 4,840블록, 인덱스마다 약 690블록이 캐시에 있었고, 비운 뒤에는 0건이었습니다.
-- SYSTEM 계정, 실습 환경 전용
ALTER SYSTEM FLUSH BUFFER_CACHE;

-- CF_LAB: 캐시에 남은 블록 수 확인
SELECT o.object_name, COUNT(*) AS cached_blocks
  FROM v$bh b
  JOIN user_objects o ON o.data_object_id = b.objd
 WHERE b.con_id = TO_NUMBER(SYS_CONTEXT('USERENV', 'CON_ID'))
   AND b.status <> 'free'
   AND o.object_name LIKE '%DLV%'
 GROUP BY o.object_name;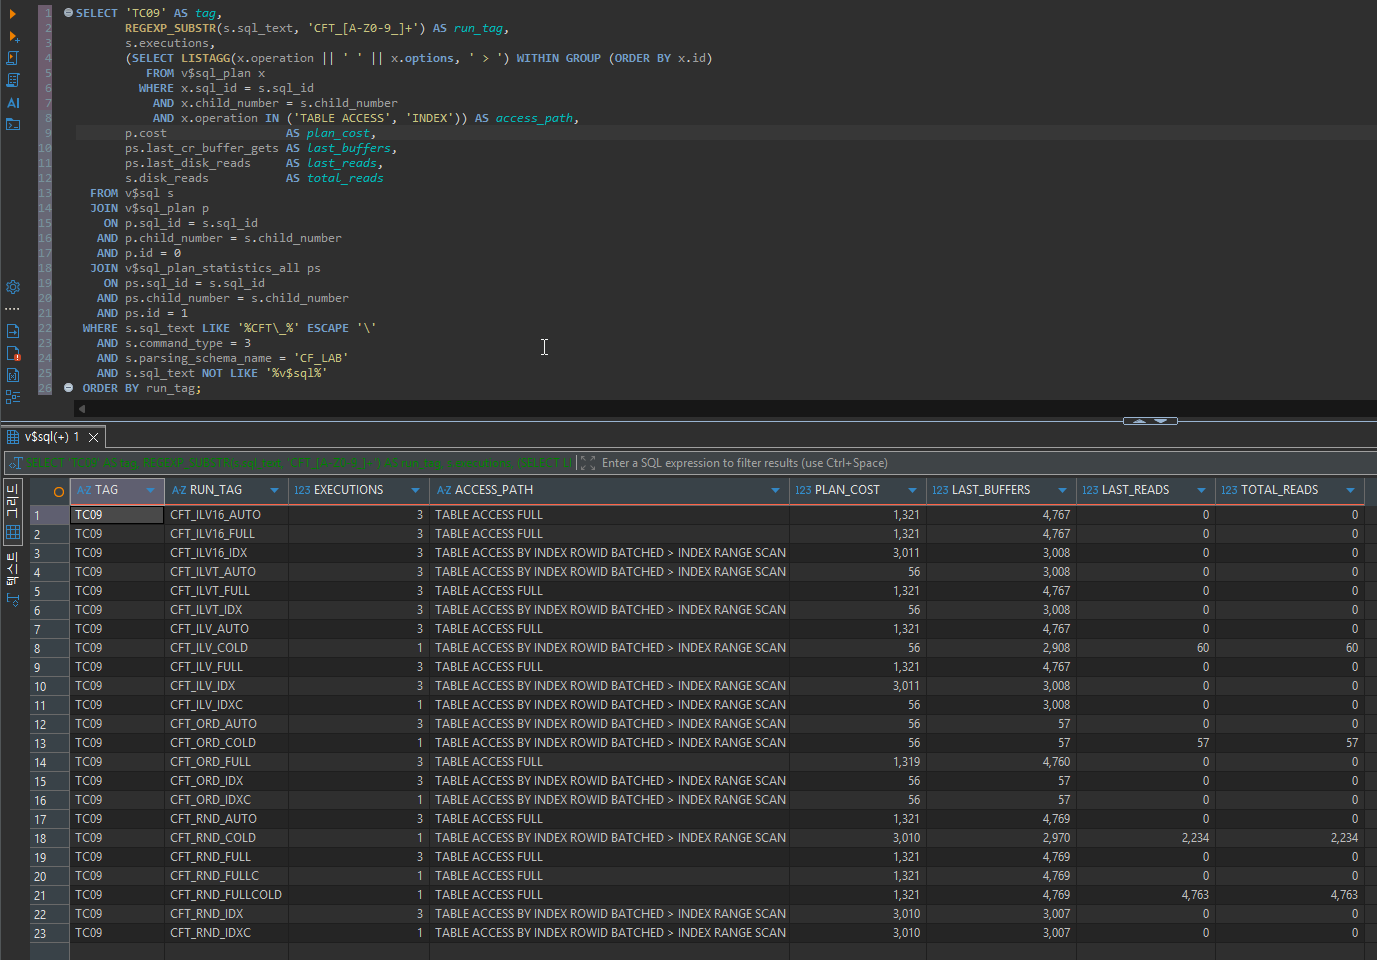
캡처의 ILV16 행은 선호값이 반영되기 전(1) 상태에서, IDXC 행은 캐시를 비우기 전 상태에서 실행된 커서입니다. 그래서 각각 ILV, IDX 행과 같은 값입니다. 비교에 쓰는 것은 COLD 행입니다.
| 인덱스 경로 (캐시를 비운 직후) | 범위 안 블록 수 | 블록 전환 횟수 | 디스크 읽기 | Buffers |
|---|---|---|---|---|
| ORDERED | 49 | 49 | 57 | 57 |
| INTERLEAVED | 52 | 3,000 | 60 | 2,908 |
| RANDOM | 2,226 | 2,999 | 2,234 | 2,970 |
디스크 읽기는 범위 안 블록 수에 인덱스 8블록을 더한 값과 정확히 같았습니다(57, 60, 2,234). 같은 블록으로 다시 돌아와도 이미 캐시에 있으니 디스크에서 다시 읽지 않은 것입니다. TABLE_CACHED_BLOCKS 16을 반영한 CF로 계산된 Cost 56은, 이 디스크 읽기 관점에서 보면 ORDERED와 INTERLEAVED를 똑같이 본 것이 맞았습니다(57 대 60). 반대로 논리 읽기는 여전히 블록 전환 횟수를 따랐습니다.
FULL을 강제한 RANDOM은 캐시를 비운 뒤 디스크 읽기가 4,763이었습니다. 인덱스 경로의 2,234보다 많지만, 여러 블록을 한 번에 읽는 방식이라 옵티마이저는 이쪽을 더 싸게 봤습니다. 캐시를 비운 상태에서는 Buffers가 2,908(INTERLEAVED), 2,970(RANDOM)으로 캐시가 찬 상태보다 조금 적게 나왔습니다. 원인은 이번에 확인하지 않았습니다. BATCHED 방식이 디스크 읽기가 필요할 때 rowid를 블록 단위로 모아 처리한 결과로 추정합니다.
CF가 높을 때 무엇을 볼 것인가
판단 기준
- CF가 행 수에 가깝다고 해서 데이터가 정말 흩어져 있다는 뜻은 아니었습니다. 테이블을 재구성하기 전에, 자주 조회하는 범위를 표본으로 골라 범위 안 블록 수와 블록 전환 횟수를 함께 보는 편이 정확합니다. 블록 수까지 많다면(RANDOM) 재구성이나 접근 방식을 바꾸는 것이 효과가 있습니다. 블록 수는 적은데 전환만 많다면(INTERLEAVED), 디스크 읽기 관점에서는 데이터 배치보다 CF 계산 방식의 문제에 가깝습니다. 다만 이번 실험처럼 논리 읽기는 실제로 많으므로, 재구성 없이 넘어갈지는 그 SQL의 Buffers까지 보고 정해야 합니다.
TABLE_CACHED_BLOCKS를 높이면 Cost가 디스크 읽기에 가까워집니다. 하지만 논리 읽기는 줄지 않습니다. 캐시 적중률이 높고 CPU가 병목인 시스템이라면, 같은 Cost 56이어도 실제 부담은 50배 차이가 날 수 있습니다.- 이 선호값은 테이블의 모든 SQL 실행계획에 영향을 줍니다. 이번에도 힌트 없는 조회의 실행계획이 바로 바뀌었습니다. 적용 전에 그 테이블을 쓰는 주요 SQL의 실행계획 변화를 확인해야 합니다.
- 실행계획의 Cost는 예상값입니다. 같은 Cost라도 실제 비용이 다를 수 있으므로,
GATHER_PLAN_STATISTICS와DISPLAY_CURSOR로 Buffers와 Reads를 함께 봐야 합니다.
조건이 달라지면 결과가 바뀔 수 있는 지점
- INTERLEAVED는 800행 묶음에 8개 흐름이라는 단순한 모형입니다. 실제 동시 INSERT로 섞이는 폭이 16블록보다 넓다면, 선호값 16으로는 CF가 이만큼 내려가지 않을 수 있습니다.
- 조회 범위는 1% 한 가지만 측정했습니다. 선택도가 달라지면 인덱스와 FULL의 선택이 바뀝니다.
- 시스템 통계와 버퍼 캐시 크기는 확인하지 않았습니다. 둘 다 FULL 비용과 실제 디스크 읽기에 영향을 줄 수 있습니다.
운영에서 추가로 확인할 것
DBA_INDEXES.CLUSTERING_FACTOR를 테이블의BLOCKS,NUM_ROWS와 나란히 놓고, 어느 쪽에 가까운지DBMS_STATS.GET_PREFS('TABLE_CACHED_BLOCKS', 소유자, 테이블)로 이미 바뀐 선호값이 있는지- CF가 높은 인덱스를 쓰는 주요 SQL의 실제 Buffers와 Reads
이 테스트의 한계
단일 세션이었고 데이터는 30만 건, 조회 범위는 하나였습니다. 캐시를 비운 측정은 쿼리마다 1회씩만 했습니다. XE의 메모리 제한 안에서 측정했으며, 경과 시간은 비교에 쓰지 않았습니다.
CF는 논리 읽기를 셌고, TABLE_CACHED_BLOCKS는 디스크 읽기를 셌다
같은 데이터를 세 가지 순서로 넣었을 뿐인데 CF는 4,753, 299,933, 300,000으로 갈렸습니다. 기본 설정의 CF는 키 순서로 따라갈 때 블록이 바뀌는 횟수였고, 인덱스 경로의 논리 읽기는 그 횟수에 인덱스 8블록을 더한 값과 정확히 일치했습니다. TABLE_CACHED_BLOCKS 16은 INTERLEAVED의 CF를 4,760으로 낮춰 Cost를 ORDERED와 같은 56으로 만들었습니다. 이 값은 디스크 읽기(57 대 60)와는 맞았지만 논리 읽기(57 대 3,008)와는 맞지 않았습니다. CF를 보고 인덱스의 비용을 판단할 때는, 그 숫자가 디스크 읽기와 논리 읽기 중 어느 쪽을 말하는지부터 구분해야 합니다.

댓글 0
첫 댓글을 남겨보세요.