Oracle 21c DBA 실습 환경 구성: PDB·계정·10만 건 테스트 데이터 준비
Oracle에서 SQL을 직접 테스트할 때는 테이블과 데이터를 만드는 일만큼 실행 환경을 확인하는 일이 중요합니다. 같은 SQL이라도 접속 계정, 컨테이너, 인덱스와 통계 상태가 다르면 결과를 해석하는 기준이 달라집니다.
이 글에서는 Windows에 설치한 Oracle Database 21c Express Edition에 DBeaver로 접속합니다. PDB 안에 별도 실습 계정을 만들고 주문 형태의 테스트 데이터 10만 건을 생성한 뒤, 데이터 분포·인덱스·통계를 점검하고 실제 실행계획까지 확인합니다.
모든 결과는 아래 환경에서 직접 실행한 값입니다. 운영 장애 사례나 성능 개선 결과가 아니라, 이후 SQL 튜닝 실험에 사용할 기준 환경을 만드는 과정입니다.
테스트 환경
| 항목 | 확인한 환경 |
|---|---|
| 운영체제 | Windows |
| 데이터베이스 | Oracle Database 21c Express Edition |
| 버전 | 21.3.0.0.0 |
| 클라이언트 | DBeaver |
| PDB / 서비스 이름 | XEPDB1 / xepdb1 |
| 실습 계정 | ORA_LAB |
| 기본 / 임시 테이블스페이스 | USERS / TEMP |
| USERS 공간 할당량 | 256MB |
| 테스트 테이블 | LAB_ORDERS (100,000건) |
1. 검증 결과가 SYS 계정으로 나왔습니다
처음에는 관리자 연결로 권한을 설정한 뒤, 같은 SQL 편집기에서 검증 쿼리를 이어서 실행했습니다. 조회 결과의 접속 계정은 실습용 ORA_LAB이 아니라 SYS였습니다.
컨테이너가 XEPDB1이라는 것만으로는 충분하지 않았습니다. 관리자와 실습 계정은 같은 PDB에 접속할 수 있습니다. 그래서 컨테이너가 맞더라도 계정과 객체 소유자는 다를 수 있습니다.
이 차이는 USER_TABLES, USER_INDEXES 같은 USER_ 계열 뷰에서 바로 문제가 됩니다. 이 뷰들은 현재 접속한 사용자가 소유한 객체만 보여 줍니다. 관리자 연결에서 객체를 만들고 조회했다면, 그 결과를 실습 계정의 상태로 설명할 수 없습니다.
DBeaver에서는 새 연결을 추가해도 이미 열려 있는 SQL 편집기의 연결은 바뀌지 않습니다. 그래서 이후 작업은 ORA_LAB 연결로 새 SQL 편집기를 열어 진행했습니다. 데이터를 만들기 전에는 접속 계정과 PDB를 다시 확인했습니다.
2. 관리자 연결에서 실습 계정 만들기
실습 계정을 구성할 때는 세 가지를 나누어 확인합니다.
- 접속과 객체 생성 권한: 로그인에는
CREATE SESSION, 테이블 생성에는CREATE TABLE이 필요합니다. - 테이블스페이스 할당량: 테이블 생성 권한이 있어도 공간 할당량이 없으면 데이터 적재 단계에서
ORA-01950오류가 발생합니다. - 진단 정보 조회 권한: 일반 테이블 조회와 커서 실행계획 조회는 필요한 권한이 다릅니다.
SYS 같은 관리자 계정은 이 세 가지를 모두 가지고 있습니다. 그래서 관리자 연결에서는 권한이 빠져도 문제가 드러나지 않습니다. 실제 검증을 실습 계정에서 해야 하는 이유입니다.
아래 SQL은 XEPDB1에 접속한 관리자 연결에서 실행합니다. 비밀번호는 예시이므로 실제 환경에서는 별도로 지정합니다. 이미 ORA_LAB 계정이 있다면 생성문은 건너뜁니다.
sql
CREATE USER ora_lab IDENTIFIED BY "Change_This_Lab_Password"
DEFAULT TABLESPACE users TEMPORARY TABLESPACE temp
QUOTA 256M ON users;
sql
GRANT CREATE SESSION, CREATE TABLE TO ora_lab;
GRANT SELECT ON SYS.V_$VERSION TO ora_lab;
GRANT SELECT ON SYS.V_$SQL TO ora_lab;
GRANT SELECT ON SYS.V_$SESSION TO ora_lab;
GRANT SELECT ON SYS.V_$SQL_PLAN TO ora_lab;
GRANT SELECT ON SYS.V_$SQL_PLAN_STATISTICS_ALL TO ora_lab;
GRANT EXECUTE ON SYS.DBMS_STATS TO ora_lab;
GRANT EXECUTE ON SYS.DBMS_XPLAN TO ora_lab;
권한은 V$SQL이 아니라 V_$SQL에 부여합니다. V$SQL은 실제 뷰인 SYS.V_$SQL을 가리키는 공개 동의어(public synonym)입니다. 동의어에 GRANT를 시도하면 ORA-02030 오류가 발생합니다.
DBMS_XPLAN.DISPLAY_CURSOR로 실제 실행계획을 보려면 V_SQL, V_ SESSION, V_SQL_PLAN, V_ SQL_PLAN_STATISTICS_ALL 네 개 뷰의 조회 권한이 필요합니다. 하나라도 빠지면 실행계획 대신 권한 관련 메시지가 출력됩니다.
3. ORA_LAB 연결에서 접속 정보와 권한 검증하기
이제 ORA_LAB 연결로 새 SQL 편집기를 열고, 현재 세션이 어느 계정과 컨테이너에 연결되어 있는지 확인합니다.
sql
SELECT v.banner_full AS oracle_version, USER AS login_user,
       SYS_CONTEXT('USERENV', 'CON_NAME') AS container_name,
       SYS_CONTEXT('USERENV', 'SERVICE_NAME') AS service_name,
       SYS_CONTEXT('USERENV', 'SID') AS session_id
FROM v$version v
WHERE v.banner LIKE 'Oracle Database%';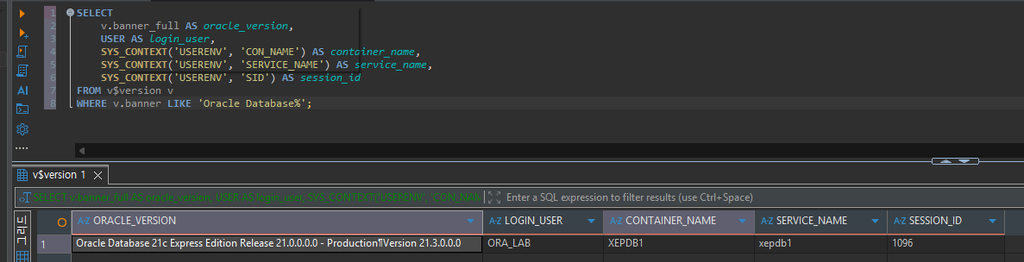
결과는 LOGIN_USER가 ORA_LAB, CONTAINER_NAME이 XEPDB1, SERVICE_NAME이 xepdb1입니다. 버전은 21c Express Edition Release 21.0.0.0.0, Version 21.3.0.0.0으로 표시되었습니다. 이 쿼리는 V_$VERSION 권한이 있어야 실행되므로, 권한 부여도 함께 확인한 셈입니다.
다음은 테이블스페이스, 할당량, 권한을 한 번에 점검하는 쿼리입니다.
sql
SELECT 1 AS check_no, 'LOGIN_USER' AS check_item, USER AS check_value FROM dual
UNION ALL
SELECT 2, 'DEFAULT_TABLESPACE', default_tablespace FROM user_users
UNION ALL
SELECT 3, 'TEMPORARY_TABLESPACE', temporary_tablespace FROM user_users
UNION ALL
SELECT 4, 'QUOTA_MB', CASE WHEN q.max_bytes=-1 THEN 'UNLIMITED' ELSE TO_CHAR(ROUND(q.max_bytes/1048576,2)) END
FROM user_ts_quotas q JOIN user_users u ON u.default_tablespace=q.tablespace_name
UNION ALL
SELECT 5, 'CREATE_SESSION', CASE WHEN COUNT(*)>0 THEN 'GRANTED' ELSE 'NOT GRANTED' END FROM user_sys_privs WHERE privilege='CREATE SESSION'
UNION ALL
SELECT 6, 'CREATE_TABLE', CASE WHEN COUNT(*)>0 THEN 'GRANTED' ELSE 'NOT GRANTED' END FROM user_sys_privs WHERE privilege='CREATE TABLE'
UNION ALL
SELECT 7, 'XPLAN_VIEW_SELECT_GRANTS', TO_CHAR(COUNT(*)) || ' / 4' FROM user_tab_privs_recd
WHERE owner='SYS' AND privilege='SELECT' AND table_name IN ('V_$SQL','V_$SESSION','V_$SQL_PLAN','V_$SQL_PLAN_STATISTICS_ALL')
ORDER BY 1;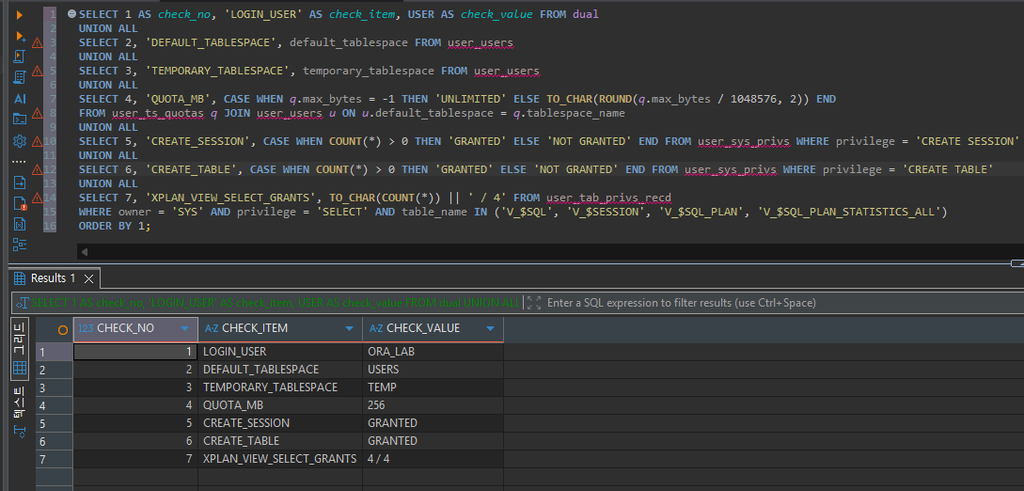
| 점검 항목 | 실제 결과 |
|---|---|
| LOGIN_USER | ORA_LAB |
| DEFAULT_TABLESPACE | USERS |
| TEMPORARY_TABLESPACE | TEMP |
| QUOTA_MB | 256 |
| CREATE_SESSION | GRANTED |
| CREATE_TABLE | GRANTED |
| XPLAN_VIEW_SELECT_GRANTS | 4 / 4 |
4 / 4는 실행계획 조회에 필요한 네 개 뷰의 SELECT 권한이 ORA_LAB에 직접 부여되어 있다는 뜻입니다. 계정의 전체 권한을 평가한 값은 아닙니다. 이 쿼리는 USER_SYS_PRIVS와 USER_TAB_PRIVS_RECD만 보므로, 롤을 통해 받은 권한은 집계하지 않습니다.
4. 재현 가능한 주문 데이터 10만 건 생성하기
이후 실험에서 같은 데이터를 다시 만들 수 있도록 무작위 함수 대신 MOD 기반의 고정 규칙을 사용했습니다.
| 컬럼 | 생성 규칙 | 결과 |
|---|---|---|
| order_id | LEVEL | 1 ~ 100,000 |
| customer_id | MOD(LEVEL-1, 10000) + 1 | 10,000개 값 반복 |
| order_date | 2025-01-01 + 365일 순환 + 초 단위 시각 | 2025년 1년 범위 |
| order_status | MOD(LEVEL-1, 100) 구간 | NEW 5%, PAID 80%, CANCEL 15% |
| order_amount | 10 + MOD(LEVEL×37, 100000)/100 | 10 ~ 1,009.99 |
테이블 생성
여기부터는 ORA_LAB 연결에서 실행합니다.
sql
CREATE TABLE lab_orders (
    order_id NUMBER(10) NOT NULL, customer_id NUMBER(10) NOT NULL,
    order_date DATE NOT NULL, order_status VARCHAR2(10 CHAR) NOT NULL,
    order_amount NUMBER(12,2) NOT NULL, memo VARCHAR2(100 CHAR),
    CONSTRAINT pk_lab_orders PRIMARY KEY (order_id),
    CONSTRAINT ck_lab_orders_status CHECK (order_status IN ('NEW','PAID','CANCEL'))
) NOPARALLEL;
데이터 적재
sql
INSERT INTO lab_orders (order_id, customer_id, order_date, order_status, order_amount, memo)
SELECT LEVEL, MOD(LEVEL-1,10000)+1,
       DATE '2025-01-01' + MOD(LEVEL-1,365) + MOD(LEVEL-1,86400)/86400,
       CASE WHEN MOD(LEVEL-1,100)<5 THEN 'NEW' WHEN MOD(LEVEL-1,100)<85 THEN 'PAID' ELSE 'CANCEL' END,
       10 + MOD(LEVEL*37,100000)/100, RPAD('LAB DATA ',80,'X')
FROM dual CONNECT BY LEVEL<=100000;

COMMIT;
memo 컬럼은 80자 고정 문자열로 채웠습니다. 행 길이를 일정하게 만들어 테이블 블록 수가 지나치게 작아지지 않도록 하기 위해서입니다.
건수와 분포 검증
INSERT 완료 메시지만으로 준비가 끝났다고 판단하지 않고, 실제 건수와 상태별 분포를 집계했습니다.
sql
WITH summary AS (
    SELECT order_status, GROUPING(order_status) AS is_total,
           COUNT(*) AS row_count, COUNT(DISTINCT order_id) AS distinct_order_ids,
           COUNT(DISTINCT customer_id) AS distinct_customers,
           MIN(order_date) AS min_dt, MAX(order_date) AS max_dt
    FROM lab_orders GROUP BY ROLLUP(order_status)
)
SELECT CASE WHEN is_total=1 THEN 'TOTAL' ELSE order_status END AS order_status,
       row_count,
       ROUND(row_count*100/NULLIF(MAX(CASE WHEN is_total=1 THEN row_count END) OVER (),0),2) AS ratio_pct,
       distinct_order_ids, distinct_customers,
       TO_CHAR(min_dt,'YYYY-MM-DD HH24:MI:SS') AS min_order_date,
       TO_CHAR(max_dt,'YYYY-MM-DD HH24:MI:SS') AS max_order_date
FROM summary ORDER BY is_total, order_status;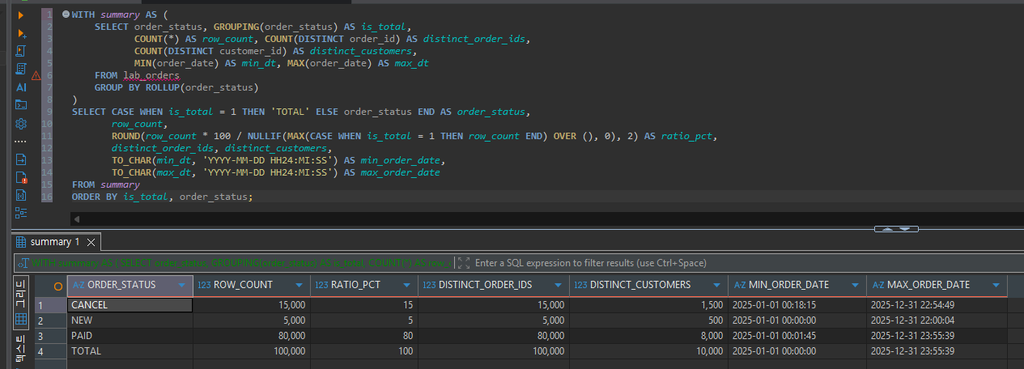
| 상태 | 행 수 | 비율 | 주문번호 수 | 고객번호 수 |
|---|---|---|---|---|
| CANCEL | 15,000 | 15% | 15,000 | 1,500 |
| NEW | 5,000 | 5% | 5,000 | 500 |
| PAID | 80,000 | 80% | 80,000 | 8,000 |
| TOTAL | 100,000 | 100% | 100,000 | 10,000 |
전체 주문일 범위는 2025-01-01 00:00:00부터 2025-12-31 23:55:39까지입니다.
상태별 고객번호 수를 더하면 500 + 8,000 + 1,500 = 10,000으로, 전체 고객 수와 정확히 같습니다. 즉 한 고객은 하나의 상태만 가집니다. 고객번호는 MOD(LEVEL-1, 10000), 상태는 MOD(LEVEL-1, 100)으로 정해지는데, 10,000이 100의 배수입니다. 그래서 고객번호가 같으면 상태 구간도 항상 같습니다.
실제 서비스에서는 거의 나오지 않는 분포입니다. 고객번호와 상태를 함께 조건으로 쓰는 실험에서는 이 상관관계가 옵티마이저 추정에 영향을 줄 수 있습니다. 그런 실험을 할 때는 이 점을 전제 조건으로 기록해야 합니다.
5. 인덱스 생성과 통계 수집
기본키 인덱스 외에 주문 상태와 주문일을 사용하는 복합 인덱스를 만들었습니다.
sql
CREATE INDEX ix_lab_orders_status_date
ON lab_orders (order_status, order_date) NOPARALLEL;
통계는 100% 샘플링으로 수집했습니다. 컬럼 히스토그램은 만들지 않도록 SIZE 1을 지정했습니다.
sql
BEGIN
    DBMS_STATS.GATHER_TABLE_STATS(
        ownname=>USER, tabname=>'LAB_ORDERS', estimate_percent=>100,
        method_opt=>'FOR ALL COLUMNS SIZE 1', degree=>1,
        cascade=>TRUE, no_invalidate=>FALSE
    );
END;
히스토그램을 일부러 제외한 이유가 있습니다. 히스토그램 없는 상태를 기준값으로 두면, 이후 히스토그램을 추가했을 때 옵티마이저 추정이 어떻게 바뀌는지 같은 데이터로 비교할 수 있습니다. 이 설정은 실험용 조건이며, 운영 환경의 대형 테이블에 권장하는 수집 방식은 아닙니다.
sql
SELECT i.index_name, i.index_type, i.uniqueness, i.status AS index_status,
       LISTAGG(c.column_name || ' ' || c.descend, ', ')
           WITHIN GROUP (ORDER BY c.column_position) AS index_columns,
       i.num_rows AS index_num_rows, t.num_rows AS table_num_rows,
       TO_CHAR(i.last_analyzed,'YYYY-MM-DD HH24:MI:SS') AS index_last_analyzed
FROM user_indexes i
JOIN user_ind_columns c ON c.index_name=i.index_name AND c.table_name=i.table_name
JOIN user_tables t ON t.table_name=i.table_name
WHERE i.table_name='LAB_ORDERS'
GROUP BY i.index_name, i.index_type, i.uniqueness, i.status,
         i.num_rows, t.num_rows, i.last_analyzed
ORDER BY i.index_name;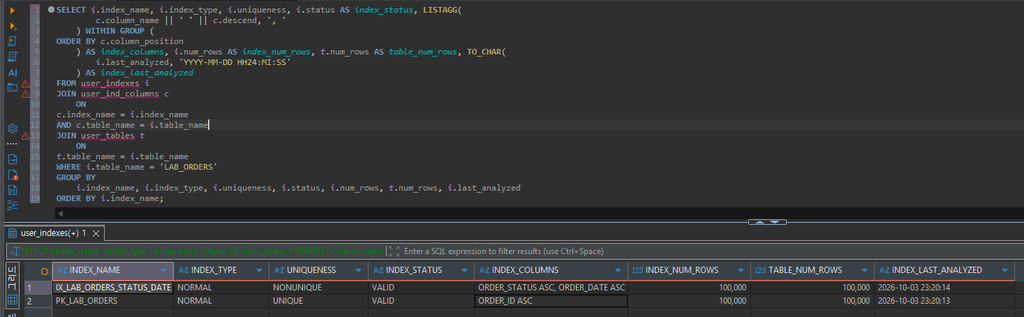
| 인덱스 | 컬럼 순서 | 유형 | 유일성 | 상태 | 통계 행 수 |
|---|---|---|---|---|---|
| IX_LAB_ORDERS_STATUS_DATE | ORDER_STATUS ASC, ORDER_DATE ASC | NORMAL | NONUNIQUE | VALID | 100,000 |
| PK_LAB_ORDERS | ORDER_ID ASC | NORMAL | UNIQUE | VALID | 100,000 |
테이블 통계의 NUM_ROWS도 100,000이고, 통계 수집 시각은 2026-10-03 23:20으로 기록되었습니다.
NUM_ROWS는 현재 데이터를 실시간으로 센 값이 아니라 통계를 수집한 시점의 값입니다. 이번에는 적재 직후에 수집했기 때문에 실제 COUNT 결과와 일치합니다. 이후 데이터를 바꾸는 실험에서는 통계 재수집 여부를 함께 기록해야 결과를 비교할 수 있습니다.
6. 인덱스가 있어도 실제 계획은 Full Table Scan이었습니다
환경 검증의 마지막 단계로 2025년 1월의 NEW 상태 주문을 집계했습니다. GATHER_PLAN_STATISTICS 힌트로 실행 통계를 수집하고, 커서를 찾기 위한 식별 주석을 붙였습니다. 인덱스 사용을 강제하는 힌트는 넣지 않았고, 실행 전에 버퍼 캐시도 비우지 않았습니다.
sql
SELECT /*+ GATHER_PLAN_STATISTICS */ /* ORA_LAB_SETUP_CHECK */
       COUNT(*) AS matched_rows, SUM(order_amount) AS total_amount
FROM lab_orders
WHERE order_status='NEW'
  AND order_date>=DATE '2025-01-01' AND order_date<DATE '2025-02-01';
실행한 커서의 SQL_ID와 CHILD_NUMBER를 찾아 실제 실행계획을 조회합니다. 조회 쿼리 안에서는 식별 문자열을 'ORA_LAB_SETUP_' || 'CHECK'로 나누어 적었습니다. 이렇게 해야 조회 쿼리 자신이 V$SQL 검색 결과에 섞이지 않습니다.
sql
SELECT p.plan_table_output
FROM (
    SELECT sql_id, child_number FROM v$sql
    WHERE parsing_schema_name=USER AND command_type=3 AND executions>0
      AND INSTR(sql_text,'ORA_LAB_SETUP_' || 'CHECK')>0
    ORDER BY last_active_time DESC, child_number DESC
    FETCH FIRST 1 ROW ONLY
) s
CROSS APPLY TABLE(
    DBMS_XPLAN.DISPLAY_CURSOR(s.sql_id, s.child_number, 'ALLSTATS LAST +PREDICATE')
) p;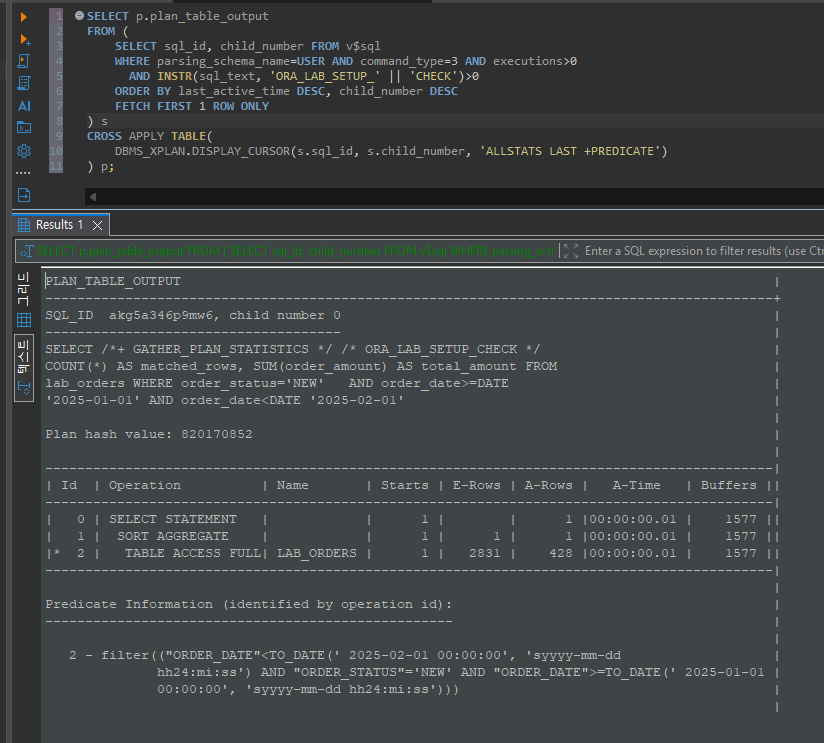
| 항목 | 확인한 값 |
|---|---|
| SQL_ID / child number | akg5a346p9mw6 / 0 |
| Plan hash value | 820170852 |
| 실행계획 | SELECT STATEMENT → SORT AGGREGATE → TABLE ACCESS FULL |
| 테이블 접근 단계 E-Rows | 2,831 |
| 테이블 접근 단계 A-Rows | 428 |
| Buffers | 1,577 |
| A-Time | 00:00:00.01 |
Predicate Information을 보면 두 조건이 모두 filter로 처리되었습니다. 인덱스를 통한 access 조건이 아니라, 테이블의 모든 행을 읽으면서 조건을 하나씩 비교했다는 뜻입니다.
E-Rows 2,831은 어디서 나왔을까
실제로 조건에 맞는 행은 428건인데, 옵티마이저는 2,831건을 예상했습니다. 약 6.6배 차이입니다. 이 값은 히스토그램이 없을 때의 기본 선택도 계산과 맞아떨어집니다.
- order_status = ‘NEW’: 히스토그램이 없으면 옵티마이저는 값이 균등하게 분포한다고 보고 1 / NDV를 사용합니다. 상태값은 3개이므로 선택도는 1/3, 약 33.3%입니다. 실제 NEW 비율은 5%입니다.
- order_date 범위: 컬럼의 최솟값과 최댓값 사이에서 조건 범위가 차지하는 비율을 사용합니다. 전체 범위는 약 364.997일(01-01 00:00:00 ~ 12-31 23:55:39)이고 조건 범위는 31일입니다. 선택도는 약 8.49%입니다.
- 두 조건을 서로 독립이라고 보고 곱하면 100,000 × 1/3 × 31/364.997 ≈ 2,831입니다.
옵티마이저 트레이스(10053)로 확인한 값은 아니지만, 표시된 E-Rows와 정확히 일치합니다. 주문일은 실제로도 1년에 고르게 퍼져 있으므로 날짜 쪽 추정은 거의 맞습니다. 차이의 대부분은 상태값에서 나옵니다. 33.3% ÷ 5% ≈ 6.7배로, 관측된 차이(약 6.6배)와 같은 수준입니다.
왜 인덱스를 쓰지 않았을까
E-Rows가 과대 추정된 것은 확인했지만, 그것만으로 Full Table Scan을 설명하기는 어렵습니다. 추정이 정확했어도 같은 계획이 선택되었을 가능성이 있기 때문입니다.
이 데이터에서는 상태가 100행 주기로 반복됩니다. NEW 행은 테이블 전체에 흩어져 있습니다. 인덱스로 428건을 찾더라도 각 행을 읽으려면 서로 다른 테이블 블록을 하나씩 방문해야 할 가능성이 큽니다. Full Table Scan의 Buffers 1,577은 테이블 전체 블록 수와 비슷한 규모입니다. 수천 번의 단일 블록 접근보다 1,500여 개 블록을 멀티블록으로 읽는 쪽이 비용이 낮다고 판단했을 수 있습니다.
이 부분은 아직 가설입니다. 인덱스의 CLUSTERING_FACTOR와 테이블 BLOCKS 값, 인덱스 경로의 비용을 직접 확인해야 판단할 수 있습니다. 이번 글에서는 접근 방식을 바꾸지 않고 이 결과를 기준값으로 기록합니다.
실행 통계를 읽을 때 주의할 점
- SORT AGGREGATE 단계의 A-Rows 1은 COUNT와 SUM이 한 행을 반환한 결과입니다. 조건에 맞는 행 수는 하위 단계인 TABLE ACCESS FULL의 A-Rows 428에서 확인합니다.
- Buffers는 논리적 버퍼 접근량이며, 디스크에서 읽은 블록 수와 같은 의미가 아닙니다. 또한 부모 단계의 값은 자식 단계 값을 누적해 보여 주므로, 세 단계에 표시된 1,577을 더하면 안 됩니다.
- A-Time 0.01초는 한 번 실행한 값입니다. 이후 비교에서는 반복 실행 결과와 캐시 상태를 함께 기록합니다.
7. 구성 전후에 달라진 것
이번 작업의 전후 비교는 성능 개선이 아니라 환경 분리와 검증 범위에 초점을 둡니다.
| 점검 항목 | 초기 상태 | 정리 후 상태 |
|---|---|---|
| 검증 실행 계정 | SYS 관리자 연결 | ORA_LAB 실습 연결 |
| 계정 기본 테이블스페이스 | SYSTEM | USERS |
| 공간 할당량 검증 | 확인하지 않음 | 256MB 확인 |
| 진단 뷰 직접 권한 | SYS 결과로는 판단 불가 | ORA_LAB에서 4 / 4 확인 |
| 데이터 검증 | 관리자 연결에서 확인 | 실습 계정에서 100,000건 재검증 |
| SQL 검증 범위 | 집계 결과만 확인 | 실제 실행계획과 실행 통계 확인 |
이제 이후 글에서는 계정, 객체, 데이터, 통계, 측정 결과를 모두 같은 기준으로 설명할 수 있습니다.
8. 운영 환경에 적용할 때의 판단 기준
관리자 작업과 검증 작업의 연결을 분리합니다. 계정 생성과 권한 부여는 관리자 연결에서, 데이터 생성과 SQL 검증은 대상 계정 연결에서 수행합니다. DBeaver처럼 여러 연결을 등록하는 도구에서는 검증 쿼리를 실행하기 전에 편집기의 활성 연결을 먼저 확인합니다.
권한과 공간 할당량을 따로 봅니다. CREATE TABLE 권한이 있다고 데이터를 적재할 수 있는 것은 아닙니다. 이번 256MB는 10만 건 실험에 맞춘 값입니다. 데이터와 인덱스를 늘리는 실험에서는 USER_TS_QUOTAS의 사용량을 확인한 뒤 조정합니다.
인덱스 존재보다 실제 작업량을 봅니다. 이번처럼 조건에 맞는 복합 인덱스가 있어도 Full Table Scan이 선택될 수 있습니다. 실행계획의 이름만으로 판단하지 말고 E-Rows와 A-Rows의 차이, Buffers, 반복 실행 결과를 함께 확인합니다.
합성 데이터의 한계를 기록합니다. 이번 데이터는 고객별 상태가 하나로 고정되고, 상태가 테이블 전체에 균등하게 흩어지는 구조입니다. 이 결과를 실제 주문 테이블에 그대로 일반화하지 않고, 검증할 현상에 맞는 분포를 따로 구성합니다.
9. 테스트 데이터 재구성과 정리
같은 테이블에 데이터를 다시 적재하려면 기존 데이터를 비웁니다. TRUNCATE는 롤백할 수 없으므로 재구성할 때만 실행합니다.
sql
TRUNCATE TABLE ora_lab.lab_orders;이후 데이터 적재 SQL, COMMIT, 통계 수집을 다시 실행합니다. 테이블과 인덱스는 유지되므로 생성문은 반복하지 않습니다.
테스트 객체를 완전히 제거할 때는 다음 명령을 사용합니다. 테이블을 제거하면 종속 인덱스도 함께 제거되고, ORA_LAB 계정은 그대로 남아 다음 실험에 재사용할 수 있습니다.
sql
DROP TABLE ora_lab.lab_orders PURGE;다음 실험에서는 이 기준값(E-Rows 2,831, A-Rows 428, Buffers 1,577, TABLE ACCESS FULL)에서 조건을 하나씩 바꿉니다. 먼저 order_status에 히스토그램을 수집했을 때 E-Rows가 실제값에 가까워지는지 확인합니다. 그다음 인덱스의 CLUSTERING_FACTOR를 조회해, 추정이 정확해진 뒤에도 Full Table Scan이 유지되는지 비교할 계획입니다.

댓글 0
첫 댓글을 남겨보세요.